
机器学习框架ML.NET学习笔记【4】多元分类之手写数字识别
一、问题与解决方案
通过多元分类算法进行手写数字识别,手写数字的图片分辨率为8*8的灰度图片、已经预先进行过处理,读取了各像素点的灰度值,并进行了标记。
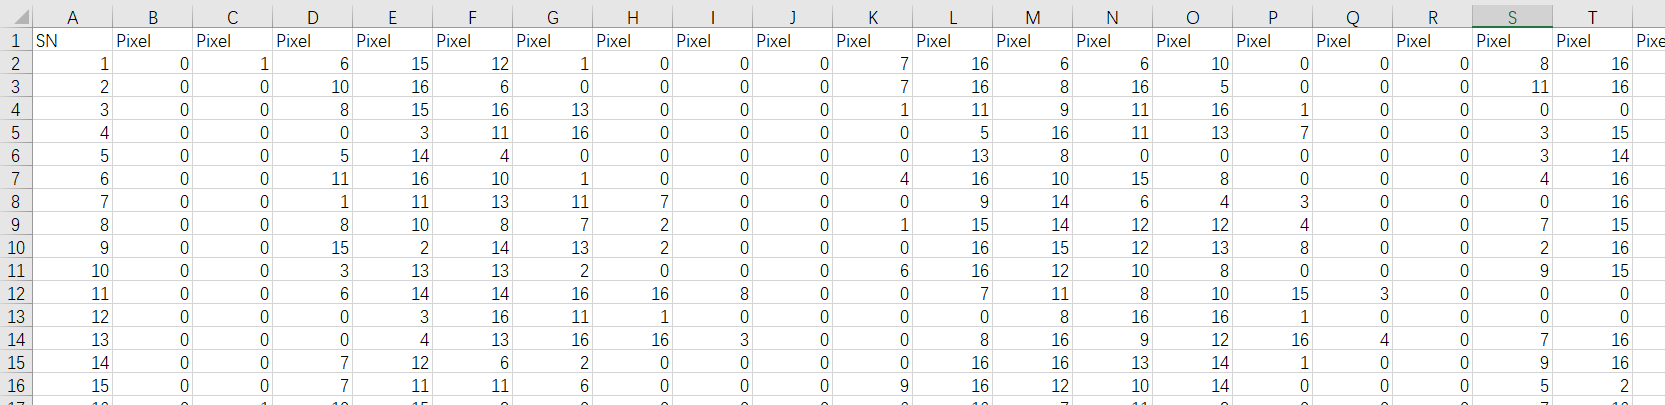
其中第0列是序号(不参与运算)、1-64列是像素值、65列是结果。
我们以64位像素值为特征进行多元分类,算法采用SDCA最大熵分类算法。
二、源码
先贴出全部代码:
namespace MulticlassClassification_Mnist

{

    class Program

    {

        static readonly string TrainDataPath = Path.Combine(Environment.CurrentDirectory, "Data", "optdigits-full.csv");

        static readonly string ModelPath = Path.Combine(Environment.CurrentDirectory, "Data", "SDCA-Model.zip");

        static void Main(string[] args)

        {

            MLContext mlContext = new MLContext(seed: );

            TrainAndSaveModel(mlContext);

            TestSomePredictions(mlContext);

            Console.WriteLine("Hit any key to finish the app");

            Console.ReadKey();

        }

        public static void TrainAndSaveModel(MLContext mlContext)

        {

            // STEP 1: 准备数据

            var fulldata = mlContext.Data.LoadFromTextFile(path: TrainDataPath,

                    columns: new[]

                    {

                        new TextLoader.Column("Serial", DataKind.Single, ),

                        new TextLoader.Column("PixelValues", DataKind.Single, , ),

                        new TextLoader.Column("Number", DataKind.Single, )

                    },

                    hasHeader: true,

                    separatorChar: ','

                    );

            var trainTestData = mlContext.Data.TrainTestSplit(fulldata, testFraction: 0.2);

            var trainData = trainTestData.TrainSet;

            var testData = trainTestData.TestSet;

            // STEP 2: 配置数据处理管道

            var dataProcessPipeline = mlContext.Transforms.Conversion.MapValueToKey("Label", "Number", keyOrdinality: ValueToKeyMappingEstimator.KeyOrdinality.ByValue);

            // STEP 3: 配置训练算法

            var trainer = mlContext.MulticlassClassification.Trainers.SdcaMaximumEntropy(labelColumnName: "Label", featureColumnName: "PixelValues");

            var trainingPipeline = dataProcessPipeline.Append(trainer)

              .Append(mlContext.Transforms.Conversion.MapKeyToValue("Number", "Label"));

            // STEP 4: 训练模型使其与数据集拟合

            Console.WriteLine("=============== Train the model fitting to the DataSet ===============");

            ITransformer trainedModel = trainingPipeline.Fit(trainData);

            // STEP 5:评估模型的准确性

            Console.WriteLine("===== Evaluating Model's accuracy with Test data =====");

            var predictions = trainedModel.Transform(testData);

            var metrics = mlContext.MulticlassClassification.Evaluate(data: predictions, labelColumnName: "Number", scoreColumnName: "Score");

            PrintMultiClassClassificationMetrics(trainer.ToString(), metrics);

            // STEP 6:保存模型

            mlContext.ComponentCatalog.RegisterAssembly(typeof(DebugConversion).Assembly);

            mlContext.Model.Save(trainedModel, trainData.Schema, ModelPath);

            Console.WriteLine("The model is saved to {0}", ModelPath);

        }

        private static void TestSomePredictions(MLContext mlContext)

        {

            // Load Model

            ITransformer trainedModel = mlContext.Model.Load(ModelPath, out var modelInputSchema);

            // Create prediction engine

            var predEngine = mlContext.Model.CreatePredictionEngine<InputData, OutPutData>(trainedModel);

            //num 1

            InputData MNIST1 = new InputData()

            {

                PixelValues = new float[] { , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , , ,  }

            };

            var resultprediction1 = predEngine.Predict(MNIST1);

            resultprediction1.PrintToConsole();

        }

    }

    class InputData

    {

        public float Serial;

        [VectorType()]

        public float[] PixelValues;

        public float Number;

    }

    class OutPutData : InputData

    {

        public float[] Score;

    }

}
三、分析
整体流程和二元分类没有什么区别,下面解释一下有差异的两个地方。
1、加载数据
      // STEP 1: 准备数据

            var fulldata = mlContext.Data.LoadFromTextFile(path: TrainDataPath,

                    columns: new[]

                    {

                        new TextLoader.Column("Serial", DataKind.Single, ),

                        new TextLoader.Column("PixelValues", DataKind.Single, , ),

                        new TextLoader.Column("Number", DataKind.Single, )

                    },

                    hasHeader: true,

                    separatorChar: ','

                    );
这次我们不是通过实体对象来加载数据,而是通过列信息来进行加载,其中PixelValues是特征值,Number是标签值。
2、训练通道
            // STEP 2: 配置数据处理管道

            var dataProcessPipeline = mlContext.Transforms.Conversion.MapValueToKey("Label", "Number", keyOrdinality: ValueToKeyMappingEstimator.KeyOrdinality.ByValue)

            // STEP 3: 配置训练算法

            var trainer = mlContext.MulticlassClassification.Trainers.SdcaMaximumEntropy(labelColumnName: "Label", featureColumnName: "PixelValues");
            var trainingPipeline = dataProcessPipeline.Append(trainer)
                 .Append(mlContext.Transforms.Conversion.MapKeyToValue("Number", "Label"));

            // STEP 4: 训练模型使其与数据集拟合
            ITransformer trainedModel = trainingPipeline.Fit(trainData);
首先通过MapValueToKey方法将Number值转换为Key类型,多元分类算法要求标签值必须是这种类型(类似枚举类型,二元分类要求标签为BOOL类型)。关于这个转换的原因及编码方式,下面详细介绍。
四、键值类型编码与独热编码
MapValueToKey功能是将(字符串)值类型转换为KeyTpye类型。
有时候某些输入字段用来表示类型(类别特征),但本身并没有特别的含义,比如编号、电话号码、行政区域名称或编码等,这里需要把这些类型转换为1到一个整数如1-300来进行重新编号。
举个简单的例子,我们进行图片识别的时候,目标结果可能是“猫咪”、“小狗”、“人物”这些分类,需要把这些分类转换为1、2、3这样的整数。但本文的标签值本身就是1、2、3,为什么还要转换呢?因为我们这里的一二三其实不是数学意义上的数字,而是一种标志,可以理解为壹、贰、叁,所以要进行编码。
MapKeyToValue和MapValueToKey相反,它把将键类型转换回其原始值(字符串)。就是说标签是文本格式,在运算前已经被转换为数字枚举类型了,此时预测结果为数字,通过MapKeyToValue将其结果转换为对应文本。
MapValueToKey一般是对标签值进行编码,一般不用于特征值,如果是特征值为字符串类型的,建议采用独热编码。独热编码即 One-Hot 编码,又称一位有效编码,其方法是使用N位状态寄存器来对N个状态进行编码,每个状态都由他独立的寄存器位,并且在任意时候,其中只有一位有效。例如:
自然状态码为:0,1,2,3,4,5
独热编码为:000001,000010,000100,001000,010000,100000
怎么理解这个事情呢?举个例子,假如我们要进行人的身材的分析,但我们希望加入地域特征,比如:“黑龙江”、“山东”、“湖南”、“广东”这种特征,但这种字符串机器学习是不认识的,必须转换为浮点数,刚才提到MapKeyToValue可以把字符串转换为数字,为什么这里要采用独热编码呢?简单来说,假设把地域名称转换为1到10几个数字,在欧氏几何中1到3的欧拉距离和1到9的欧拉距离是不等的,但经过独热编码后,任意两点间的欧拉距离都是相等的,而我们这里的地域特征仅仅是想表达分类关系,彼此之间没有其他逻辑关系,所以应该采用独热编码。
五、进度调试
一般机器算法的数据拟合过程时间都比较长,有时程序跑了两个小时还没结束,也不知道还需要多长时间,着实让人着急,所以及时了解学习进度,是很有必要的。
由于机器学习算法一般都有“递归直到收敛”这种操作,所以我们是没有办法预先知道最终运算次数的,能做到的只能打印一些过程信息,看到程序在动,心里也有点底,当系统跑过一次之后,基本就大致知道需要多少次拟合了,后面再调试就可以大致了解进度了。补充一句,可不可以在测试阶段先减少样本数据进行快速调试,调试通过后再切换到全样本进行训练?其实不行,有时候样本数量小,可能会引起指标震荡,时间反而长了。
之前在Githube上看到有人通过MLContext.LOG事件来打印调试信息,我试了一下,发现没法控制筛选内容,不太方便,后来想到一个方法,就是新增一个自定义数据处理通道,这个通道不做具体事情,就打印调试信息。
类定义:
namespace MulticlassClassification_Mnist

{

    public class DebugConversionInput

    {

        public float Serial { get; set; }

    }

    public class DebugConversionOutput

    {

        public float DebugFeature { get; set; }

    }

    [CustomMappingFactoryAttribute("DebugConversionAction")]

    public class DebugConversion : CustomMappingFactory<DebugConversionInput, DebugConversionOutput>

    {       static long TotalCount = ;

        public void CustomAction(DebugConversionInput input, DebugConversionOutput output)

        {

            output.DebugFeature = 1.0f;
            TotalCount++;

            Console.WriteLine($"DebugConversion.CustomAction's debug info.TotalCount={TotalCount} ");

        }

        public override Action<DebugConversionInput, DebugConversionOutput> GetMapping()

              => CustomAction;

    }

}
使用方法:
 var dataProcessPipeline = mlContext.Transforms.CustomMapping(new DebugConversion().GetMapping(), contractName: "DebugConversionAction")

       .Append(...)

       .Append(mlContext.Transforms.Concatenate("Features", new string[] { "RealFeatures", "DebugFeature" }));
通过CustomMapping加载我们自定义的数据处理通道,由于数据集是懒加载(Lazy)的,所以必须把我们自定义数据处理通道的输出加入为特征值,才能参与运算,然后算法在操作每一条数据时都会调用到CustomAction方法,这样就可以打印进度信息了。为了不影响运算结果,我们把这个数据处理通道的输出值固定为1.0f 。
六、资源获取
源码下载地址:https://github.com/seabluescn/Study_ML.NET
工程名称:MulticlassClassification_Mnist
机器学习框架ML.NET学习笔记【4】多元分类之手写数字识别的更多相关文章
- 机器学习框架ML.NET学习笔记【5】多元分类之手写数字识别(续)
一.概述 上一篇文章我们利用ML.NET的多元分类算法实现了一个手写数字识别的例子,这个例子存在一个问题,就是输入的数据是预处理过的,很不直观,这次我们要直接通过图片来进行学习和判断.思路很简单,就是 ...
- 机器学习框架ML.NET学习笔记【6】TensorFlow图片分类
一.概述 通过之前两篇文章的学习,我们应该已经了解了多元分类的工作原理,图片的分类其流程和之前完全一致,其中最核心的问题就是特征的提取,只要完成特征提取,分类算法就很好处理了,具体流程如下: 之前介绍 ...
- 机器学习框架ML.NET学习笔记【7】人物图片颜值判断
一.概述 这次要解决的问题是输入一张照片,输出人物的颜值数据. 学习样本来源于华南理工大学发布的SCUT-FBP5500数据集,数据集包括 5500 人,每人按颜值魅力打分,分值在 1 到 5 分之间 ...
- 机器学习框架ML.NET学习笔记【3】文本特征分析
一.要解决的问题 问题:常常一些单位或组织召开会议时需要录入会议记录,我们需要通过机器学习对用户输入的文本内容进行自动评判,合格或不合格.(同样的问题还类似垃圾短信检测.工作日志质量分析等.) 处理思 ...
- 机器学习框架ML.NET学习笔记【2】入门之二元分类
一.准备样本 接上一篇文章提到的问题:根据一个人的身高.体重来判断一个人的身材是否很好.但我手上没有样本数据,只能伪造一批数据了,伪造的数据比较标准,用来学习还是蛮合适的. 下面是我用来伪造数据的代码 ...
- 机器学习框架ML.NET学习笔记【1】基本概念与系列文章目录
一.序言 微软的机器学习框架于2018年5月出了0.1版本,2019年5月发布1.0版本.期间各版本之间差异(包括命名空间.方法等)还是比较大的,随着1.0版发布,应该是趋于稳定了.之前在园子里也看到 ...
- 机器学习框架ML.NET学习笔记【8】目标检测(采用YOLO2模型)
一.概述 本篇文章介绍通过YOLO模型进行目标识别的应用,原始代码来源于:https://github.com/dotnet/machinelearning-samples 实现的功能是输入一张图片, ...
- 机器学习框架ML.NET学习笔记【9】自动学习
一.概述 本篇我们首先通过回归算法实现一个葡萄酒品质预测的程序,然后通过AutoML的方法再重新实现,通过对比两种实现方式来学习AutoML的应用. 首先数据集来自于竞赛网站kaggle.com的UC ...
- 深度学习面试题12:LeNet(手写数字识别)
目录 神经网络的卷积.池化.拉伸 LeNet网络结构 LeNet在MNIST数据集上应用 参考资料 LeNet是卷积神经网络的祖师爷LeCun在1998年提出,用于解决手写数字识别的视觉任务.自那时起 ...
随机推荐
- HDOJ1238(string)
Substrings Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 65536/32768 K (Java/Others)Total ...
- PowerDesigner生成CDM模型
一.新建概念数据模型 1)选择File-->New,弹出如图所示对话框,选择CDM模型(即概念数据模型)建立模型. 2)完成概念数据模型的创建.以下图示,对当前的工作空间进行简单介绍.(以后再 ...
- ES6之箭头函数中的this
在讲箭头函数中的this之前我们先介绍一下普通函数中的this. 普通函数中的this: (1)this指向它的直接调用者 (2)默认的,非严格模式下,没找到直接调用者则指向window ( ...
- [#413c] Fountains
http://codeforces.com/contest/799/problem/C 解题关键:树状数组取最大值,注意先搜索,后加入,此种情况可以取出最大值. 为什么可以取到最大值? 1.当分别用两 ...
- Git 客户端在 WebIDE 中的实现
Coding WebIDE 是 Coding.net 自主研发的在线集成开发环境 (IDE).你可以通过 WebIDE 创建项目的工作空间, 进行在线开发, 调试等操作,有功能健全的 Terminal ...
- 3. Shodan新手入坑指南
什么是 Shodan? 首先,Shodan 是一个搜索引擎,但它与 Google 这种搜索网址的搜索引擎不同,Shodan 是用来搜索网络空间中在线设备的,你可以通过 Shodan 搜索指定的设备,或 ...
- 1. csrf 简介
浅谈CSRF CSRF是什么? (Cross Site Request Forgery, 跨站域请求伪造)是一种网络的攻击方式,它在 年曾被列为互联网 大安全隐患之一,也被称为“One Click A ...
- Java基础 -- 泛型之泛型参数
泛型机制常用的参数有3个: “?”代表任意类型.如果只指定了<?>,而没有extends,则默认是允许任意类. extends关键字声明了类型的上界,表示参数化的类型可能是所指定的类型,或 ...
- matlab基本语法和运算基础
转载自:http://blog.csdn.net/robertcalm/article/details/51582253 matlab语法比较随意,但正如其全名 matrix &laborat ...
- win7 失去焦点解决方案
将HKEY_CURRENT_USER\Control Panel\Desktop中的ForegroundLockTimeout的选项,改成十进制的200000毫秒或者十六进制30d40. 参考链接: ...