
Caffe系列4——基于Caffe的MNIST数据集训练与测试(手把手教你使用Lenet识别手写字体)
基于Caffe的MNIST数据集训练与测试
原创:转载请注明https://www.cnblogs.com/xiaoboge/p/10688926.html
摘要
在前面的博文中,我详细介绍了Caffe的网络结构和求解文件,还介绍了如何制作LMDB和Hdf5数据源文件。但是我们还没有完整的介绍过如何在Caffe框架下去训练一个神经网络模型,在本篇博文中我将从最经典、简单的卷积神经网络Lenet(CNN的开端)和最简单的数据集MNIST(手写数字)出发,详细介绍整个网络的训练与测试过程。
1. 项目文件目录介绍
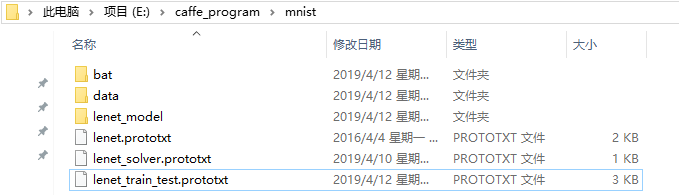
首先还是要先介绍一下我的文件目录,我在目录E:\caffe_program下面创建了一个mnist文件夹,mnist文件夹下面包括了所有训练模型的必要文件,还要保存训练之后的模型。请看mnist文件夹下的文件结构:
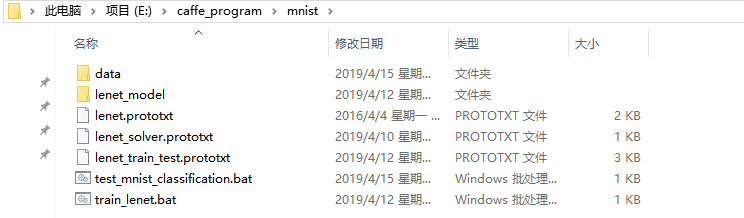
其中,data文件夹下包括了制作数据集的所有文件,还包括制作出来的LMDB格式的数据文件;Lenet_model将用于存储训练过的模型文件;剩下的分别是网络结构、求解文件以及训练网络的bat文件。
2. MNIST数据集介绍与下载
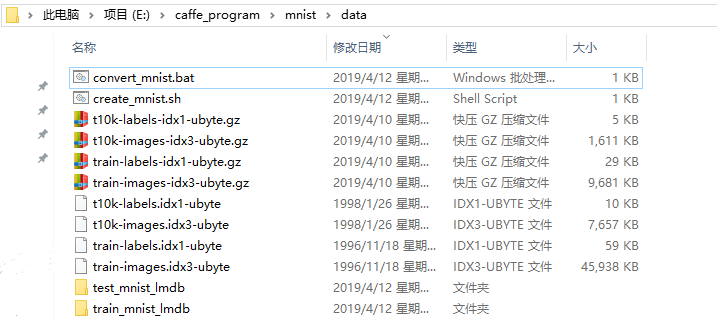
MNIST是一个手写数字数据库,由Google实验室的Corinna Cortes和纽约大学柯朗研究院的Yann LeCun等人建立。MNIST最初用于支票上的手写数字识别, 现在成了Deep Learning入门练习库(相当于编程的“hello world”)。针对MNIST识别的专门模型是Lenet,算是最早的CNN模型了。MNIST数据训练样本为60000张,测试样本为10000张,每个样本为28*28大小的黑白图片,手写数字为0-9,因此分为10类。MNIST数据库官方网址为:http://yann.lecun.com/exdb/mnist/ 。可直接下载四个解压文件,分别对应:训练集样本、训练集标签、测试集样本和测试集标签。下载及解压之后的文件如下(E:\caffe_program\mnist\data):
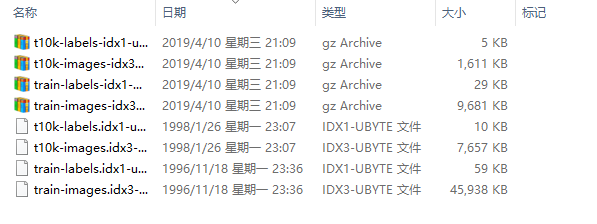
注意:这里也可以使用Caffe自带的get_mnist.sh运行得到解压的数据集(我的运行报错,显示缺少wget),但是我这里是自己去官网下载的,效果是一样的。
3. 将MNIST数据集制作成LMDB格式数据源
Caffe支持的数据格式有:LMDB、Leveldb、Hdf5、原始图像等。虽然LMDB的内存消耗是Leveldb的1.1倍,但是LMDB的速度比Leveldb快10%至15%,更重要的是LMDB允许多种训练模型同时读取同一组数据集。因此LMDB成为了Caffe的默认数据集格式。接下来我也将使用LMDB的数据格式进行手写字识别网络的训练与测试。
在编译好的Caffe中存在将MNIST数据集转换为LMDB的create_mnist.sh脚本文件,它的具体位置在D:\你的安装目录\caffe\caffe-windows\examples\mnist。我将其复制到我的项目之下(最好不要在原文件上修改),即放在我的data文件夹之下,具体路径是E:\caffe_program\mnist\data,文件目录如下:
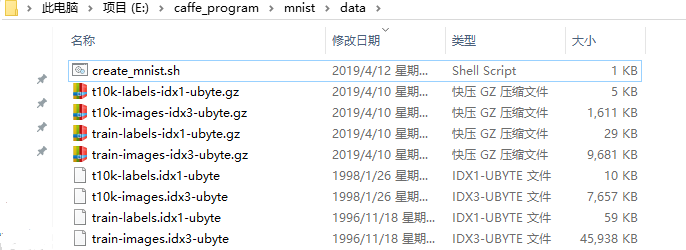
接下来,我们将对create_mnist.sh脚本文件进行修改,修改后的脚本文件如下所示:
 #!/usr/bin/env sh

 # This script converts the mnist data into lmdb/leveldb format,

 # depending on the value assigned to $BACKEND.

 set -e

 EXAMPLE=E:/caffe_program/mnist/data                #生成的LMDB格式数据的存储路径

 DATA=E:/caffe_program/mnist/data                   #原始的MNIST数据集的存储路径

 BUILD=D:/caffe/caffe-windows/Build/x64/Release     #编译好的caffe,主要是“convert_mnist_data.exe”的路径


 BACKEND="lmdb"

 echo "Creating ${BACKEND}..."

 rm -rf $EXAMPLE/mnist_train_${BACKEND}

 rm -rf $EXAMPLE/mnist_test_${BACKEND}

 $BUILD/convert_mnist_data.exe $DATA/train-images.idx3-ubyte \

   $DATA/train-labels.idx1-ubyte $EXAMPLE/mnist_train_${BACKEND} --backend=${BACKEND}

 $BUILD/convert_mnist_data.exe $DATA/t10k-images.idx3-ubyte \

   $DATA/t10k-labels.idx1-ubyte $EXAMPLE/mnist_test_${BACKEND} --backend=${BACKEND}

 echo "Done."

 read   #表示等待输入,即暂停
从上述修改后的create_mnist.sh脚本文件可知,我们不仅对数据路径进行了修改,还将“convert_mnist_data.bin”修改为“convert_mnist_data.exe”(Windows系统下可执行文件是exe格式),将“train-images.idx3-ubyte”修改为“train-images.idx3-ubyte”(如果使用get_mnist.sh下载解压文件则不存在这个问题)因为下载的文件解压后数据的名称和脚本文件中名字不同。我在这里使用的是将脚本文件中的名字修改为和解压产生的文件的名称一致。
运行create_mnist.sh脚本文件(在Windows系统下,必须安装Git),将在data文件夹下产生训练集和测试集的LMDB格式的数据,目录结构展示如下:
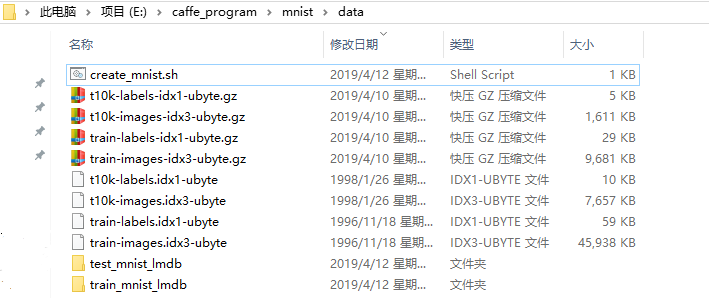
至此,我们已经成功制作出了我们自己的MNIST的LMDB格式的数据集和测试集啦!
如果我们电脑上没有安装Git(也就是说在Windows系统下不能直接打开create_mnist.sh脚本文件),我们如何制作LMDB格式数据呢?
当我们的Windows系统没有安装Git时,其实也可以制作LMDB格式的数据集。首先我们需要知道create_mnist.sh脚本文件到底执行了什么操作,它其实就是通过修改数据的路径和数据的名称执行“convert_mnist_data.exe”可执行程序,生成了MNIST的LMDB格式数据集。既然脚本文件是执行可执行程序,那我们可以使用Windows系统下的批处理命令来代替这一操作。因此,我们可以在data文件夹下创建一个文本文件,然后将其修改为“convert_mnist.bat”,写入批处理命令,执行就可以得到LMDB数据集。批处理命令具体显示如下:
 echo "create mnist_train_lmdb"

 D:\caffe\caffe-windows\Build\x64\Release\convert_mnist_data.exe ^

 E:\caffe_program\mnist\data\train-images.idx3-ubyte ^

 E:\caffe_program\mnist\data\train-labels.idx1-ubyte ^

 E:\caffe_program\mnist\data\train_mnist_lmdb

 echo "create mnist_train_lmdb"

 D:\caffe\caffe-windows\Build\x64\Release\convert_mnist_data.exe ^

 E:\caffe_program\mnist\data\t10k-images.idx3-ubyte ^

 E:\caffe_program\mnist\data\t10k-labels.idx1-ubyte ^

 E:\caffe_program\mnist\data\test_mnist_lmdb

 pause
在windows系统先双击执行完这个bat文件之后,在data文件夹下生成和之前一样的LMDB格式数据,最后的目录结构如下:
4. Caffe框架下的模型训练与测试
上面的一系列操作,使得我们获得了MNIST数据集的LMDB的数据格式,接下来将会是真正去对模型进行训练与测试。我还是将整个过程分为几个步骤,一步一步的去做,才会使得思路更加清晰,自己对Caffe框架下训练和测试模型理解的更加透彻,废话不多说,一起开始吧!
(1)修改网络模型的描述文件
网络模型的描述文件:“lenet_train_test.prototxt”,顾名思义,就是网络的结构。它主要定义了模型的名称、网络架构、训练和测试集的路径等。在这里我们需要去修改的其实就是训练集和测试集的路径。我将网络模型文件放在了mnist文件夹下,即E:\caffe_program\mnist,具体的目录结构如下:
下面我将修改后的模型描述文件展示如下:
 name: "LeNet"

 layer {

   name: "mnist"

   type: "Data"

   top: "data"

   top: "label"

   include {

     phase: TRAIN

   }

   transform_param {

     scale: 0.00390625

   }

   data_param {

     source: "E:/caffe_program/mnist/data/train_mnist_lmdb"              #制作的LMDB格式的训练数据的路径

     batch_size:

     backend: LMDB

   }

 }

 layer {

   name: "mnist"

   type: "Data"

   top: "data"

   top: "label"

   include {

     phase: TEST

   }

   transform_param {

     scale: 0.00390625

   }

   data_param {

     source: "E:/caffe_program/mnist/data/test_mnist_lmdb"        #制作的LMDB格式的测试数据的路径

     batch_size:

     backend: LMDB

   }

 }
(2)修改求解(超参数)文件
对于超参数文件来说,它的内容就是一些网络学习训练的超参数,像基础学习率、测试间隔、权重衰减率、动量、学习率策略、最大迭代步长等等。当然还包含了我们所要训练的网络结构描述文件的路径,还有训练之后模型的保存路径(在mnist文件夹下创建了子文件夹lenet_model)。修改后的超参数文件“lenet_solver.prototxt”详细如下所示:
# The train/test net protocol buffer definition

net: "E:/caffe_program/mnist/lenet_train_test.prototxt"                   #我们要训练的网络结构描述文件的路径

# test_iter specifies how many forward passes the test should carry out.

# In the case of MNIST, we have test batch size  and  test iterations,

# covering the full , testing images.

test_iter:

# Carry out testing every  training iterations.

test_interval:

# The base learning rate, momentum and the weight decay of the network.

base_lr: 0.01

momentum: 0.9

weight_decay: 0.0005

# The learning rate policy

lr_policy: "inv"

gamma: 0.0001

power: 0.75

# Display every  iterations

display:

# The maximum number of iterations

max_iter:

# snapshot intermediate results

snapshot: 2000        #它表示每2000步迭代,进行一次模型输出保存

snapshot_prefix: "E:/caffe_program/mnist/lenet_model/lenet"     #这里表示的输出模型的保存路径

# solver mode: CPU or GPU

solver_mode: CPU             #模型的训练求解方式只采用CPU
(3)开始训练模型
当我们把网络模型描述文件和超参数文件都修改完毕之后,训练模型将变得非常简单。首选,在mnist文件夹下创建一个文本文件,然后将其修改为“train_lenet.bat”,下面展示详细的bat批处理命令的细节:
D:\caffe\caffe-windows\Build\x64\Release\caffe.exe train ^

--solver=E:/caffe_program/mnist/lenet_solver.prototxt

pause
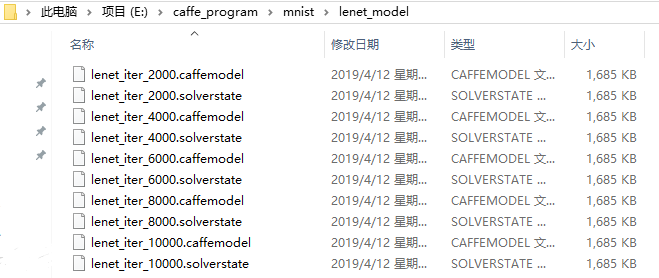
双击运行上述的bat文件,开始训练网络模型(大概要几十分钟,根据电脑而定),可以在lenet_model文件夹下保存了5个训练好的模型,生成的模型详细如下:
(4)生成均值文件备用(训练数据)
首选,我们在data文件夹下创建一个文本文件,并将其修改为“generate_mean.bat”,然后写入批处理命令就可以生成训练数据的均值文件,批处理命令如下:
 D:\caffe\caffe-windows\Build\x64\Release\compute_image_mean.exe ^

 E:\caffe_program\mnist\data\test_mnist_lmdb ^

 E:\caffe_program\mnist\data\mean.binaryproto

 pause
最终,可以在data文件夹下生成均值文件“mean.binaryproto”,留着均值文件备用。
(5)准备标签
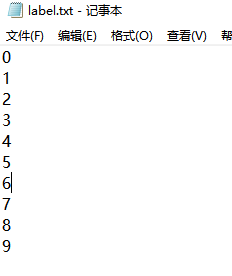
因为这里是训练测试MNIST数据集,因此标签label就是0-9,我在data文件夹下创建标签文件“label.txt”,详细展示如下:
(6)测试模型的训练效果
在mnist文件夹下创建一个文本文件,然后将其修改为“test_mnist_classification.bat”,写入批处理命令,运行即可在中端中显示top5的预测结果。需要预测的数据放在data/0-9/文件夹下面,0-9文件夹详细内容如下:

下面详细展示批处理的命令:
 D:\caffe\caffe-windows\Build\x64\Release\classification.exe ^

 E:\caffe_program\mnist\lenet.prototxt ^

 E:\caffe_program\mnist\lenet_model\lenet_iter_10000.caffemodel ^

 E:\caffe_program\mnist\data\mean.binaryproto ^

 E:\caffe_program\mnist\data\label.txt ^

 E:\caffe_program\mnist\data\0-9\9.bmp

 pause
最终的运行结果显示如下:

这就是整个训练lenet模型,以及使用模型识别mnist数据集的详细过程。
5. 总结
整个过程虽然简单,但是有很多细节问题,稍不注意可能训练测试失败。通过这个简单的例子还是学到了很多知识,对Caffe框架的训练与测试过程更加熟悉。之后的学习将会越来越快,后面将会学习使用Python接口更快更方便的调用Caffe实现一系列 的训练测试过程。
原创:转载请注明https://www.cnblogs.com/xiaoboge/p/10688926.html
Caffe系列4——基于Caffe的MNIST数据集训练与测试(手把手教你使用Lenet识别手写字体)的更多相关文章
- Ubuntu14.04+caffe+cuda7.5 环境搭建以及MNIST数据集的训练与测试
Ubuntu14.04+caffe+cuda 环境搭建以及MNIST数据集的训练与测试 一.ubuntu14.04的安装: ubuntu的安装是一件十分简单的事情,这里给出一个参考教程: http:/ ...
- 基于kNN的手写字体识别——《机器学习实战》笔记
看完一节<机器学习实战>,算是踏入ML的大门了吧!这里就详细讲一下一个demo:使用kNN算法实现手写字体的简单识别 kNN 先简单介绍一下kNN,就是所谓的K-近邻算法: [作用原理]: ...
- 从零到一:caffe-windows(CPU)配置与利用mnist数据集训练第一个caffemodel
一.前言 本文会详细地阐述caffe-windows的配置教程.由于博主自己也只是个在校学生,目前也写不了太深入的东西,所以准备从最基础的开始一步步来.个人的计划是分成配置和运行官方教程,利用自己的数 ...
- tensorflow中使用mnist数据集训练全连接神经网络-学习笔记
tensorflow中使用mnist数据集训练全连接神经网络 ——学习曹健老师“人工智能实践:tensorflow笔记”的学习笔记, 感谢曹老师 前期准备:mnist数据集下载,并存入data目录: ...
- 【OpenCV】opencv3.0中的SVM训练 mnist 手写字体识别
前言: SVM(支持向量机)一种训练分类器的学习方法 mnist 是一个手写字体图像数据库,训练样本有60000个,测试样本有10000个 LibSVM 一个常用的SVM框架 OpenCV3.0 中的 ...
- 深度学习-tensorflow学习笔记(2)-MNIST手写字体识别
深度学习-tensorflow学习笔记(2)-MNIST手写字体识别超级详细版 这是tf入门的第一个例子.minst应该是内置的数据集. 前置知识在学习笔记(1)里面讲过了 这里直接上代码 # -*- ...
- 教你如何使用Java手写一个基于链表的队列
在上一篇博客[教你如何使用Java手写一个基于数组的队列]中已经介绍了队列,以及Java语言中对队列的实现,对队列不是很了解的可以我上一篇文章.那么,现在就直接进入主题吧. 这篇博客主要讲解的是如何使 ...
- 深度学习-tensorflow学习笔记(1)-MNIST手写字体识别预备知识
深度学习-tensorflow学习笔记(1)-MNIST手写字体识别预备知识 在tf第一个例子的时候需要很多预备知识. tf基本知识 香农熵 交叉熵代价函数cross-entropy 卷积神经网络 s ...
- 基于 tensorflow 的 mnist 数据集预测
1. tensorflow 基本使用方法 2. mnist 数据集简介与预处理 3. 聚类算法模型 4. 使用卷积神经网络进行特征生成 5. 训练网络模型生成结果 how to install ten ...
随机推荐
- NX二次开发-UFUN高亮显示对象UF_DISP_set_highlight
NX11+VS2013 #include <uf.h> #include <uf_modl.h> #include <uf_disp.h> UF_initializ ...
- NX二次开发-UF_MODL_create_bplane创建有界平面
这里要注意一点,有界平面是body,不是face,以前我刚开始做项目的时候一直以为有界平面是face,后来发现不对.是body NX9+VS2012 #include <uf.h> #in ...
- Core Text 入门
本文所涉及的代码你可以在这里下载到 https://github.com/kejinlu/CTTest,包含两个项目,一个Mac的NSTextView的测试项目,一个iOS的Core Text的测试项 ...
- dict,list强制类型转换
单列集合中如果装的元素都是双列,那么可以通过dict()强制转换为字典 a=[(1,1),(2,2),(3,3)] print(dict(a)) #{1:1,2:2,3:3} b=[1,2,3] pr ...
- RoadFlowCore 解决方案介绍及开发概述
RoadFlow解决方案如下: RoadFlow.Business:业务层 RoadFlow.Integrate:组织机构获取层(如果你系统要使用第三方组织架构的时候修改这里面的方法即可) RoadF ...
- 【python】遇到的错误
呃.这学期在学python啦.之前虽然自学过,但都是跟着教程也没使用什么编译环境.没遇到奇奇怪怪的错误. 现在就当作一个记录贴吧. 用的编译工具是pycharm.电脑是MacBook Air 1.我在 ...
- 针对Java集合类的小总结
Java集合类包位于java.util下,有很多常用的数据结构:数组.链表.队列.栈.哈希表等等.了解不同的集合类的特性在开发过程中是比较重要的,感谢@兰亭风雨的专栏分析,这里我也根据自己的理解做轻度 ...
- Codeforces Round #563 (Div. 2) F. Ehab and the Big Finale
后续: 点分治标程 使用father数组 比使用vis数组优秀(不需要对vis初始化) https://codeforces.com/problemset/problem/1174/F https:/ ...
- Vim模糊查找与替换
例如要把 ( 1 ).( 2 ) - 全部替换成其他字符,可以用命令: :%s/(.*)/str/gn 其中,.* 表示匹配任何东西,如果只希望匹配应为字母和数字,可以用 \w\+. 有些特殊字符需要 ...
- 【BZOJ2298】【luoguP2519】problem a
description 一次考试共有n个人参加,第i个人说:"有ai个人分数比我高,bi个人分数比我低."问最少有几个人没有说真话(可能有相同的分数) analysis 这题转化模 ...