
Scrapy模拟登录赶集网
1.打开赶集网登录界面,先模拟登录并抓包,获得post请求的request参数
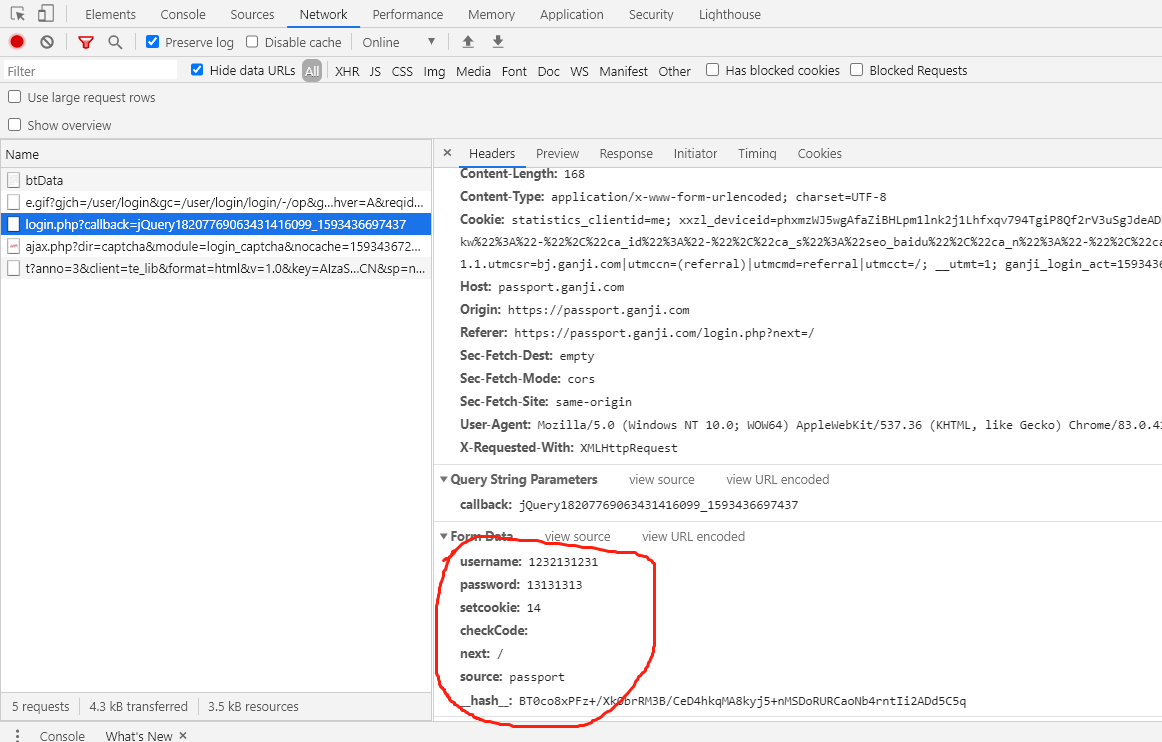
2. 我们只需构造出上面的参数传入formdata即可
参数分析:
setcookie:为自动登录所传的值,不勾选时默认为0。
__hash__值的分析:只需要查看response网页源代码即可 ,然后用正则表达式提取。
3.代码实现
1.workon到自己的虚拟环境 cmd切换到项目目录,输入scrapy startproject ganjiwangdenglu,然后就可以用pycharm打开该目录啦。
2.在pycharm terminal中输入scrapy ganji ganjicom 创建地址,如下为项目目录
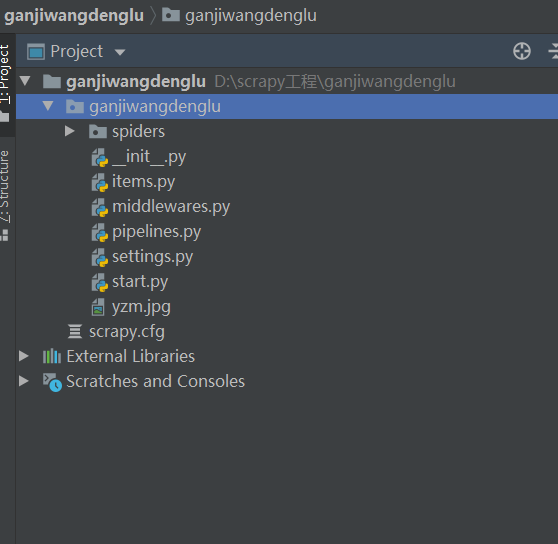
3. 代码详情
import scrapy

import re

class GanjiSpider(scrapy.Spider):

    name = 'ganji'

    allowed_domains = ['ganji.com']

    start_urls = ['https://passport.ganji.com/login.php']

    def parse(self, response):

        hash_code = re.search(r'"__hash__":"(.+)"}', response.text).group(1)  # 正则获取哈希

        img_url = 'https://passport.ganji.com/ajax.php?dir=captcha&module=login_captcha'  # 验证码url

        yield scrapy.Request(img_url, callback=self.do_formdata, meta={'hash_code': hash_code})  # 发送获取验证码请求并保存验证码到本地

    def do_formdata(self, response):

        with open('yzm.jpg', 'wb') as f:

            f.write(response.body)

            # 验证码三种方案:1,保存下来手动输入,2,云打码,3 tesseract模块,在这里我们手动输入

        code = input('请输入验证码:')

        # 创建表单

        formdata = {

            'username': 'your_username',

            'password': 'your_password',

            'setcookie': '',

            'checkCode': code,

            'next': '',

            'source': 'passport',

            '__hash__': response.request.meta['hash_code']  # meta是在respose.request中

        }

        login_url = "https://passport.ganji.com/login.php"

        yield scrapy.FormRequest(url=login_url, formdata=formdata, callback=self.after_login)  # 发送登录请求

    def after_login(self, response):

        print(response.text)
4.终端输入scrapy carwl ganji 即可大功告成 。
返回来的json字符串解析如下:
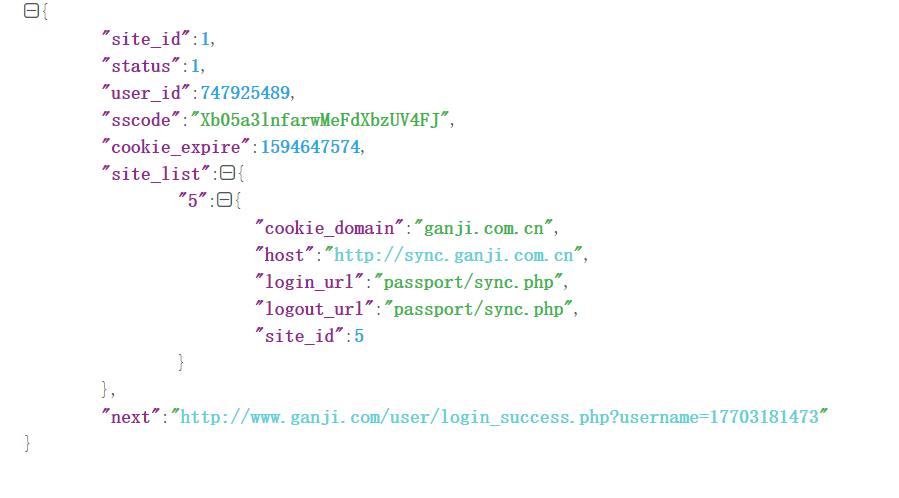
注:setting中的设置不在赘述。
Scrapy模拟登录赶集网的更多相关文章
- scrapy模拟登录微博
http://blog.csdn.net/pipisorry/article/details/47008981 这篇文章是介绍使用scrapy模拟登录微博,并爬取微博相关内容.关于登录流程为嘛如此设置 ...
- 使用scrapy框架做赶集网爬虫
使用scrapy框架做赶集网爬虫 一.安装 首先scrapy的安装之前需要安装这个模块:wheel.lxml.Twisted.pywin32,最后在安装scrapy pip install wheel ...
- 利用scrapy模拟登录知乎
闲来无事,写一个模拟登录知乎的小demo. 分析网页发现:登录需要的手机号,密码,_xsrf参数,验证码 实现思路: 1.获取验证码 2.获取_xsrf 参数 3.携带参数,请求登录 验证码url : ...
- urllib库利用cookie实现模拟登录慕课网
思路 1.首先在网页中使用账户和密码名登录慕课网 2.其次再分析请求头,如下图所示,获取到请求URL,并提取出cookie信息,保存到本地 3.最后在代码中构造请求头,使用urllib.request ...
- Scrapy模拟登录信息
携带cookie模拟登录 需要在爬虫里面自定义一个start_requests()的函数 里面的内容: def start_requests(self): cookies = '真实有效的cookie ...
- scrapy模拟登录
对于scrapy来说,也是有两个方法模拟登陆: 直接携带cookie 找到发送post请求的url地址,带上信息,发送请求 scrapy模拟登陆之携带cookie 应用场景: cookie过期时间很长 ...
- python爬虫之scrapy模拟登录
背景: 初来乍到的pythoner,刚开始的时候觉得所有的网站无非就是分析HTML.json数据,但是忽略了很多的一个问题,有很多的网站为了反爬虫,除了需要高可用代理IP地址池外,还需要登录.例如知乎 ...
- 【Java】模拟登录教务网并获取数据
本文章仅做技术交流演示学习,请勿用于违法操作! 前期准备 首先我们需要到要模拟登录的网页,进行抓包操作. 使用Chrome浏览器打开系统的登录页面,按F12打开开发者工具 切换到Network选项卡 ...
- scrapy 基础组件专题(十二):scrapy 模拟登录
1. scrapy有三种方法模拟登陆 1.1直接携带cookies 1.2找url地址,发送post请求存储cookie 1.3找到对应的form表单,自动解析input标签,自动解析post请求的u ...
随机推荐
- 用Java模拟游戏重力的实现(弹跳)
年末开了Java实训大作业 想了好几天决定选择马里奥小游戏 发现即使做出来但是跳跃功能是很“笨拙”的,和我们玩的游戏不一样,没有跳跃速度的快慢什么的,后来才知道这个叫做游戏里面重力的模拟. 组队做系统 ...
- Matplotlib 的正确使用方法,画一张好看的图
前言 本文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者:Python中文社区 本文用的数据如图所示,Dataframe中显示 ...
- Nice Jquery Validator 事件
订阅 .on("validation") 描述:每次验证完一个字段,都会触发 validation 事件,通过该事件可以获取到当前验证字段的验证结果. 示例: $('#form') ...
- FFT快速傅里叶变换的python实现
FFT是DFT的高效算法,能够将时域信号转化到频域上,下面记录下一段用python实现的FFT代码. # encoding=utf-8 import numpy as np import pylab ...
- 一篇看懂Docker
松勤教育2020.4.20 我要分享 Docker 是什么? Docker 属于 Linux 容器的一种封装,提供简单易用的容器使用接口.它是目前最流行的 Linux 容器解决方案. Dock ...
- UWP实现第二字幕并且跟随系统的设置
话不多说,先看一下最终效果 系统设置默认 在系统设置里面更改字幕的显示效果 需求 要求播放器可以显示第二字幕,类似旁白的文字解释.比如片中出现了一个专业术语,这个时候观众可能有些疑惑.所以需要在屏幕上 ...
- 菜渣开源一个基于 EMIT 的 AOP 库(.NET Core)
目录 1,快速入门 1.1 继承 ActionAttribute 特性 1.2 标记代理类型 2,如何创建代理类型 2.1 通过API直接创建 2,创建代理类型 通过API 通过 Microsoft. ...
- 【Key】 Windows 95 到 Windows10所有KEY 包括OEM系统
部分可能不准确,请见谅,数据源自Baidu,由noogai00整理,数据为Microsoft.所有 Windows 95 02398-OEM-0030022-5886409297-OEM-002128 ...
- 手把手教你使用Python生成图灵智能小伙伴,实现工作助手/闲聊功能
/1 前言/ 在家闲着,做个小项目,基于Python,实现一个语聊小机器人,分享给大家.项目整体比较简单,官方文档介绍的非常详细,可快速上手. /2 目标/ 将图灵机器人放到桌面,实现工作助手/陪聊功 ...
- Java深拷贝和浅拷贝的区别
浅拷贝 被复制的对象的所有的变量都与原对象有相同的值,而所有的引用对象仍然指向原来的对象.换言之,浅拷贝 不复制引用对象. 1 class Experience { 2 private String ...