
sklearn中的pipeline实际应用
前面提到,应用sklearn中的pipeline机制的高效性;本文重点讨论pipeline与网格搜索在机器学习实践中的结合运用:
结合管道和网格搜索以调整预处理步骤以及模型参数
一般地,sklearn中经常用到网格搜索寻找应用模型的超参数;实际上,在训练数据被送入模型之前,对数据的预处理中也会有超参数的介入,比如给数据集添加多项式特征时所指定的指数大小;
而且,一般都是将数据预处理完成后再传入估计器进行拟合,此时利用网格搜索只会单独调整估计器的超参数;如若利用pipeline结合预处理步骤和模型估计器则可以同时寻找最佳的超参数配对。
实例如下:
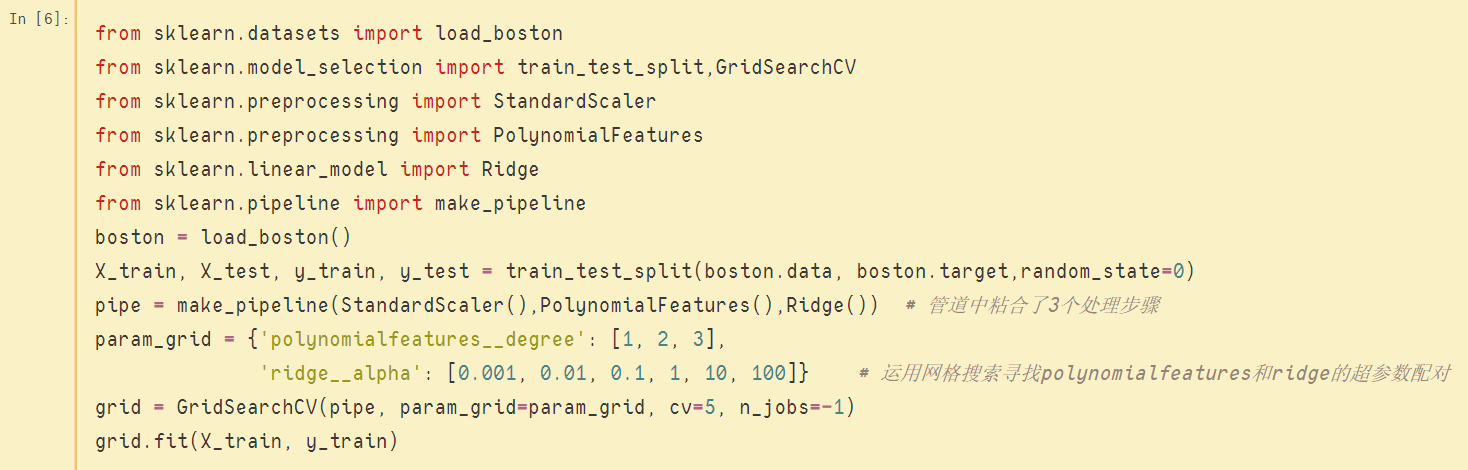
上图中,利用管道结合了3个处理步骤,并使用网格搜索机制针对其中两个步骤的超参数进行调优,一个是预处理阶段的PolynomialFeatures,另一个是模型Ridge
结合管道和网格搜索以选定模型
一般地,选用不同的模型会涉及到不同的预处理步骤,如采用随机森林进行分类训练时可以不对数据作预处理操作,而应用支持向量机时则需要对数据进行标准化;
下图中,利用管道结合预处理中的标准化步骤和分类模型,当模型采用随机森林时,预处理步骤置空,并利用网格搜索寻找随机森林的超参数;当模型采用支持向量机时,启用预处理步骤,并利用网格搜索寻找支持向量机的超参数。
通过此种结合应用,选定最适合的分类模型。

sklearn中的pipeline实际应用的更多相关文章
- sklearn中的Pipeline
在将sklearn中的模型持久化时,使用sklearn.pipeline.Pipeline(steps, memory=None)将各个步骤串联起来可以很方便地保存模型. 例如,首先对数据进行了PCA ...
- sklearn 中的 Pipeline 机制 和FeatureUnion
一.pipeline的用法 pipeline可以用于把多个estimators级联成一个estimator,这么 做的原因是考虑了数据处理过程中一系列前后相继的固定流程,比如feature selec ...
- sklearn 中的 Pipeline 机制
转载自:https://blog.csdn.net/lanchunhui/article/details/50521648 from sklearn.pipeline import Pipeline ...
- sklearn中的pipeline的创建与访问
前期博文提到管道(pipeline)在机器学习实践中的重要性以及必要性,本文则递进一步,探讨实际操作中管道的创建与访问. 已经了解到,管道本质上是一定数量的估计器连接而成的数据处理流,所以成功创建管道 ...
- 【笔记】多项式回归的思想以及在sklearn中使用多项式回归和pipeline
多项式回归以及在sklearn中使用多项式回归和pipeline 多项式回归 线性回归法有一个很大的局限性,就是假设数据背后是存在线性关系的,但是实际上,具有线性关系的数据集是相对来说比较少的,更多时 ...
- sklearn中的交叉验证(Cross-Validation)
这个repo 用来记录一些python技巧.书籍.学习链接等,欢迎stargithub地址sklearn是利用python进行机器学习中一个非常全面和好用的第三方库,用过的都说好.今天主要记录一下sk ...
- sklearn中的投票法
投票法(voting)是集成学习里面针对分类问题的一种结合策略.基本思想是选择所有机器学习算法当中输出最多的那个类. 分类的机器学习算法输出有两种类型:一种是直接输出类标签,另外一种是输出类概率,使用 ...
- (数据科学学习手札25)sklearn中的特征选择相关功能
一.简介 在现实的机器学习任务中,自变量往往数量众多,且类型可能由连续型(continuou)和离散型(discrete)混杂组成,因此出于节约计算成本.精简模型.增强模型的泛化性能等角度考虑,我们常 ...
- sklearn中的多项式回归算法
sklearn中的多项式回归算法 1.多项式回归法多项式回归的思路和线性回归的思路以及优化算法是一致的,它是在线性回归的基础上在原来的数据集维度特征上增加一些另外的多项式特征,使得原始数据集的维度增加 ...
随机推荐
- Java面试题及解析(判断题)
1.代码差错,判断代码对错,并指出错误处 abstract class Name{ private String name; public abstract Boolean isStupidName( ...
- Spark日志,及设置日志输出级别
Spark日志,及设置日志输出级别 1.全局应用设置 2.局部应用设置日志输出级别 3.Spark log4j.properties配置详解与实例(摘录于铭霏的记事本) 文章内容来源: 作者:大葱拌豆 ...
- Spark高级数据分析——纽约出租车轨迹的空间和时间数据分析
Spark高级数据分析--纽约出租车轨迹的空间和时间数据分析 一.地理空间分析: 二.pom.xml 原文地址:https://www.jianshu.com/p/eb6f3e0c09b5 作者:II ...
- jquery each报 Uncaught TypeError: Cannot use 'in' operator to search for错误
用$.each()来遍历后台传过来的json数据.直接遍历传过来的数据时就发生 Uncaught TypeError: Cannot use 'in' operator to search for 这 ...
- mysql:如何利用覆盖索引避免回表优化查询
说到覆盖索引之前,先要了解它的数据结构:B+树. 先建个表演示(为了简单,id按顺序建): id name 1 aa 3 kl 5 op 8 aa 10 kk 11 kl 14 jk 16 ml 17 ...
- HDU 3537 Daizhenyang's Coin 翻硬币博弈
题意: 给你n个硬币,你可以从中拿出来1.2.3个硬币,它们不一定要连续,你只需要保证拿出来的硬币中那个下标最大的硬币一定要是正面朝上,最后谁不能操作,谁就输了 题解: 翻硬币游戏 结论: 局面的SG ...
- Codeforces Round #555 (Div. 3) E. Minimum Array (贪心,二分,set)
题意:给你两个长度为\(n\)的数组\(a\)和\(b\),元素值在\([0,n-1]\),可以对\(b\)数组的元素任意排序,求新数组\(c\),满足\(c_i=(a_i+b_i)\ mod\ n\ ...
- C# 网络加密与解密
数据在网络传输过程中的保密性是网络安全中重点要考虑的问题之一.由于通过网络传递数据是在不安全的信道上进行传输的,因此通信双方要想确保任何可能正在侦听的人无法理解通信的内容,而且希望确保接收方接收的信息 ...
- C#中word导出功能骚操作
马上过牛年了,先祝大家新年好,身体好,心情好!!! 年前最后写一篇之前项目开发的一个功能,自己根据系统业务,想到的一个解决办法,效率还是不错的,废话不多说,开整!!! 需求:企业填报自己的企业信息到系 ...
- K8s Deployment YAML 名词解释
Deployment 简述 Deployment 为 Pod 和 ReplicaSet 提供了一个声明式定义 (declarative) 方法,用来替代以前的 ReplicationControlle ...