
Hadoop集群搭建-01前期准备
整个搭建hadoop集群的流程,包括
- 前期准备
- 安装zookeeper并配置环境
- 编译安装hadoop并启动
- 安装HDFS管理namenode和dataname管理集群硬盘资源
- 安装启动yarn建立MapReduce管理cpu和内存资源
01前期准备:
1.部署环境
- VMware15
- CentOS7
- jdk8
首先启动一台centos7的虚拟机,配置华为云yum源
[root@localhost ~]# cp -a /etc/yum.repos.d/CentOS-Base.repo /etc/yum.repos.d/CentOS-Base.repo.bak

[root@localhost ~]# wget -O /etc/yum.repos.d/CentOS-Base.repo https://repo.huaweicloud.com/repository/conf/CentOS-7-reg.repo

[root@localhost ~]# yum clean all

[root@localhost ~]# yum makecache

[root@localhost ~]# yum update -y
然后安装一些乱七八糟的常用软件
[root@localhost ~]# yum install -y openssh-server vim gcc gcc-c++ glibc-headers bzip2-devel lzo-devel curl wget openssh-clients zlib-devel autoconf automake cmake libtool openssl-devel fuse-devel snappy-devel telnet unzip zip net-tools.x86_64 firewalld systemd
2.关闭虚拟机的防火墙和SELinux设置
[root@localhost ~]# firewall-cmd --state

[root@localhost ~]# systemctl stop firewalld.service

[root@localhost ~]# systemctl disable firewalld.service

[root@localhost ~]# systemctl is-enabled firewalld.service
[root@localhost ~]# /usr/sbin/sestatus -v  查看selinux的状态

[root@localhost ~]# vim /etc/selinux/config

#修改状态为关闭

SELINUX=disabled

[root@localhost ~]# reboot
3.安装jdk8并配置环境变量
下载地址http://www.oracle.com/technetwork/java/javase/downloads/jdk8-downloads-2133151.html
[root@localhost ~]# rpm -ivh jdk-8u144-linux-x64.rpm

[root@localhost ~]# vim /etc/profile

#修改环境变量,在文件末尾添加如下

export JAVA_HOME=/usr/java/jdk1.8.0_144

export JRE_HOME=$JAVA_HOME/jre

export PATH=$PATH:$JAVA_HOME/bin

export CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar
修改后只是对应此次用户此次会话生效,希望永久全局生效,就要
[root@localhost ~]# source /etc/profile
4.安装ntpdate服务,每次虚拟机挂起重新启用后方便同步时间
[root@localhost ~]# yum install -y ntp-tools

[root@localhost ~]# ntpdate ntp1.aliyun.com
5.创建hadoop用户和用户组并加入wheel组
[root@localhost ~]# useradd hadoop

[root@localhost ~]# passwd hadoop
只允许wheel组内用户可以通过su - root命令登录root用户,提高安全性
[root@localhost ~]# sed -i 's/#auth\t\trequired\tpam_wheel.so/auth\t\trequired\tpam_wheel.so/g' '/etc/pam.d/su'

[root@localhost ~]# cp /etc/login.defs /etc/login.defs_bak

[root@localhost ~]# echo "SU_WHEEL_ONLY yes" >> /etc/login.defs
添加hadoop用户进wheel组
[root@localhost ~]# gpasswd -a hadoop wheel

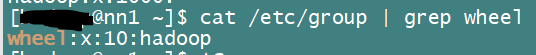
[root@localhost ~]# cat /etc/group | grep wheel     查看hadoop有没有加入到wheel组
6.配置虚拟机的hosts文件
[root@localhost ~]# vim /etc/hosts

192.168.10.3 nn1.hadoop   #这个是本机ip,主机名稍后一起配置

192.168.10.4 nn2.hadoop

192.168.10.5 s1.hadoop

192.168.10.6 s2.hadoop

192.168.10.7 s3.hadoop
7.用虚拟机克隆功能克隆另外4台虚拟机
完成后_分别更改每一台_的主机名并配置静态ip,要求和上面hosts文件内的一致并对应
[root@localhost ~]# hostnamectl set-hostname nn1.hadoop

[root@localhost ~]# vim /etc/sysconfig/network-scripts/ifcfg-ens33

TYPE="Ethernet"

PROXY_METHOD="none"

BROWSER_ONLY="no"

BOOTPROTO="static"      #这里修改为static

IPADDR="192.168.10.3"   #这里添加为你的每台虚拟机对应的ip

NETMASK="255.255.255.0" #添加

GATEWAY="192.168.10.2"  #添加为你虚拟机内的网关

DNS="192.168.10.2"      #添加

NM_CONTROLLED="no"      #添加,必然改完文件自动生效,可能直接网络就挂掉了

DEFROUTE="yes"

IPV4_FAILURE_FATAL="no"

IPV6INIT="yes"

IPV6_AUTOCONF="yes"

IPV6_DEFROUTE="yes"

IPV6_FAILURE_FATAL="no"

IPV6_ADDR_GEN_MODE="stable-privacy"

NAME="ens33"

UUID="49f05112-b80b-45c2-a3ec-d64c76ed2d9b"

DEVICE="ens33"

ONBOOT="yes"
[root@localhost ~]# systemctl stop NetworkManager.service   停止网络管理服务

[root@localhost ~]# systemctl disable NetworkManager.service 开机禁止自启动

[root@localhost ~]# systemctl restart network.service  重启网络服务
至此我们应该有五台虚拟机,都按照如下ip和主机名配置对应好,五台都设置好了hosts文件
192.168.10.3 nn1.hadoop
192.168.10.4 nn2.hadoop
192.168.10.5 s1.hadoop
192.168.10.6 s2.hadoop
192.168.10.7 s3.hadoop然后防火墙、selinux都已经关闭,都正确安装jdk8并配置好环境变量,都正确新建了hadoop用户组并将其添加进wheel组。
8.配置五台机器互相ssh免密登录
上边的操作都是在root用户下进行的,现在切换到hadoop用户下进行以后的几乎所有操作。
[root@nn1 ~]# su - hadoop     注意这里的“-”,意味着用户和环境变量同时切换

[hadoop@nn1 ~]$    这时候代表进入到了hadoop用户,还有#和$分别代表root用户和普通用户的身份区别
开始搭建ssh免密
思路是首先在每一台机器上分别创建各自的key,最后把这些key.pub汇总到~/.ssh/authorized_keys文件中再一起分发给所有机器,这时候就实现了五台机器的互相免密ssh访问。
[hadoop@nn1 ~]$ pwd 查看当前路径,确保在hadoop用户的home下

/home/hadoop

[hadoop@nn1 ~]$ mkdir .ssh

[hadoop@nn1 ~]$ chmod 700 ./.ssh

[hadoop@nn1 ~]$ ll -a

drwx------  2 hadoop hadoop 132 7月  16 22:13 .ssh
[hadoop@nn1 ~]$ ssh-keygen -t rsa 创建key文件
这时候完成了nn1机器的设置(nn1作为我们以后的主要操作机器)。按照上边的步骤把剩下的4台机器也弄好,然后分别把其他的4台机器的./ssh/id_rsa.pub重命名(防止重复和以外替换),再发送到nn1的./ssh/下
[hadoop@nn2 ~]$ scp ~/.ssh/id_rsa.pub hadoop@nn1.hadoop ~/.ssh/id_rsa.pubnn2
这时候nn1的~/.ssh/下应该有包括自己在内的5个pub文件(不重名),然后把他们都_追加_到下边的文件中
[hadoop@nn1 ~]$ touch authorized_keys

[hadoop@nn1 ~]$ chmod 600 authorized_keys

[hadoop@nn1 ~]$ cat ./ssh/id_rsa.pub >> authorized_keys

[hadoop@nn1 ~]$ cat ./ssh/id_rsa.pubnn2 >> authorized_keys

[hadoop@nn1 ~]$ cat ./ssh/id_rsa.pubs1 >> authorized_keys

…………
然后最后把这个文件批量发送到其余4台机器上(忘了写批量脚本了,所以用scp命令依次发送吧)
至此5台机器的ssh免密互相访问配置结束,我们可以分别测试(略)。
9.批量脚本编写
因为有5台机器啊,很多操作都要一起动,所以需要批量执行脚本。
#文件名:ips

"nn1.hadoop" "nn2.hadoop" "s1.hadoop" "s2.hadoop" "s3.hadoop"
#!/bin/bash

#文件名:ssh_all.sh

RUN_HOME=$(cd "$(dirname "$0")"; echo "${PWD}")

NOW_LIST=(`cat ${RUN_HOME}/ips`)

SSH_USER="hadoop"

for i in ${NOW_LIST[@]}; do

    f_cmd="ssh $SSH_USER@$i \"$*\""

    echo $f_cmd

    if eval $f_cmd; then

        echo "OK"

    else

        echo "FAIL"

    fi

done
#!/bin/bash

#文件名:ssh_root.sh

RUN_HOME=$(cd "$(dirname "$0")"; echo "${PWD}")

NOW_LIST=(`cat ${RUN_HOME}/ips`)

SSH_USER="hadoop"

for i in ${NOW_LIST[@]}; do

    f_cmd="ssh $SSH_USER@i ~/exe.sh \"$*\""

    echo $f_cmd

    if eval $f_cmd; then

        echo "OK"

    else

        echo "FAIL"

    fi

done
#文件名exe.sh

cmd=$*

su - <<EOF

$cmd

EOF
#!/bin/bash

RUN_HOME=$(cd "(dirname "$0")"; echo "${PWD}")

NOW_LIST=(`cat ${UN_HOME}/ips`)

SSH_USER="hadoop"

for i in ${NOW_LIST[@]}; do

    f_cmd="scp $1 $SSH_USER@i:$2"

    echo $f_cmd

    if eval $f_cmd; then

        echo "ok"

    else

        echo "FAIL"

    fi

done
前期准备工作结束,下一篇开始安装配置zookeeper
Hadoop集群搭建-01前期准备的更多相关文章
- Hadoop集群搭建-05安装配置YARN
Hadoop集群搭建-04安装配置HDFS Hadoop集群搭建-03编译安装hadoop Hadoop集群搭建-02安装配置Zookeeper Hadoop集群搭建-01前期准备 先保证集群5台虚 ...
- Hadoop集群搭建-04安装配置HDFS
Hadoop集群搭建-05安装配置YARN Hadoop集群搭建-04安装配置HDFS Hadoop集群搭建-03编译安装hadoop Hadoop集群搭建-02安装配置Zookeeper Hado ...
- Hadoop集群搭建-03编译安装hadoop
Hadoop集群搭建-05安装配置YARN Hadoop集群搭建-04安装配置HDFS Hadoop集群搭建-03编译安装hadoop Hadoop集群搭建-02安装配置Zookeeper Hado ...
- Hadoop集群搭建-02安装配置Zookeeper
Hadoop集群搭建-05安装配置YARN Hadoop集群搭建-04安装配置HDFS Hadoop集群搭建-03编译安装hadoop Hadoop集群搭建-02安装配置Zookeeper Hado ...
- 环境搭建-Hadoop集群搭建
环境搭建-Hadoop集群搭建 写在前面,前面我们快速搭建好了centos的集群环境,接下来,我们就来开始hadoop的集群的搭建工作 实验环境 Hadoop版本:CDH 5.7.0 这里,我想说一下 ...
- Hadoop 集群搭建
Hadoop 集群搭建 2016-09-24 杜亦舒 目标 在3台服务器上搭建 Hadoop2.7.3 集群,然后测试验证,要能够向 HDFS 上传文件,并成功运行 mapreduce 示例程序 搭建 ...
- Hadoop集群搭建安装过程(三)(图文详解---尽情点击!!!)
Hadoop集群搭建安装过程(三)(图文详解---尽情点击!!!) 一.JDK的安装 安装位置都在同一位置(/usr/tools/jdk1.8.0_73) jdk的安装在克隆三台机器的时候可以提前安装 ...
- Hadoop集群搭建安装过程(二)(图文详解---尽情点击!!!)
Hadoop集群搭建安装过程(二)(配置SSH免密登录)(图文详解---尽情点击!!!) 一.配置ssh无密码访问 ®生成公钥密钥对 1.在每个节点上分别执行: ssh-keygen -t rsa(一 ...
- Hadoop集群搭建安装过程(一)(图文详解---尽情点击!!!)
Hadoop集群搭建(一)(上篇中讲到了Linux虚拟机的安装) 一.安装所需插件(以hadoop2.6.4为例,如果需要可以到官方网站进行下载:http://hadoop.apache.org) h ...
随机推荐
- [51Nod] 配对
https://www.51nod.com/onlineJudge/questionCode.html#!problemId=1737 求出树的重心,跑spfa #include <iostre ...
- jumpserver官方手动安装
测试环境 CPU: 64位双核处理器 内存: 4G DDR3 数据库:mysql 版本大于等于 5.6 mariadb 版本大于等于 5.5.6 环境 系统: CentOS 7 IP: 192.168 ...
- NSMutableArray
NSMutableArray 是一个可变数组,是NSArray的子类,但是不可以添加空值 创建NSMutableArray的方法 +(id)arrarWithCapacity:(NSInteger)n ...
- MySQL数据分析-(12)表操作补充:字段属性
大家好,我是jacky朱元禄,很高兴继续跟大家学习MySQL数据分析实战,今天我们分享的主题是表操作补充之字段属性,依照惯例第一部分,jacky先跟大家分享本课时的学习逻辑 (一)学习逻辑 我们说创建 ...
- 前端逼死强迫症系列之javascript
JavaScript 和Python.C#.Java.Ruby一样,都是一门独立的编程语言. 像python.C.Java等都需要解释器,学习它们的语法.而浏览器本身就是javascript的解释器. ...
- 【学习笔记】OI模板整理
CSP2019前夕整理一下模板,顺便供之后使用 0. 非算法内容 0.1. 读入优化 描述: 使用getchar()实现的读入优化. 代码: inline int read() { int x=0; ...
- java微服务简介与实战
今年做了一段时间的可见光.ceph存储,后端开发微服务项目,在这记录点东西,也方便大家借鉴查找. springboot的项目实例:https://github.com/ityouknow/spring ...
- 【spring源码分析】IOC容器初始化——查漏补缺(四)
前言:在前几篇查漏补缺中,其实我们已经涉及到bean生命周期了,本篇内容进行详细分析. 首先看bean实例化过程: 分析: bean实例化开始后 注入对象属性后(前面IOC初始化十几篇文章). 检查激 ...
- PHP中部分宏应用
1.字符串复制 ZVAL_STRINGL(pzv, str, len, dup):str 和 len 分别为内存中保存的字符串地址和他的长度,dup之名该字符串是否需要被复制,值为1则将先申请一块新内 ...
- Android 显示系统:SurfaceFlinger详解
一.Android系统启动 Android设备从按下开机键到桌面显示画面,大致过程如下图流程: 开机显示桌面.从桌面点击 App 图标到 Activity显示在屏幕上的过程又是怎样的呢?下面介绍And ...