
Colab教程(超级详细版)及Colab Pro/Colab Pro+使用评测
一、Colab介绍
Colab是什么?
Colab相关的概念
二、Colab工作流程
准备工作
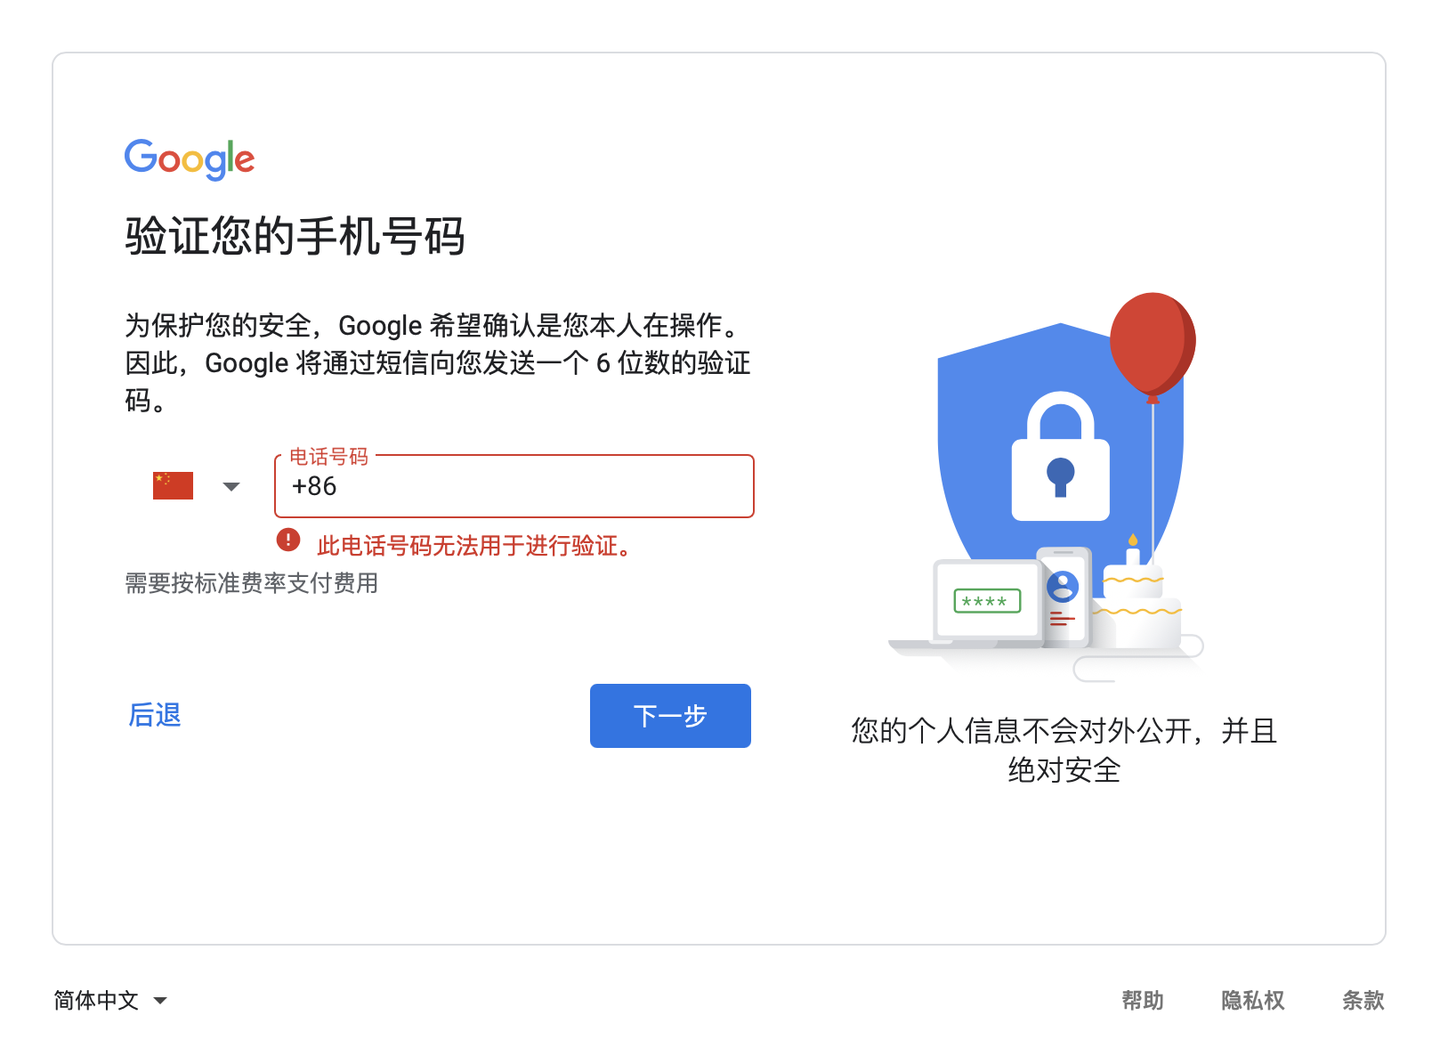
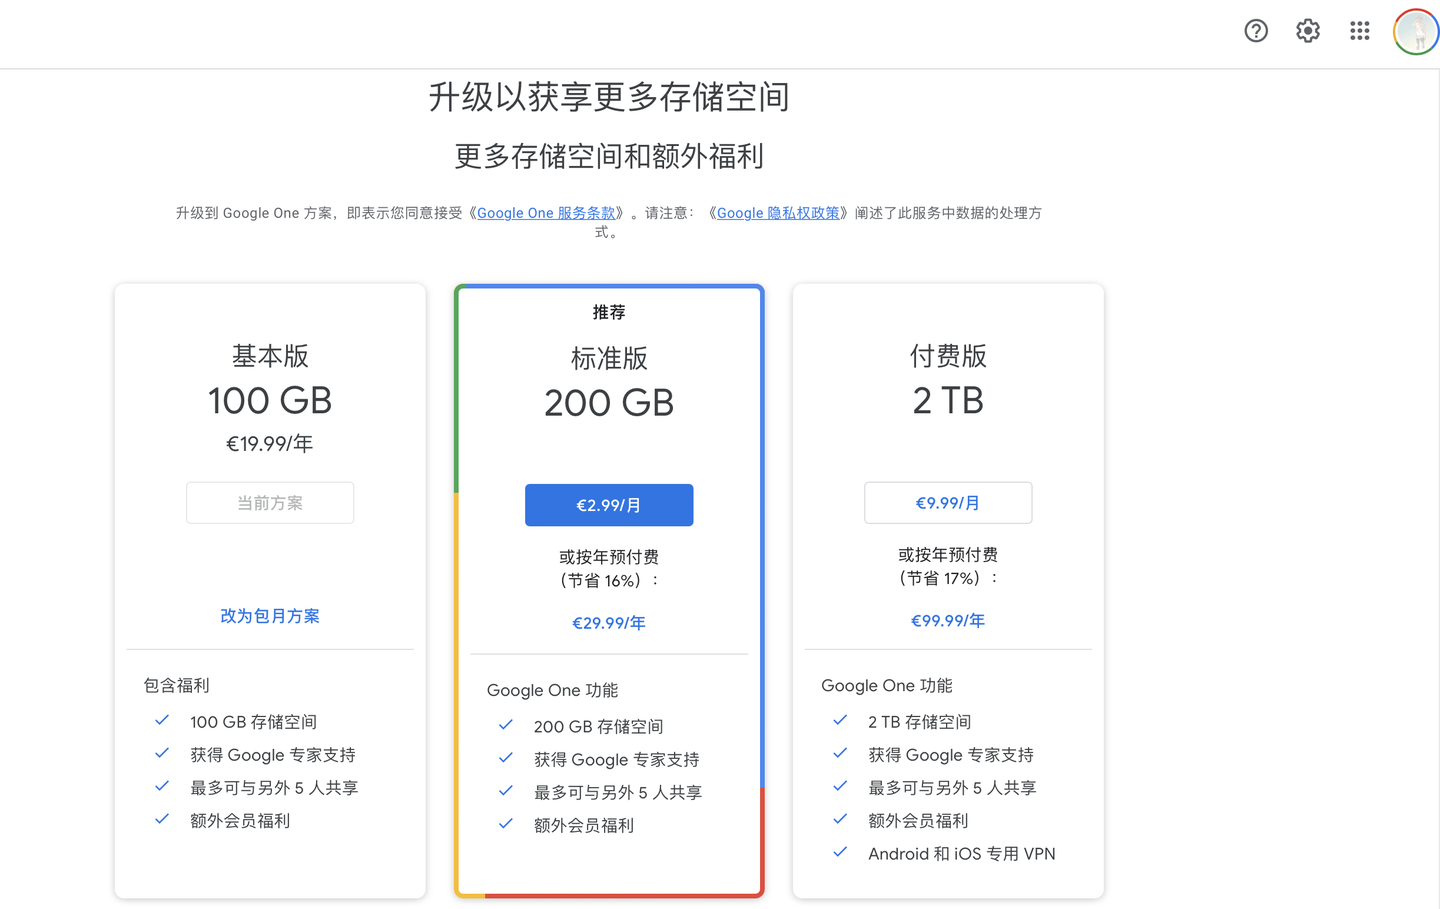
新建笔记本
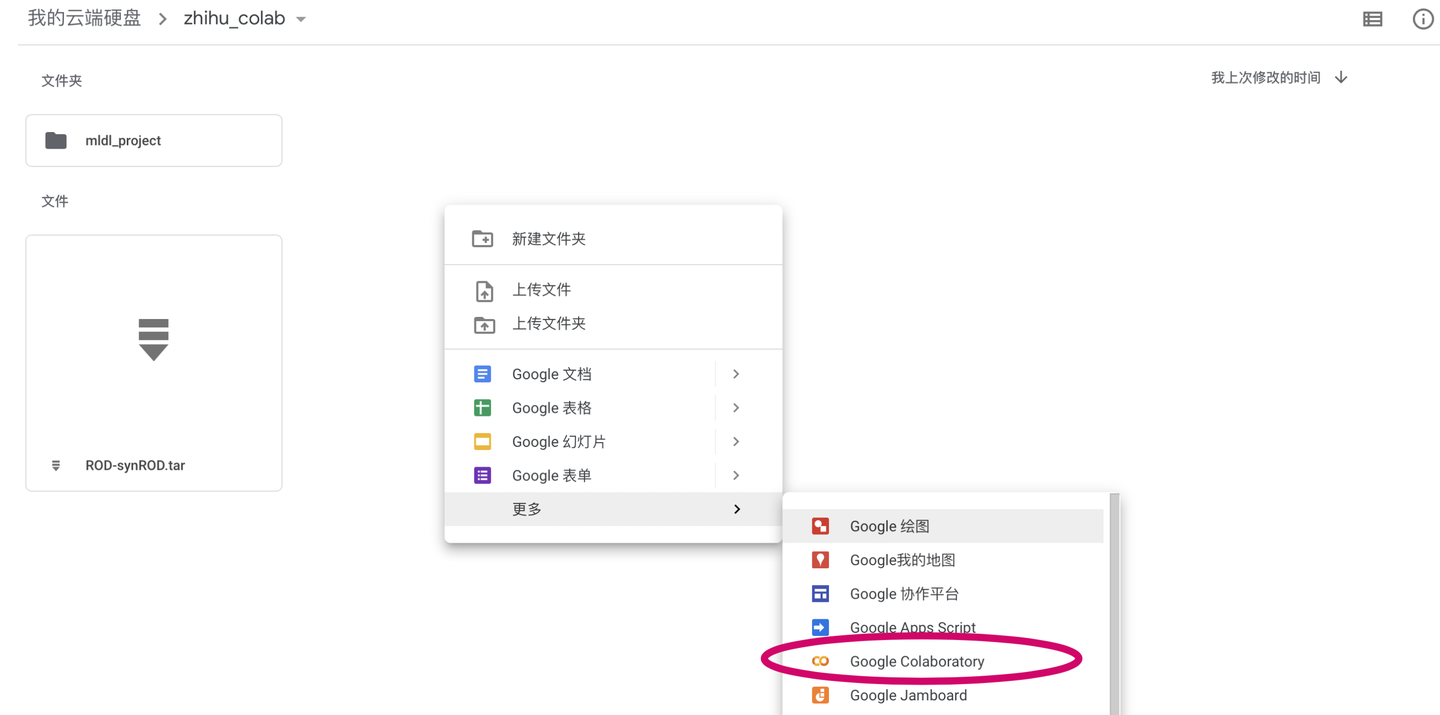
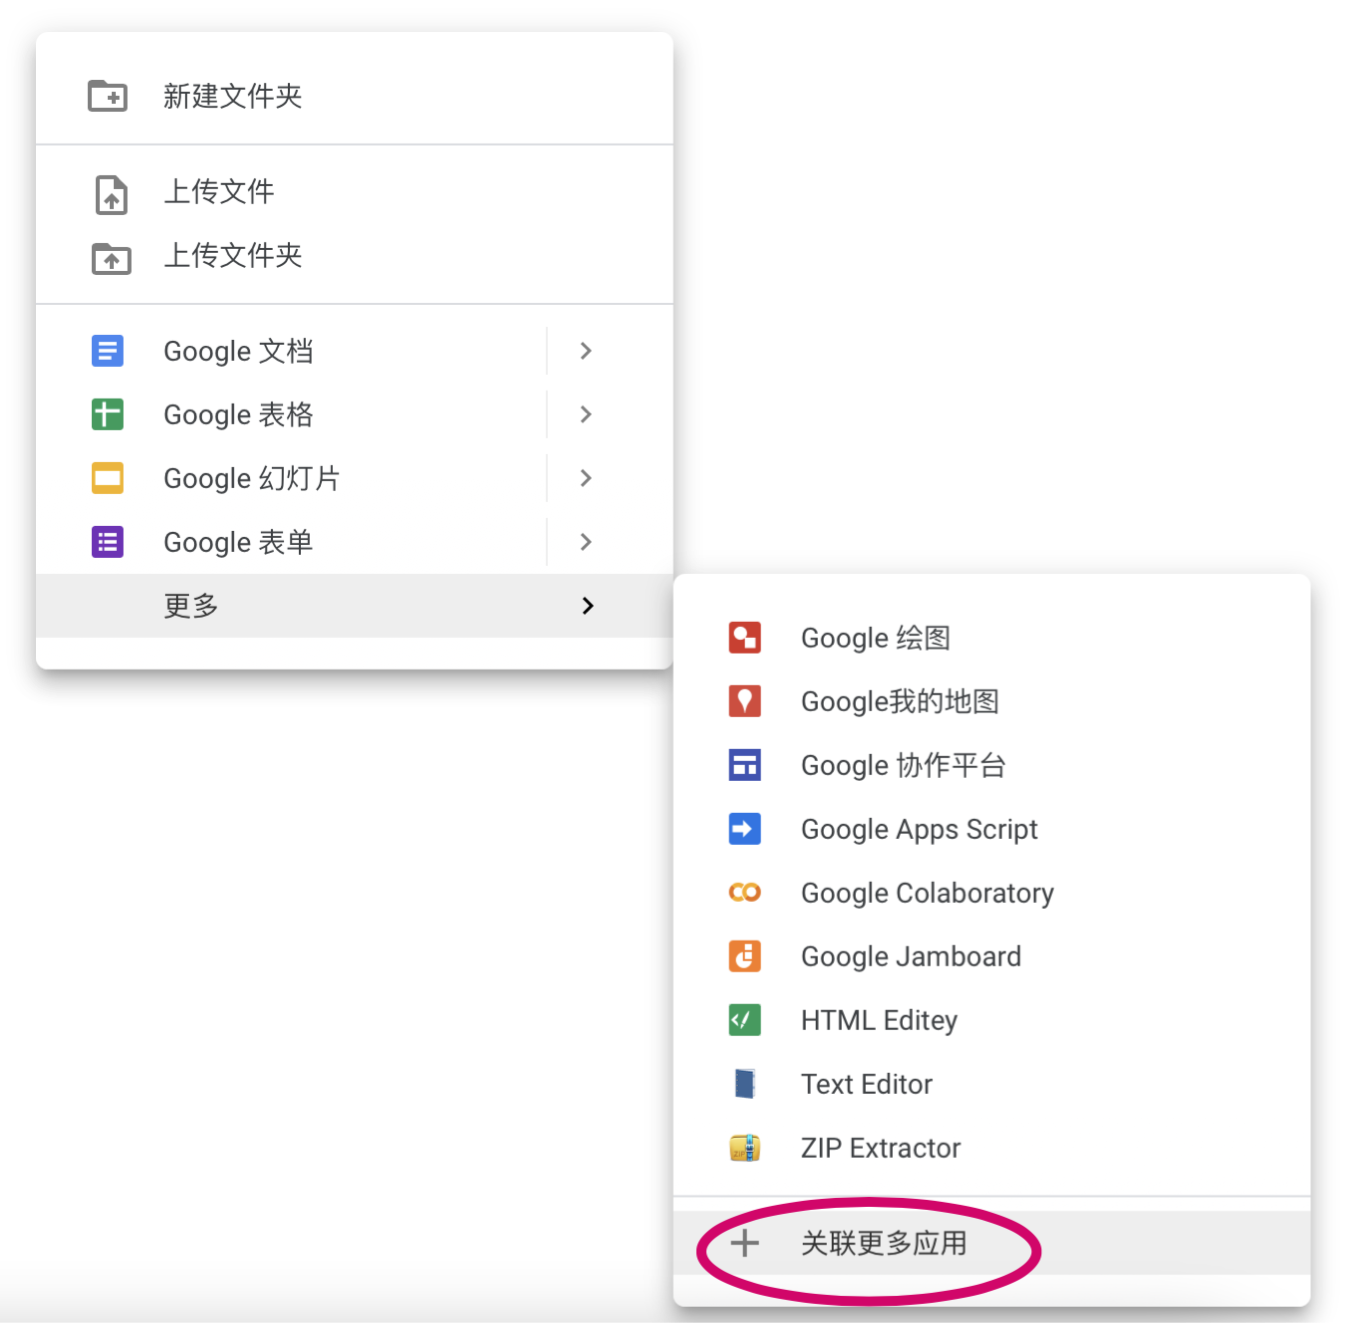
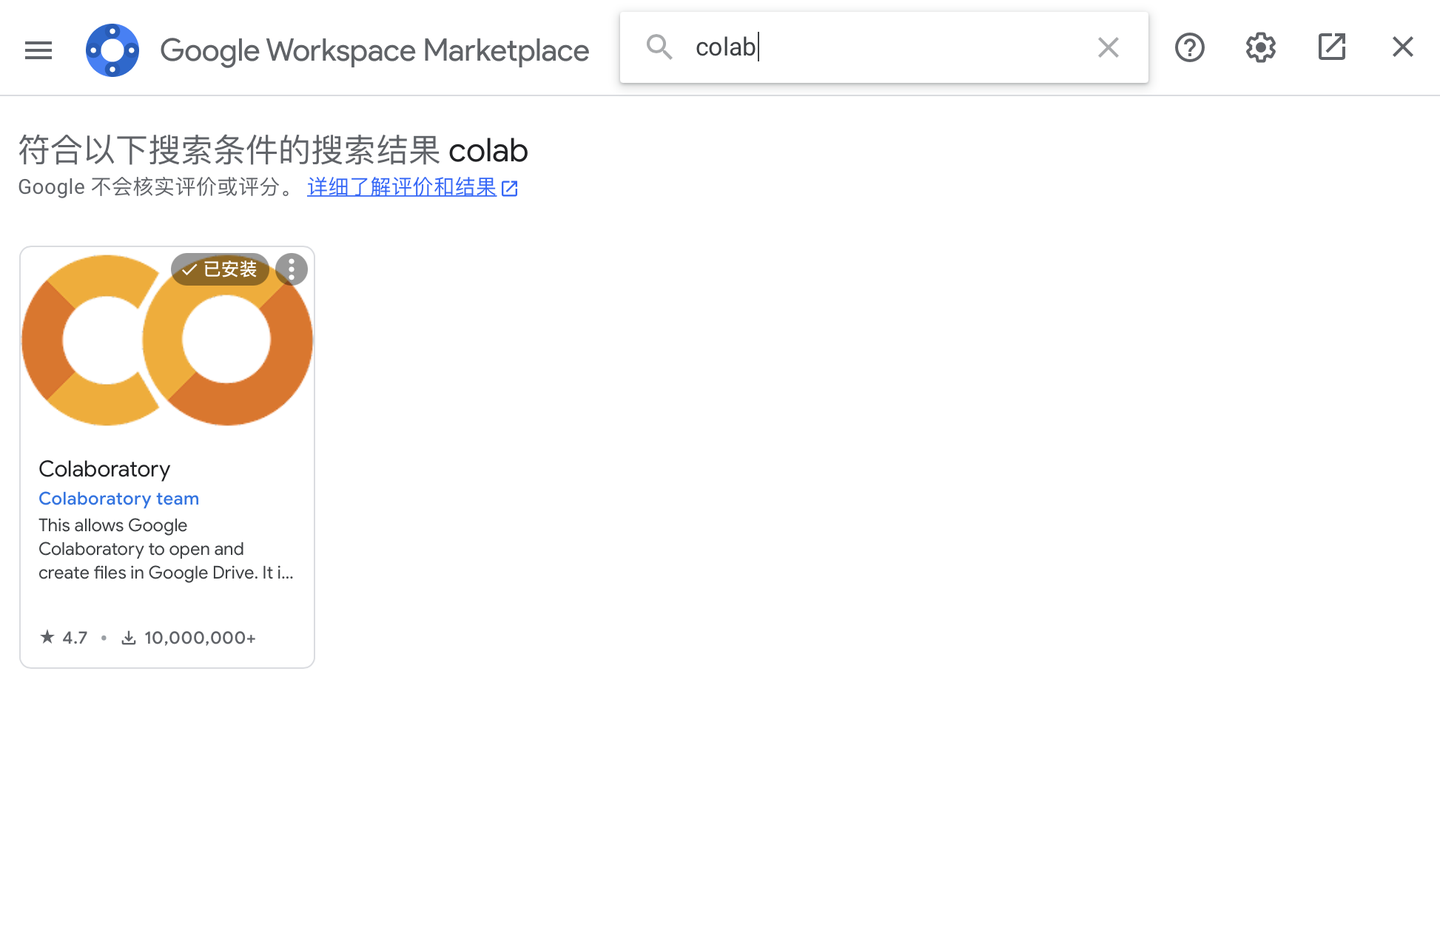
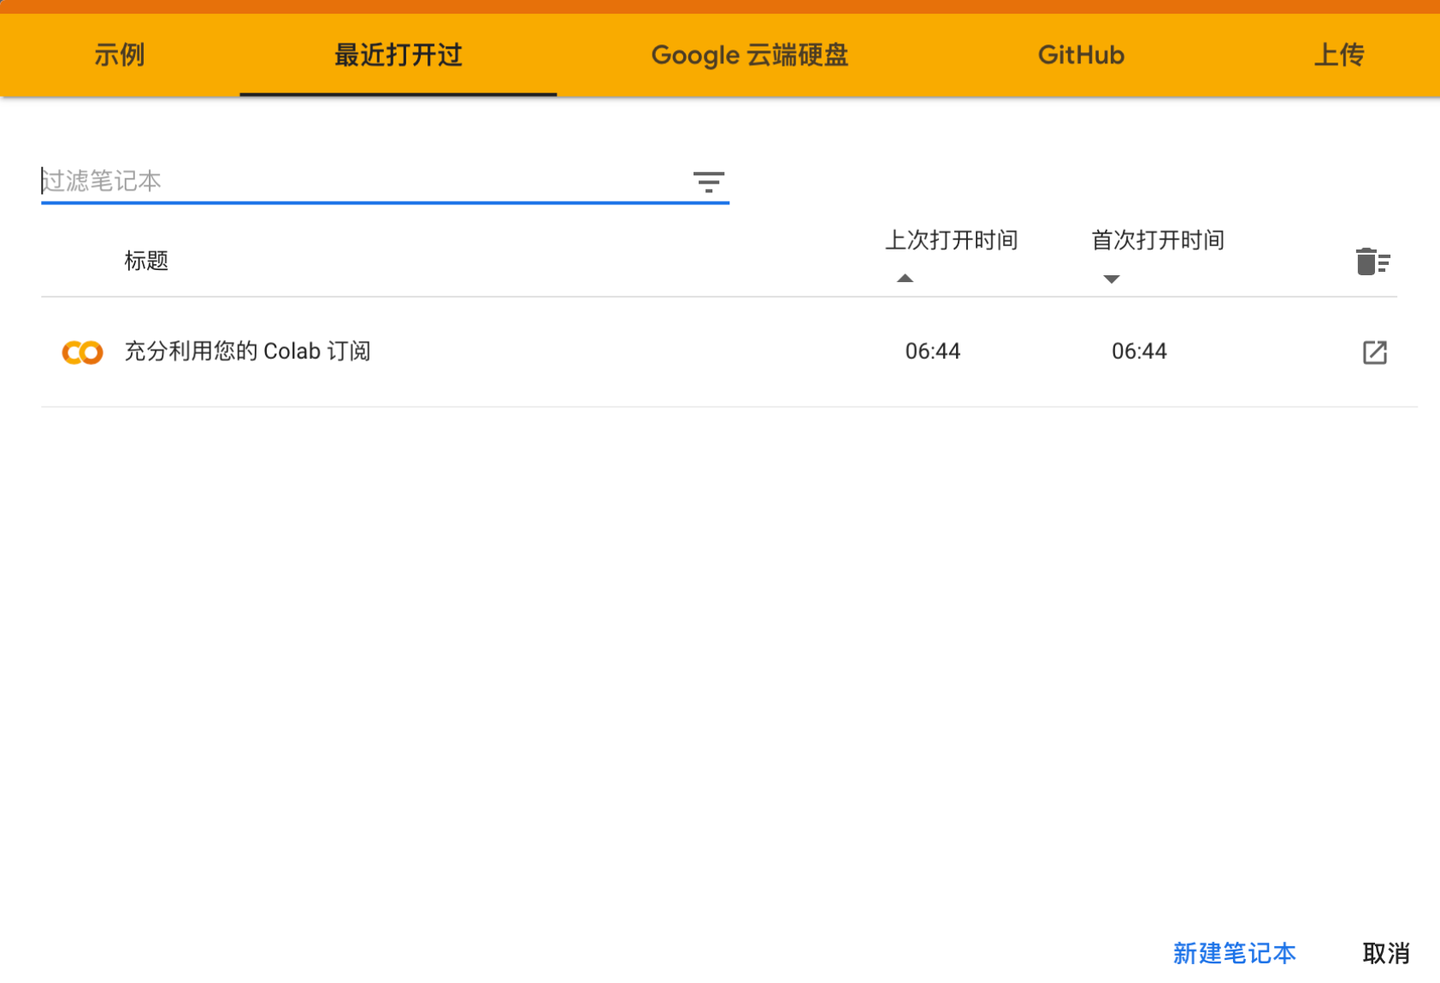
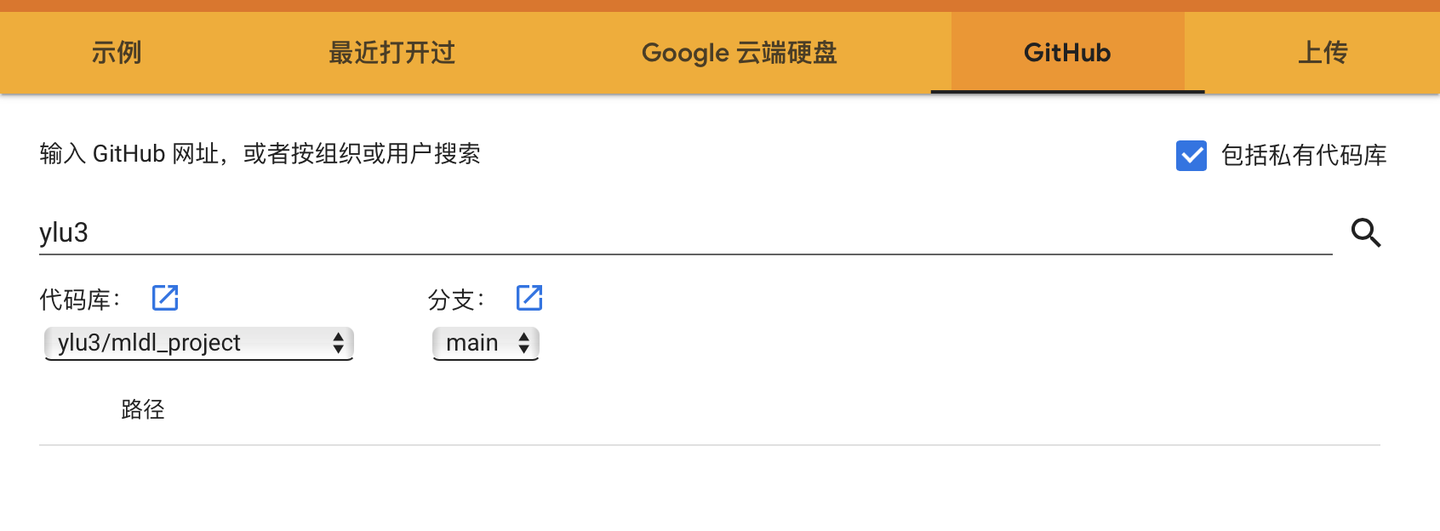
载入笔记本
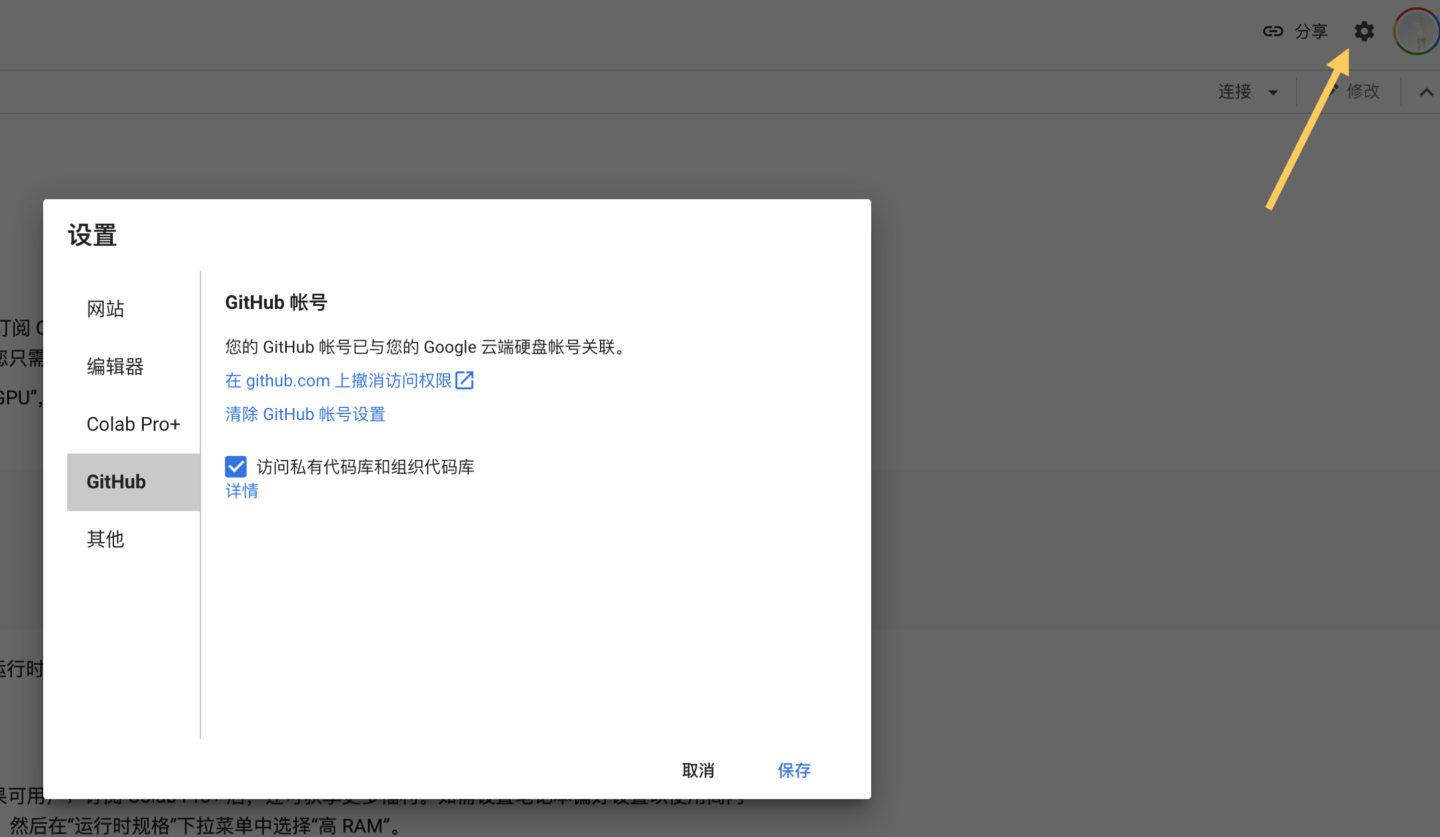
笔记本界面
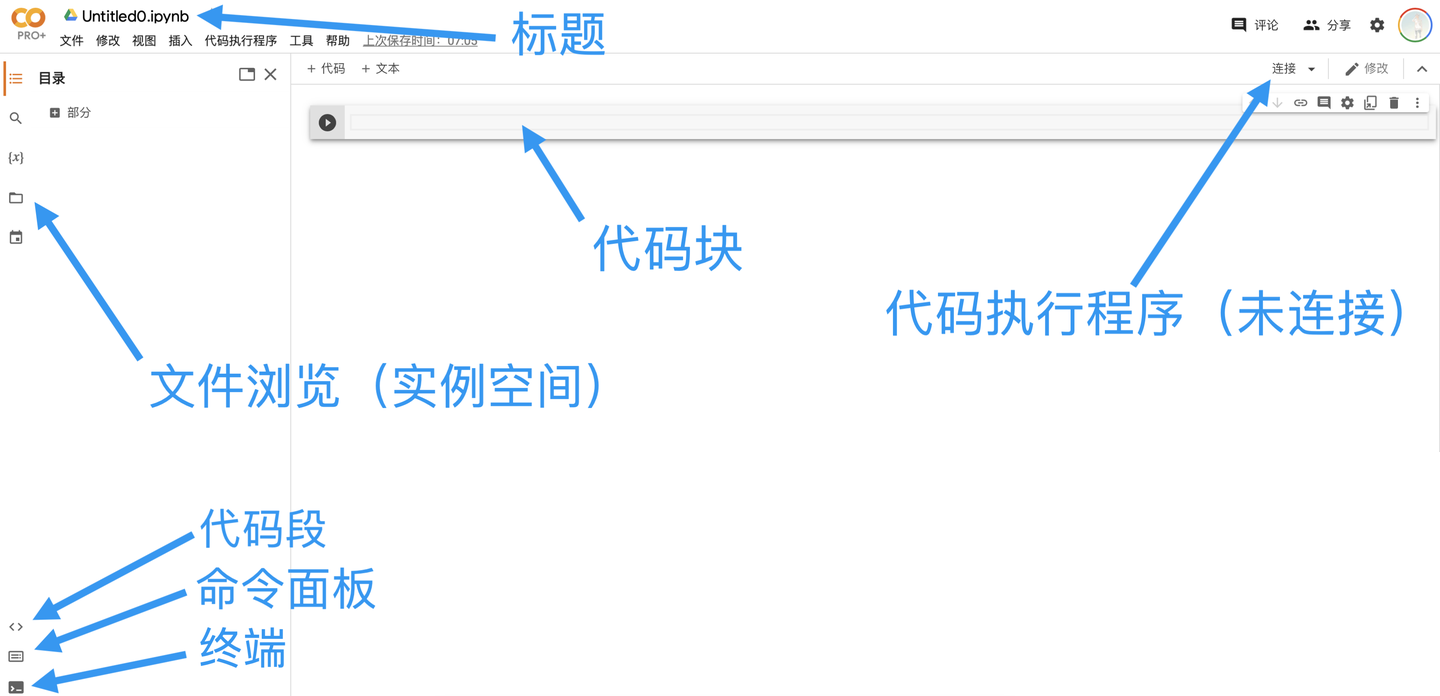
连接代码执行程序
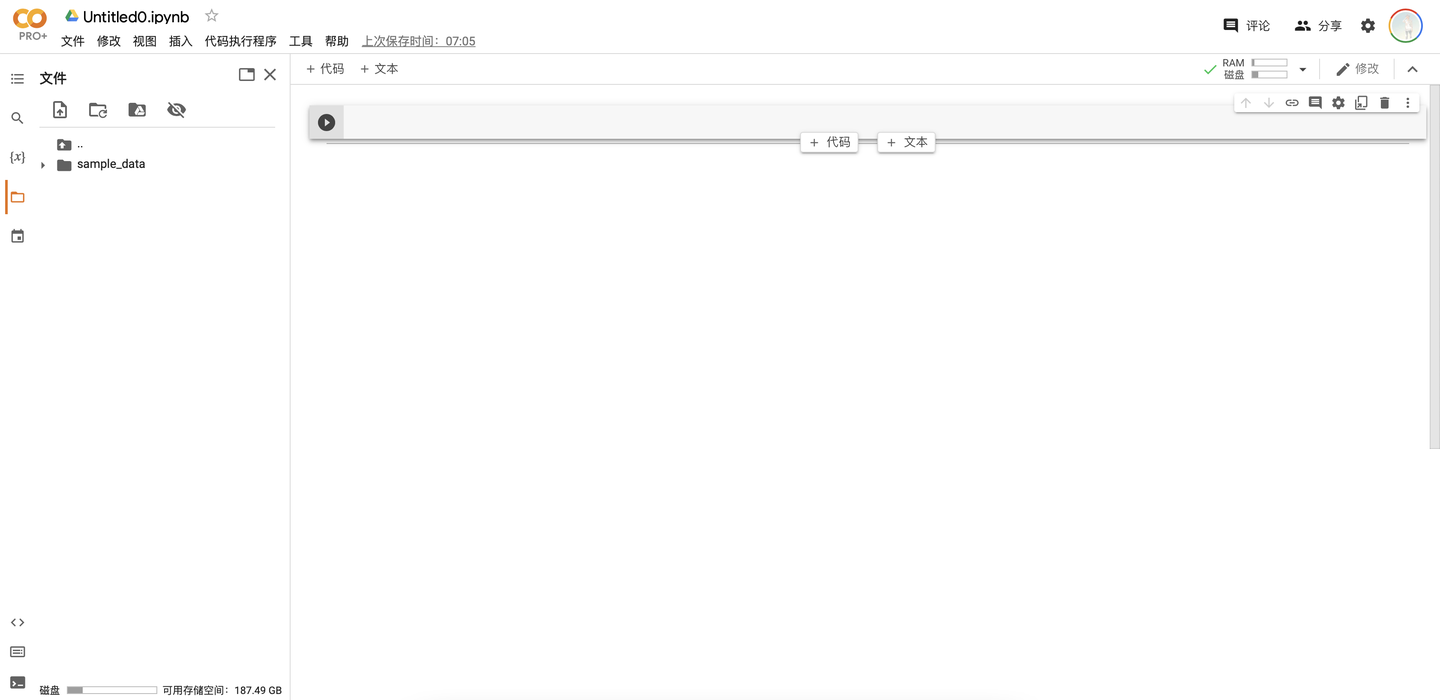
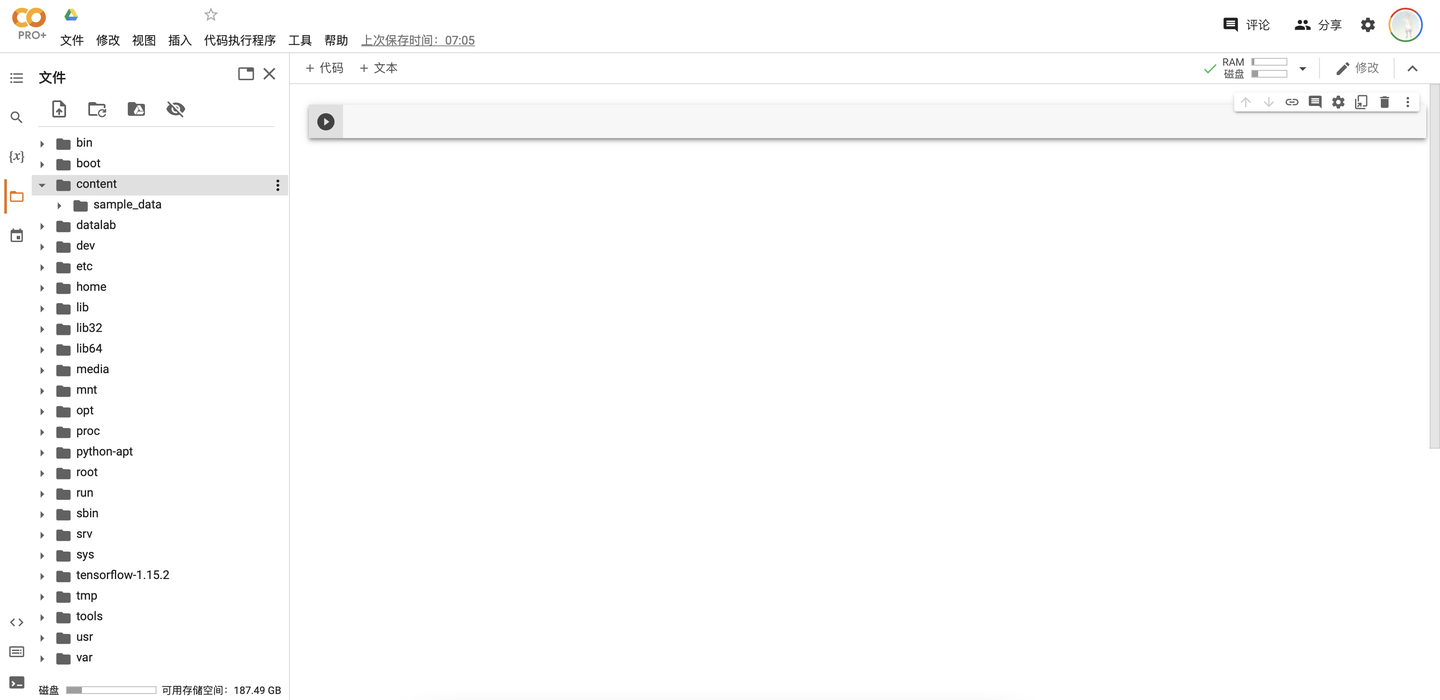
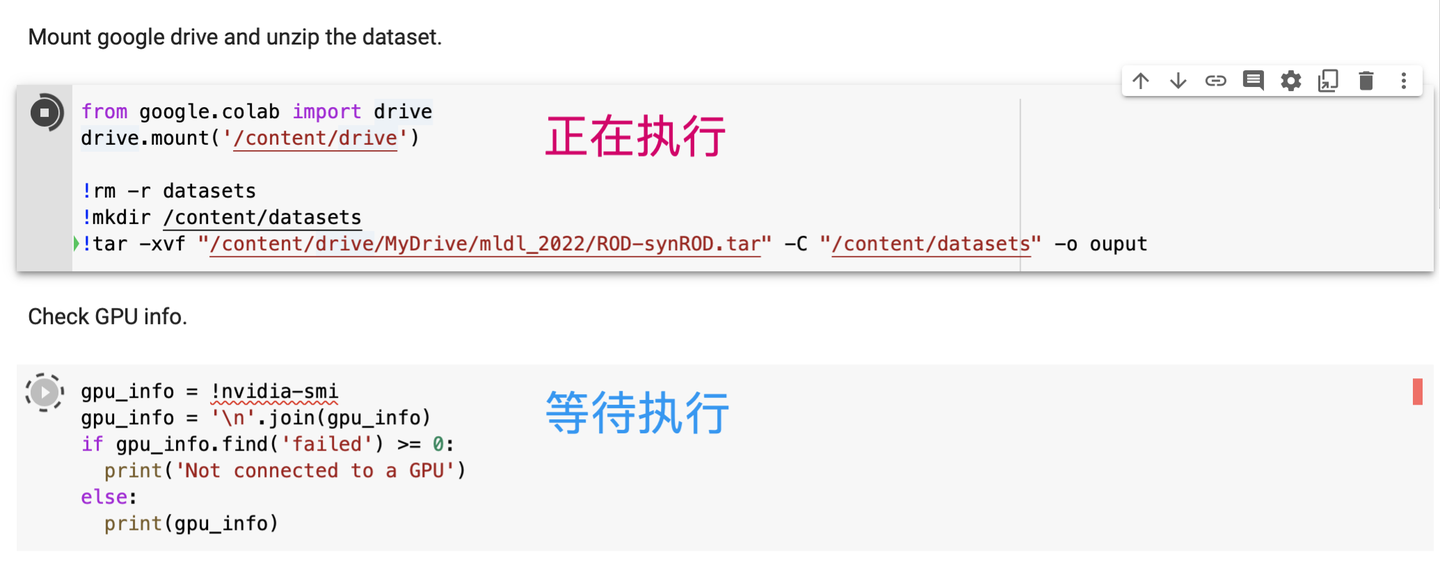
执行代码块
# 加载云端硬盘

from google.colab import drive

drive.mount('/content/drive')

# 查看分配到的GPU

gpu_info = !nvidia-smi

gpu_info = '\n'.join(gpu_info)

if gpu_info.find('failed') >= 0:

    print('Not connected to a GPU')

else:

    print(gpu_info)

# 安装python包

!pip3 install <package>
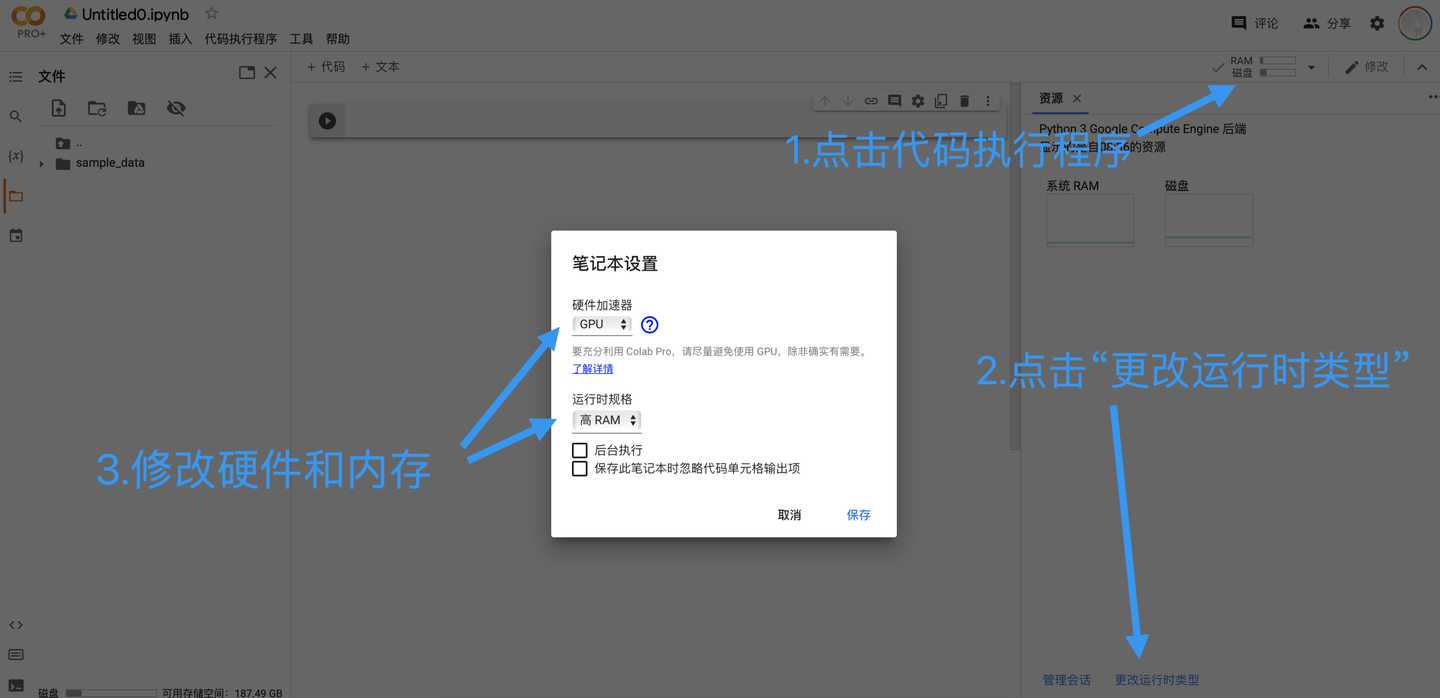
设置笔记本的运行时类型
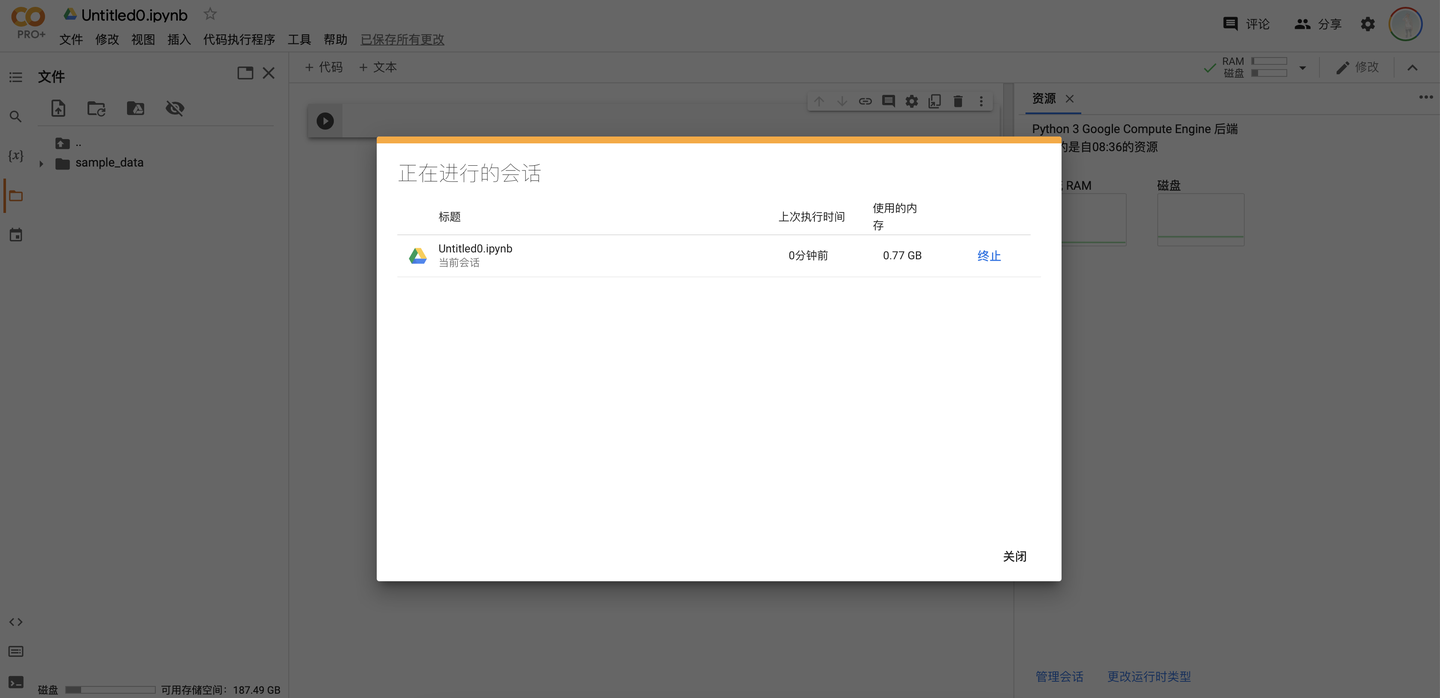
管理会话Session
三、Colab重要特性
资源使用的限制
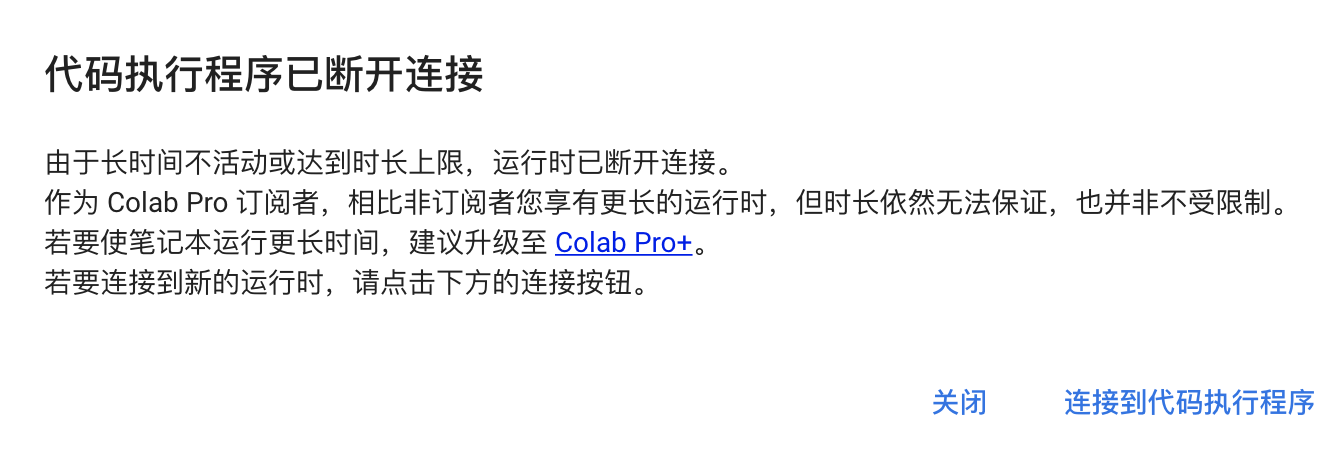
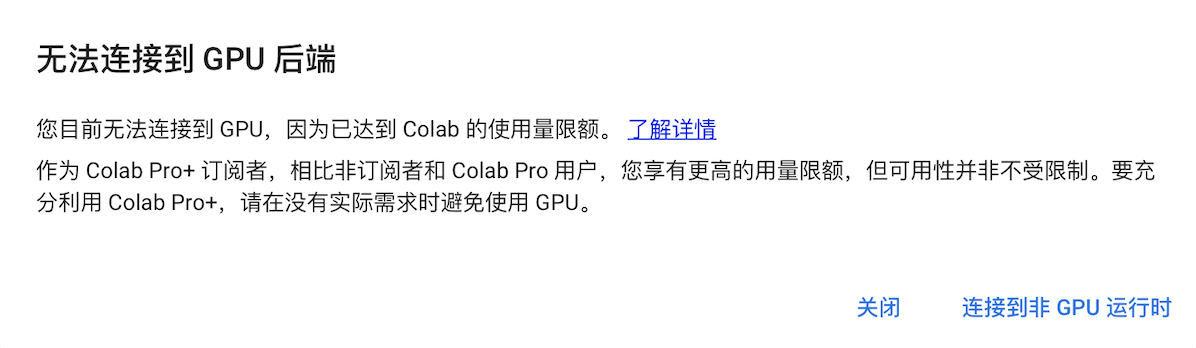
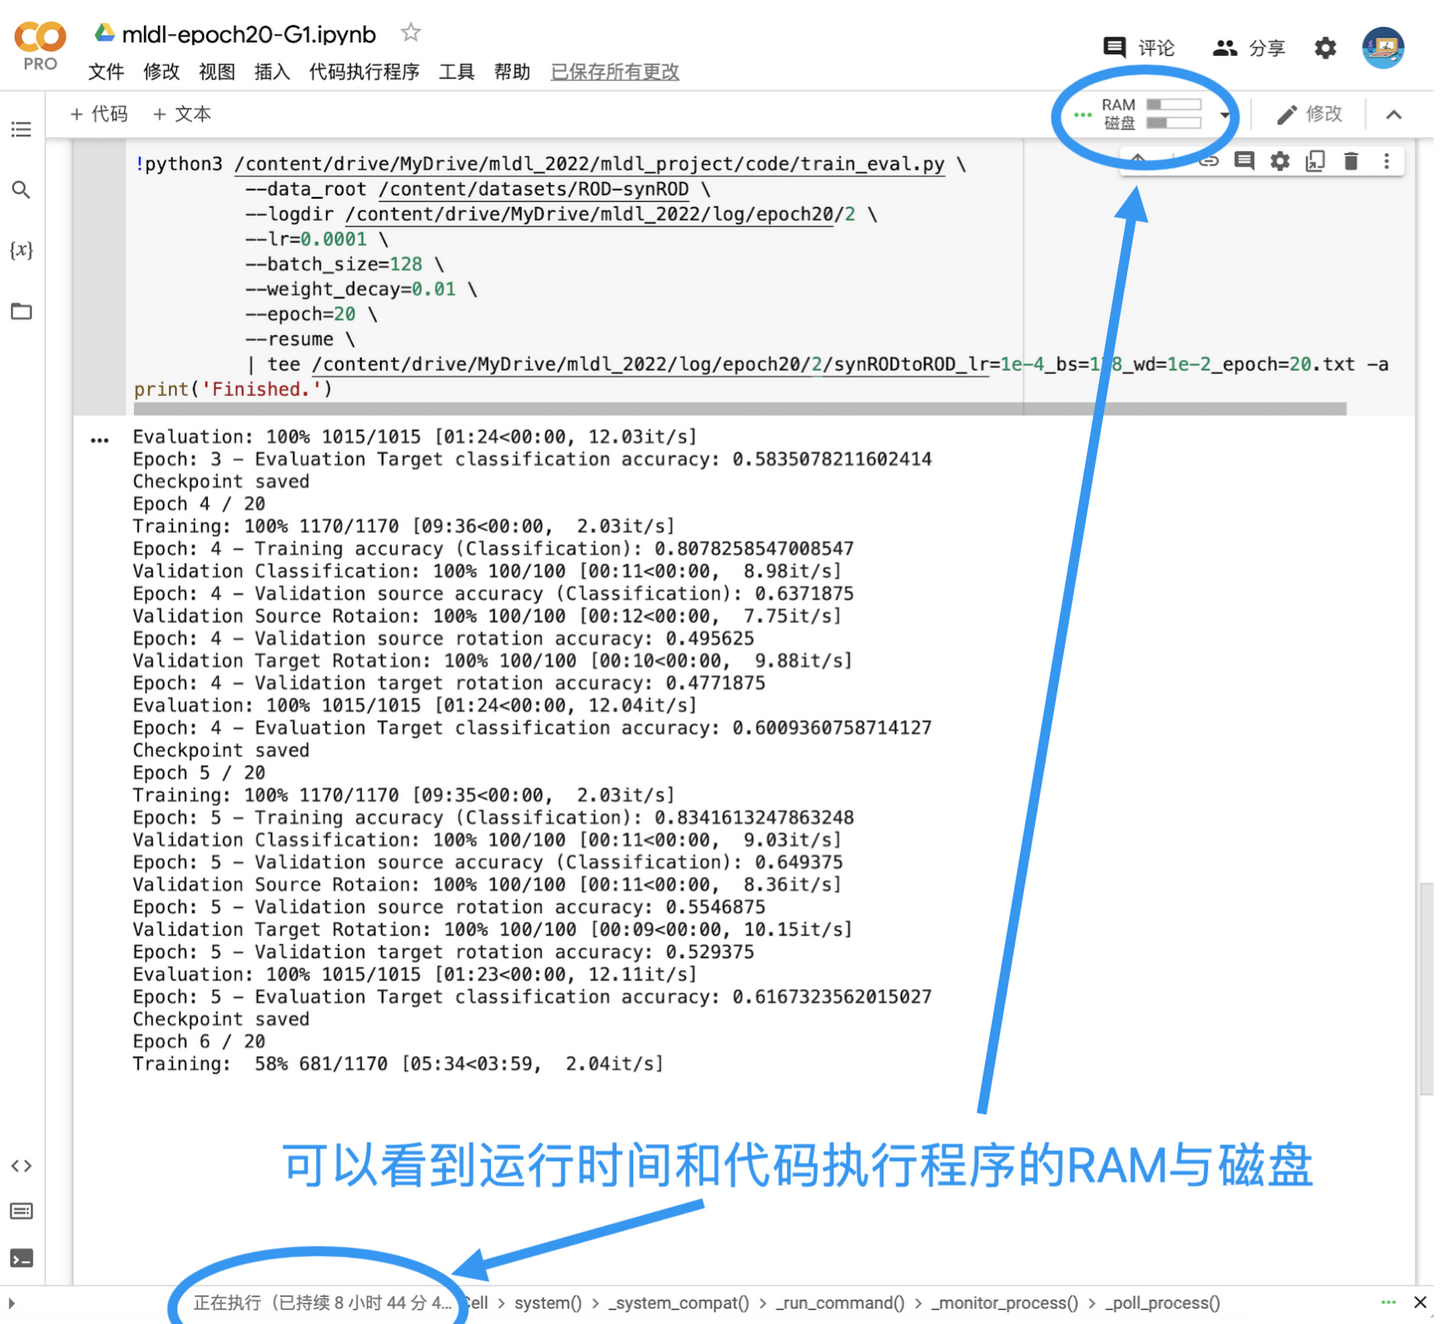
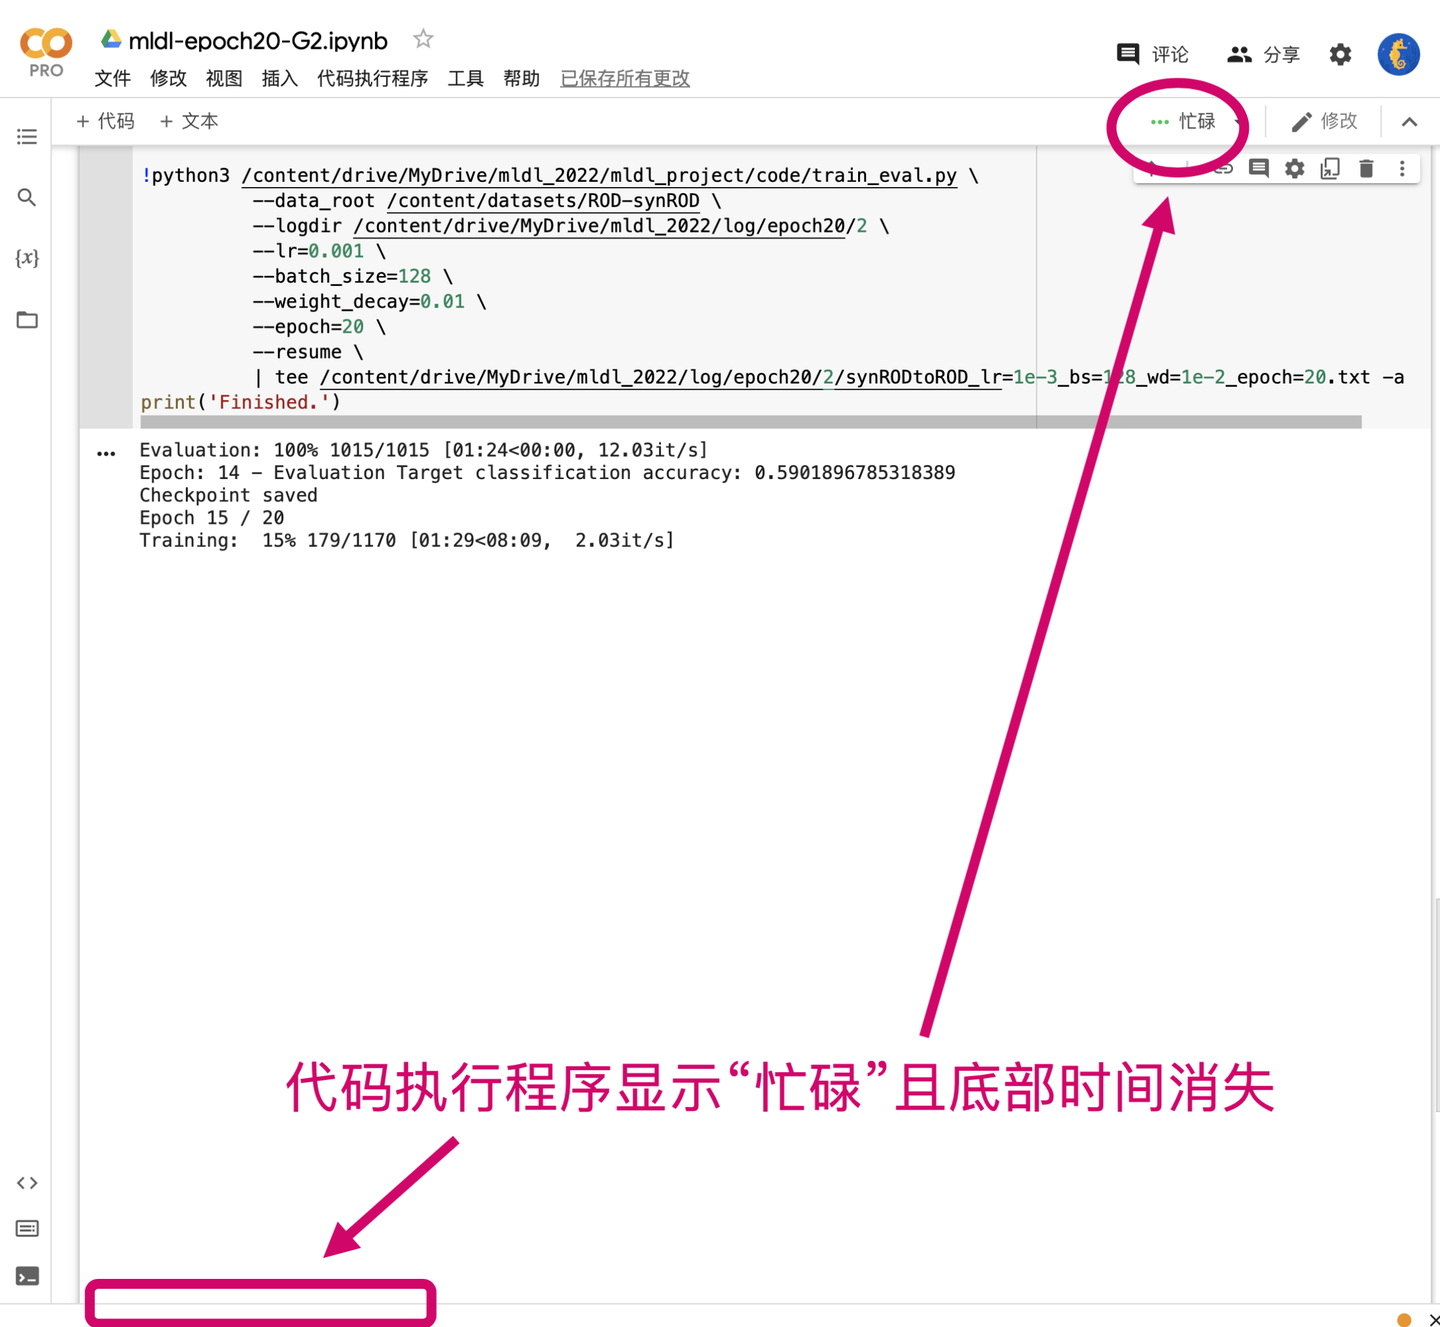
如何合理使用资源?
- 将训练过后的模型日志和其他重要的文件保存到谷歌云盘,而不是本地的实例空间
- 运行的代码必须支持“断点续传”能力,简单来说就是必须定义类似checkpoint功能的函数;假设我们一共需要训练40个epochs,在第30个epoch掉线了之后模型能够从第30个epoch开始训练而不是从头再来
- 仅在模型训练时开启GPU模式,在构建模型或其他非必要情况下使用None模式
- 在网络稳定的情况下开始训练,每隔一段时间查看一下训练的情况
- 注册多个免费的谷歌账号交替使用
四、Colab项目组织
加载数据集
运行Github项目
# 克隆仓库到/content/my-repo目录下

!git clone https://github.com/my-github-username/my-git-repo.git %cd my-git-repo !./train.py --logdir /my/log/path --data_root /my/data/root --resume
from train import my_training_method

my_training_method(arg1, arg2, ...)
import sys

sys.path.append('/content/my-git-repo') # 把git仓库的目录添加到系统目录
如何处理简单项目?
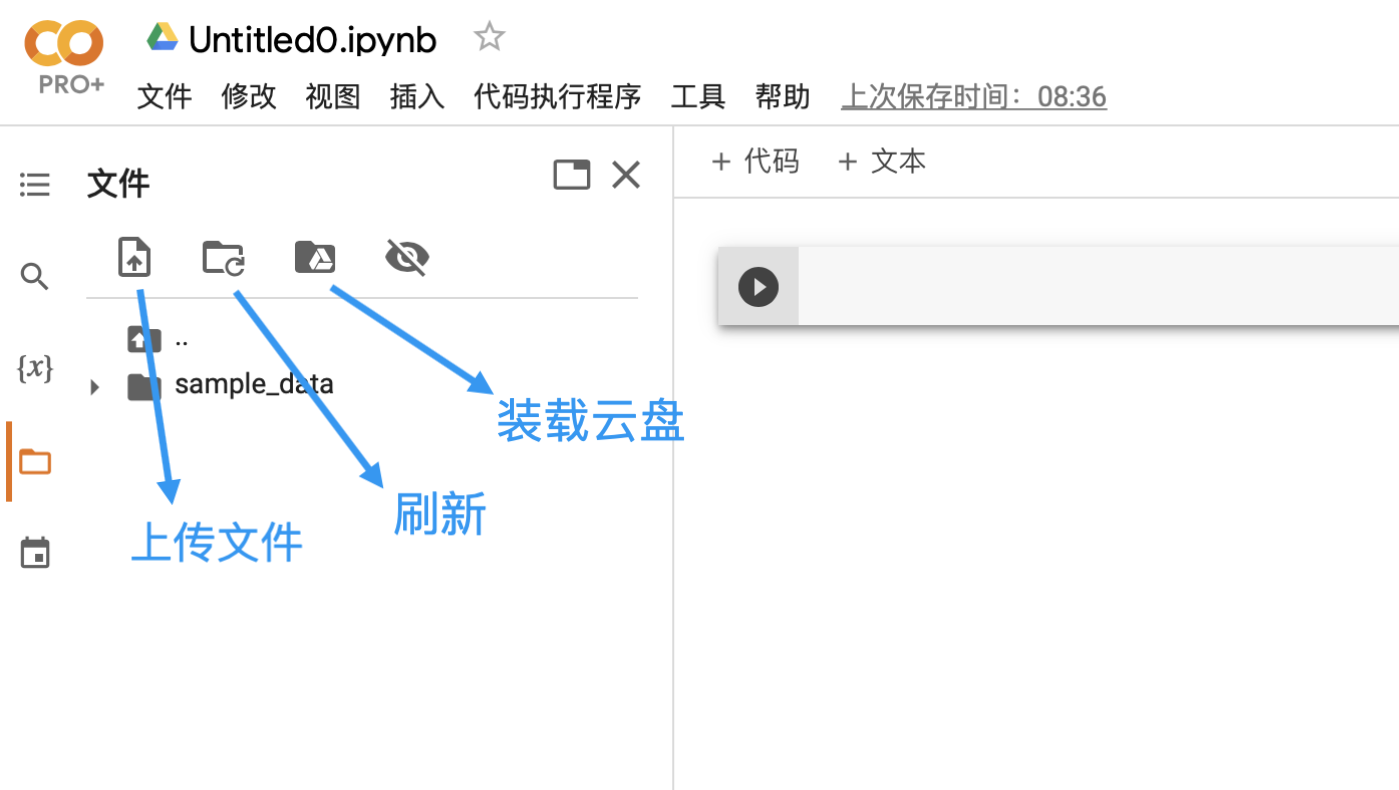
五、实例演示
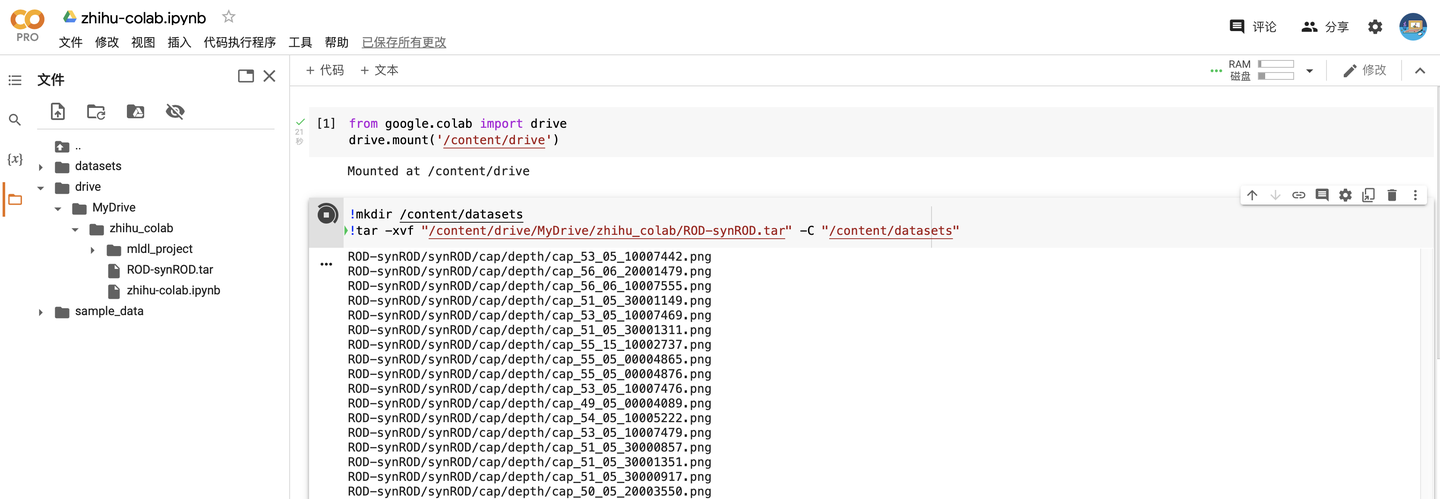
from google.colab import drive

drive.mount('/content/drive')
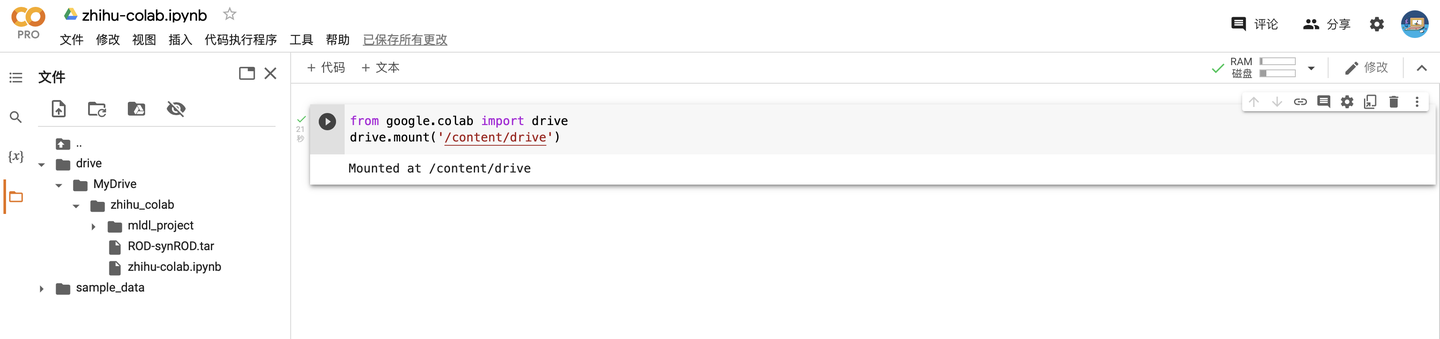
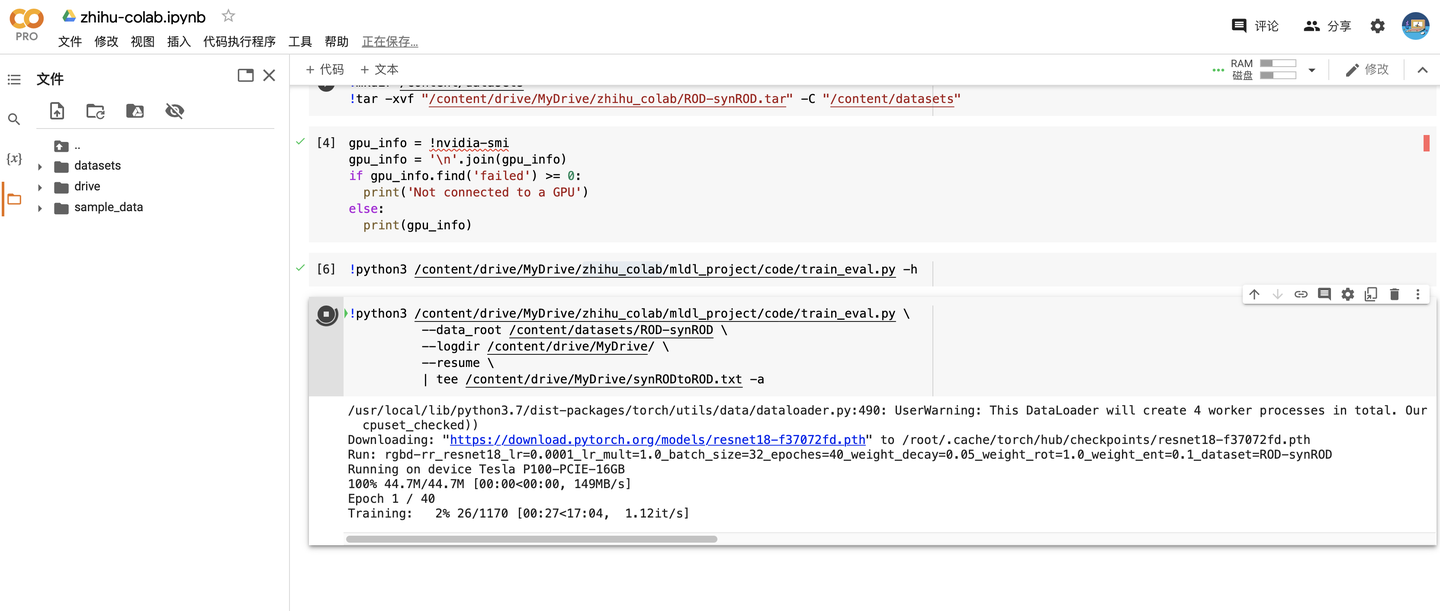
!mkdir /content/datasets !tar -xvf "/content/drive/MyDrive/zhihu_colab/ROD-synROD.tar" -C "/content/datasets"
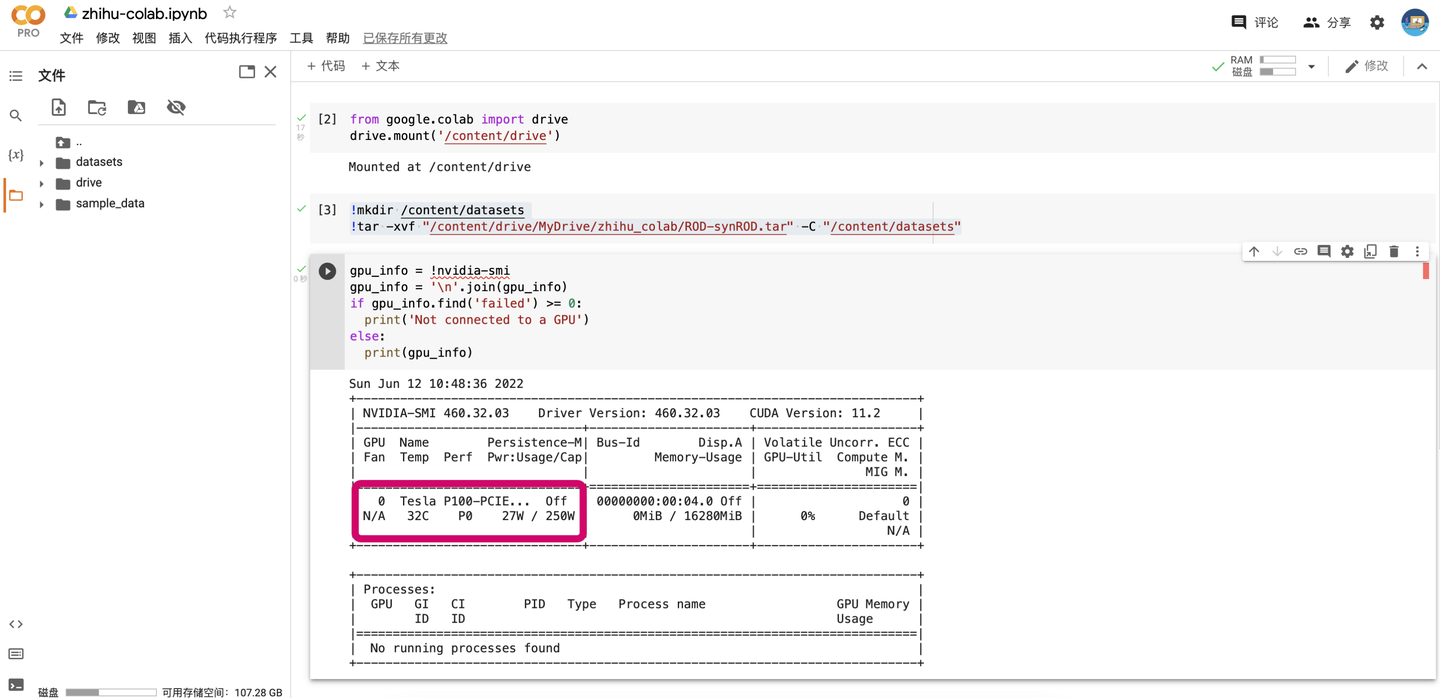
gpu_info = !nvidia-smi

gpu_info = '\n'.join(gpu_info)

if gpu_info.find('failed') >= 0:

    print('Not connected to a GPU')

else:

    print(gpu_info)
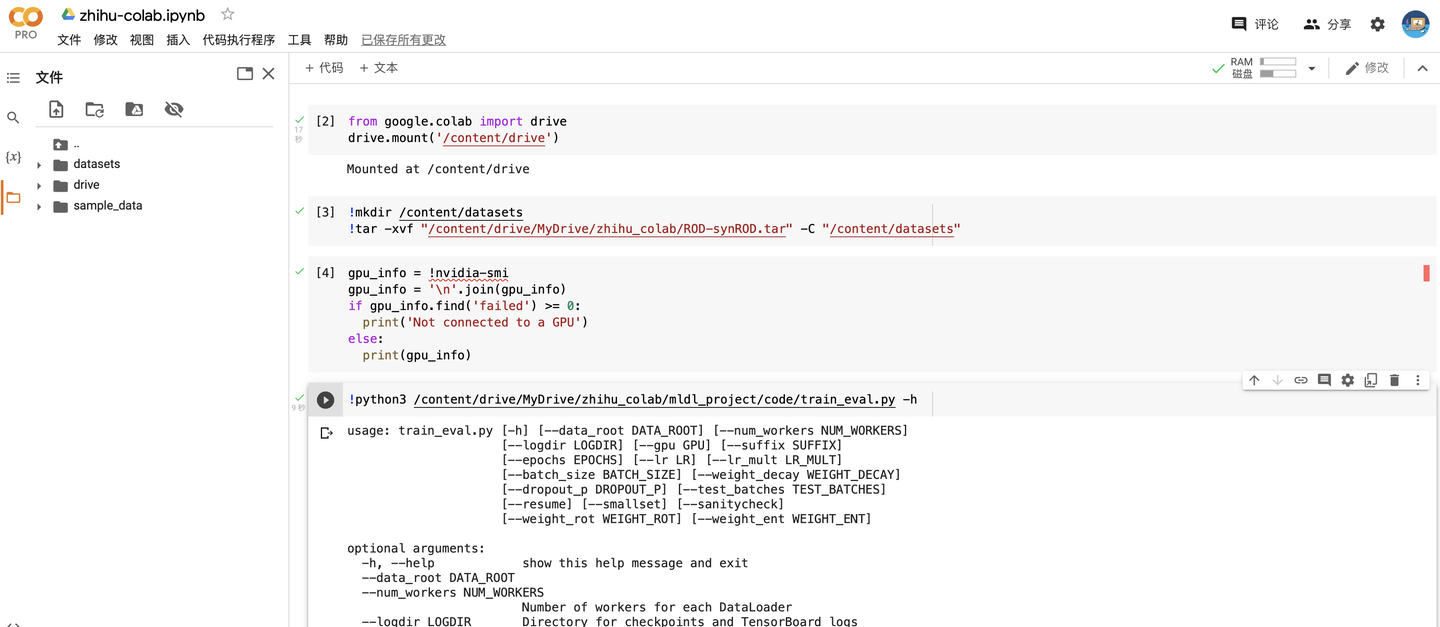
!python3 /content/drive/MyDrive/zhihu_colab/mldl_project/code/train_eval.py \

--data_root /content/datasets/ROD-synROD \

--logdir /content/drive/MyDrive/ \ --

resume \

| tee /content/drive/MyDrive/synRODtoROD.txt -a
六、Colab Pro / Pro+
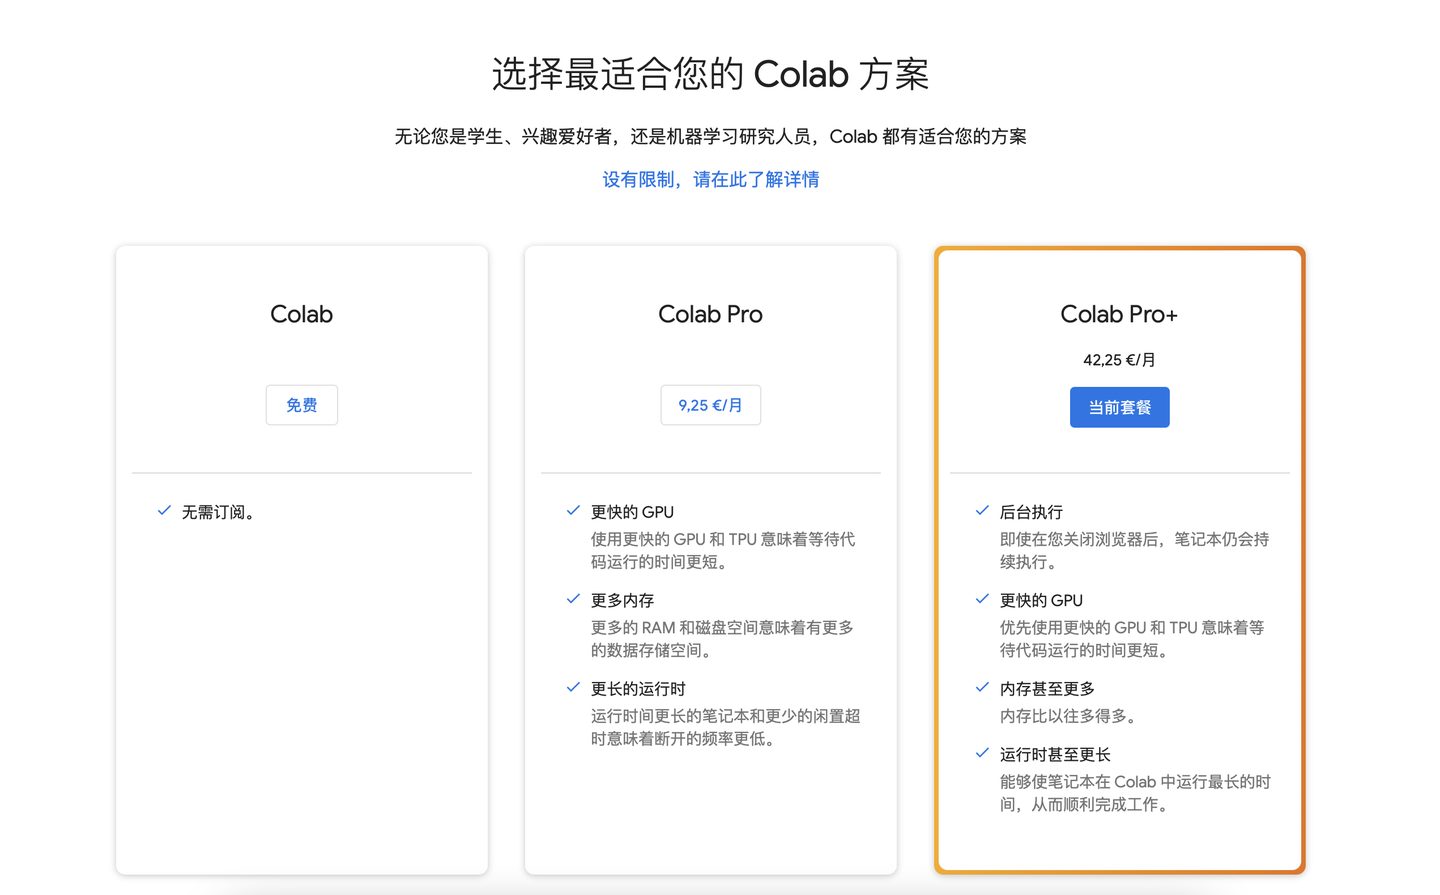
RAM-磁盘
|
高RAM
|
磁盘
|
后台运行
|
|
|---|---|---|---|
|
免费
|
|
66GB?
|
|
|
Pro
|
25GB
|
166GB
|
|
|
Pro+
|
52GB
|
225GB
|
|
GPU模式下会话数量
|
标准RAM
|
高RAM
|
后台运行
|
|
|---|---|---|---|
|
免费
|
1
|
|
|
|
Pro
|
2
|
1
|
|
|
Pro+
|
3
|
3
|
2(无论是否高RAM)
|
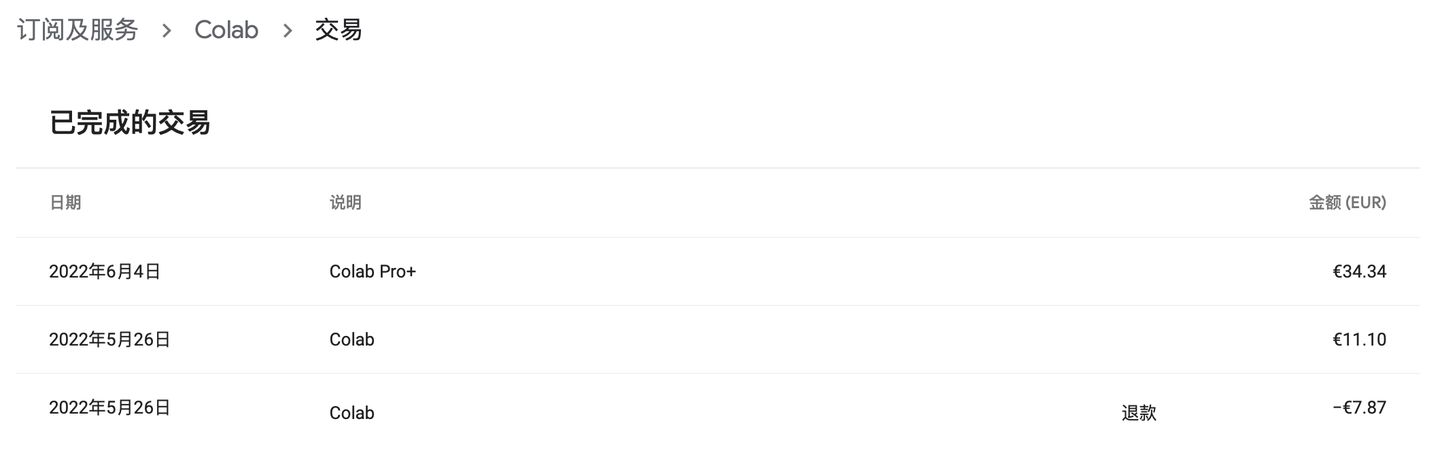
使用Pro/Pro+的个人感受
七、补充内容
如何让代码有“断点续传”的能力?
def save_checkpoint(path: Text,

                    epoch: int,

                    modules: Union[nn.Module, Sequence[nn.Module]],

                    optimizers: Union[opt.Optimizer, Sequence[opt.Optimizer]],

                    safe_replacement: bool = True):

    """

    Save a checkpoint of the current state of the training, so it can be resumed.

    This checkpointing function assumes that there are no learning rate schedulers or gradient scalers for automatic

    mixed precision.

    :param path:

        Path for your checkpoint file

    :param epoch:

        Current (completed) epoch

    :param modules:

        nn.Module containing the model or a list of nn.Module objects

    :param optimizers:

        Optimizer or list of optimizers

    :param safe_replacement:

        Keep old checkpoint until the new one has been completed

    :return:

    """

    # This function can be called both as

    # save_checkpoint('/my/checkpoint/path.pth', my_epoch, my_module, my_opt)

    # or

    # save_checkpoint('/my/checkpoint/path.pth', my_epoch, [my_module1, my_module2], [my_opt1, my_opt2])

    if isinstance(modules, nn.Module):

        modules = [modules]

    if isinstance(optimizers, opt.Optimizer):

        optimizers = [optimizers]

    # Data dictionary to be saved

    data = {

        'epoch': epoch,

        # Current time (UNIX timestamp)

        'time': time.time(),

        # State dict for all the modules

        'modules': [m.state_dict() for m in modules],

        # State dict for all the optimizers

        'optimizers': [o.state_dict() for o in optimizers]

    }

    # Safe replacement of old checkpoint

    temp_file = None

    if os.path.exists(path) and safe_replacement:

        # There's an old checkpoint. Rename it!

        temp_file = path + '.old'

        os.rename(path, temp_file)

    # Save the new checkpoint

    with open(path, 'wb') as fp:

        torch.save(data, fp)

        # Flush and sync the FS

        fp.flush()

        os.fsync(fp.fileno())

    # Remove the old checkpoint

    if temp_file is not None:

        os.unlink(path + '.old')

def load_checkpoint(path: Text,

                    default_epoch: int,

                    modules: Union[nn.Module, Sequence[nn.Module]],

                    optimizers: Union[opt.Optimizer, Sequence[opt.Optimizer]],

                    verbose: bool = True):

    """

    Try to load a checkpoint to resume the training.

    :param path:

        Path for your checkpoint file

    :param default_epoch:

        Initial value for "epoch" (in case there are not snapshots)

    :param modules:

        nn.Module containing the model or a list of nn.Module objects. They are assumed to stay on the same device

    :param optimizers:

        Optimizer or list of optimizers

    :param verbose:

        Verbose mode

    :return:

        Next epoch

    """

    if isinstance(modules, nn.Module):

        modules = [modules]

    if isinstance(optimizers, opt.Optimizer):

        optimizers = [optimizers]

    # If there's a checkpoint

    if os.path.exists(path):

        # Load data

        data = torch.load(path, map_location=next(modules[0].parameters()).device)

        # Inform the user that we are loading the checkpoint

        if verbose:

            print(f"Loaded checkpoint saved at {datetime.fromtimestamp(data['time']).strftime('%Y-%m-%d %H:%M:%S')}. "

                  f"Resuming from epoch {data['epoch']}")

        # Load state for all the modules

        for i, m in enumerate(modules):

            modules[i].load_state_dict(data['modules'][i])

        # Load state for all the optimizers

        for i, o in enumerate(optimizers):

            optimizers[i].load_state_dict(data['optimizers'][i])

        # Next epoch

        return data['epoch'] + 1

    else:

        return default_epoch
在主程序train.py正式开始训练前,添加下面的语句:
if args.resume: # args.resume是命令行输入的参数,用于指示要不要加载上次训练的结果

    first_epoch = load_checkpoint(checkpoint_path, first_epoch, net_list, optims_list)
# Save checkpoint

save_checkpoint(checkpoint_path, epoch, net_list, optims_list)
如果分到了Tesla T4怎么办?
结语:一不留神写了一万多字了!希望这个超详细的Colab教程能对大家有所帮助,大家要是发现了什么新的技巧欢迎在评论区留言~
Colab教程(超级详细版)及Colab Pro/Colab Pro+使用评测的更多相关文章
- 手把手Maven搭建SpringMVC+Spring+MyBatis框架(超级详细版)
手把手Maven搭建SpringMVC+Spring+MyBatis框架(超级详细版) SSM(Spring+SpringMVC+Mybatis),目前较为主流的企业级架构方案.标准的MVC设计模式, ...
- CentOS 6.4 服务器版安装教程(超级详细图解)
附:CentOS 6.4下载地址 32位:http://mirror.centos.org/centos/6.4/isos/i386/CentOS-6.4-i386-bin-DVD1to2.torre ...
- caffe学习--使用caffe中的imagenet对自己的图片进行分类训练(超级详细版) -----linux
http://blog.csdn.net/u011244794/article/details/51565786 标签: caffeimagenet 2016-06-02 12:57 9385人阅读 ...
- VMware Workstation 12 Pro安装CentOs图文教程(超级详细)
本文记录了VMware Workstation 12 Pro安装CentOs的整个过程,具体如下: VMware Workstation 12: CENTOS 6.4 : 创建虚拟机 1.首先安装好V ...
- CentOS 服务器版安装教程(超级详细图解)
使用安装说明:http://www.jb51.net/os/85895.html
- Navicate12激活教程(完整详细版)
写在前面 最近身边的小伙伴苦于没有Navicat12的激活工具,不能使用最新版的Navicat,鉴于此,遂将自己整理的文章贴出来,供大家参考,不过个人还是主张维护正版的意愿,如果经济实力允许的话,还是 ...
- Windows 10 + kali Linux 双系统安装教程(详细版)
准备工具如下: kali Linux 镜像 准备一4G以上的U盘 制作U盘启动盘工具- Win32DiskImager 添加引导工具-EasyBCD 留出一个空的盘,哪个盘的空间比较大可以压缩出大概2 ...
- hexo+github搭建博客(超级详细版,精细入微)
# 前言 你了解[Hexo]( https://hexo.io/zh-cn/ "Hexo官网")吗? Hexo是一个静态博客框架,基于Node.js,将Markdown文章通过渲染 ...
- cnpm的安装(超级详细版)
1. 安装node 打开黑窗口 安装node 网上教程很多,我就不加上了 2.node -v 查看node是否已安装 3.安装淘宝镜像 npm install -g cnpm -registry ...
随机推荐
- 基于express框架的留言板实现步骤
这个留言板是基于express框架,和ejs模板引擎,首先需要在根目录安装express框架,然后安装ejs模块和body-parser(获取用户表单提交的数据):建立项目目录 message,然后依 ...
- Java类型转换详解
Java类型转换详解 最近有同学问:自动类型转换老是记不住,到底是大转小,还是小转大 其实这个不用死记硬背,很好理解,我们拿 int 和 short 来举例: int 是 4 字节,也就是 32 bi ...
- ASMCMD-8102: no connection to Oracle ASM
通过ASMCMD命令连接ASM,Connected to an idle instance [root@shdb02 ~]# su - oracle [oracle@shdb02 ~]$ asmcmd ...
- windows10家庭版启用组策略gpedit.msc
启用组策略gpedit.msc 家庭版很多功能不能使用,凑巧用的就是家庭版. 还想使用gpedit.msc来关闭windows10的更新. 找到一个可行的方法. 需要创建一个脚本. 如果你没有编辑器, ...
- Java学习day34
注解(Annotation):是从JDK5.0开始引入的新技术: 作用:不是程序本身,可以对程序作出解释:可以被其他程序(比如编译器等)读取 格式:注解是以"@注释名"在代码中存在 ...
- HCNP Routing&Switching之组播技术PIM-SM 稀疏模式
前文我们了解了组播路由协议PIM以及PIM-DM密集模式相关话题,回顾请参考https://www.cnblogs.com/qiuhom-1874/p/16084310.html:今天我们来聊一聊PI ...
- Java语言学习day11--7月10日
今日内容介绍1.自定义类型的定义及使用2.自定义类的内存图3.ArrayList集合的基本功能4.随机点名器案例及库存案例代码优化 ###01引用数据类型_类 * A: 数据类型 * a: java中 ...
- Ubuntu 下 Apache2 和 PHP 服务器环境配置
Ubuntu 下 Apache2 和 PHP 服务器环境配置 1.简介 本文主要是 Ubuntu 下 Apache2 和 PHP 服务器环境配置方法,同样适用于 Debian 系统:Ubuntu 20 ...
- 使用钡铼BL102网关连接西门子S7-1200PLC 以及mosquitto服务器方法
一.软硬件描述 西门子PLC S7-1215 钡铼BL102网关 mosquitto MQTT服务器(腾讯云上搭建) 可以上网的路由器一套 二.需要使用的软件. 西门子Portal v15.1 (西门 ...
- oracle创建dblink注意事项 ORA-04052
BEGIN; oracle创建dblink语句: create database link dblink名称 connect to 用户名 identified by 密码 using '(DESCR ...