
ElasticSearch教程——分片、扩容以及容错机制(转学习使用)
一、Primary shard和replica shard机制
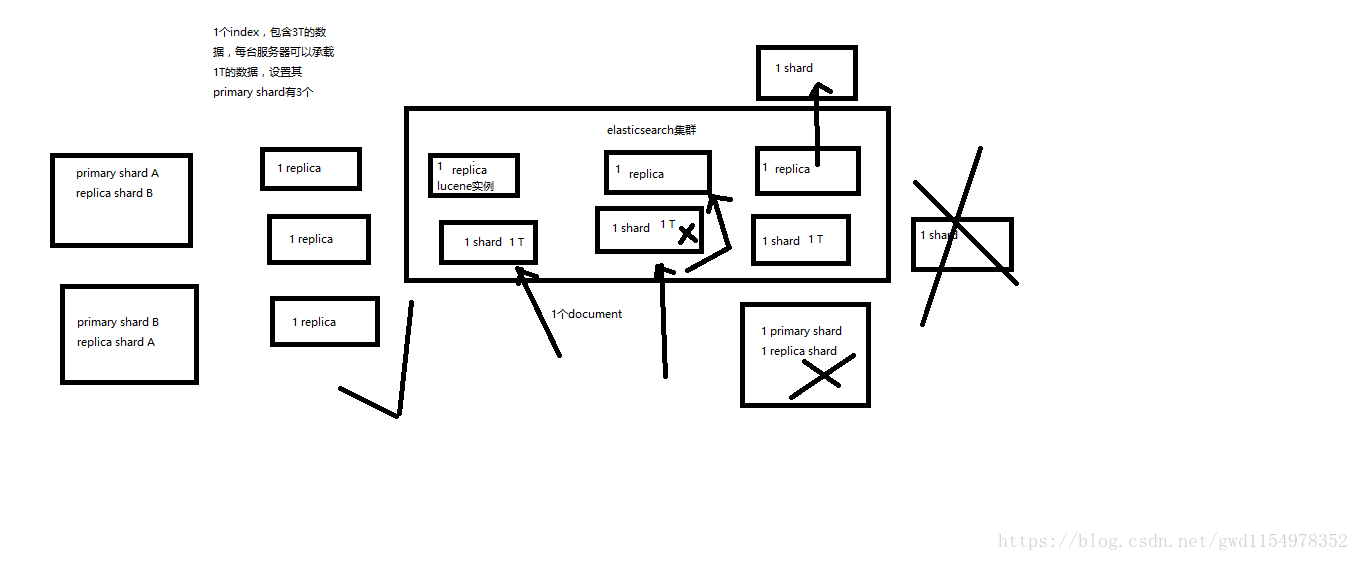
1、index包含多个shard;
2、每个shard都是一个最小的工作单元,承载部分的数据,Lucene实例,完整的简历索引和处理请求的能力;
3、增减节点时,shard会自动在nodes中负载均衡;
4、primary shard和replica shard,每一个document只会存在某一个primary shard以及其对应的replica shard中,不可能存在于多个primary shard中;
5、replica shard是primary shard的副本,负责容错,以及承担读请求负载(通常情况下可以让primary shard负责写,replica shard负责读,来实现读写分离)
6、primary shard的数量在创建的时候就固定了,replica shard的数量可以随时修改;
7、primary shard的默认数量是5,replica shard是1,默认有10个shard;其中5个primary shard以及5个replica shard;
8、primary shard和replica shard不能和自己的replica shard 放在一个节点中(这样规定是为避免节点宕机的时候,primary shard和replica shard数据都都丢失,起不到容错的作用),但是可以和其他的primary shard的replica shard放在同一个节点中;
三、性能扩容
就像上面说的primary shard 在创建的时候就已经固定了,不可以再修改。也就是说如果我在创建的时候设置了primary shard是3(6个shard,3 primary,3 replica),最多扩容到6台机器,每个shard可以占用单台服务器的所有资源,性能最好。那如果我们的超出了上面所说的扩容极限了怎么办呢?primary shard不是不能修改么?
是的,primary shard 在创建后是不能修改的,但是replica shard可以添加啊,我们可以创建9个shard(3primary,6 replica),将服务器扩容到9台机器,吞吐量会大大增加,是3台服务器的三倍,当然为了提高容错率也可以在此基础上在每台服务器上部署多个shard(primary和replica不能在同一台服务器上)
四、容量扩容
上述的扩容指的是性能上的扩容(即高可用),但是在实际生活中可能会面临需要内存上扩容,他的极限就是每个primary shard部署单台服务器(3个primary shard分别部署3台服务器),所以在创建的时候自己要注意创建primary shard的数量,如果内存上问题还是不能解决,那么就需要通过扩容磁盘和定期清理数据来解决内存问题了
五、容错机制
master node宕机后,会自动重新选举master,此时为red;
replica容错:新master是将replica提升为primary shard,此时为yellow(因为replica被升级为primary了,此时replica并不齐全);
重启宕机node,master copy replica到该node,但是该node使用原有的shard并同步宕机后的修改(即仅同步宕机后丢失的数据),此时为green;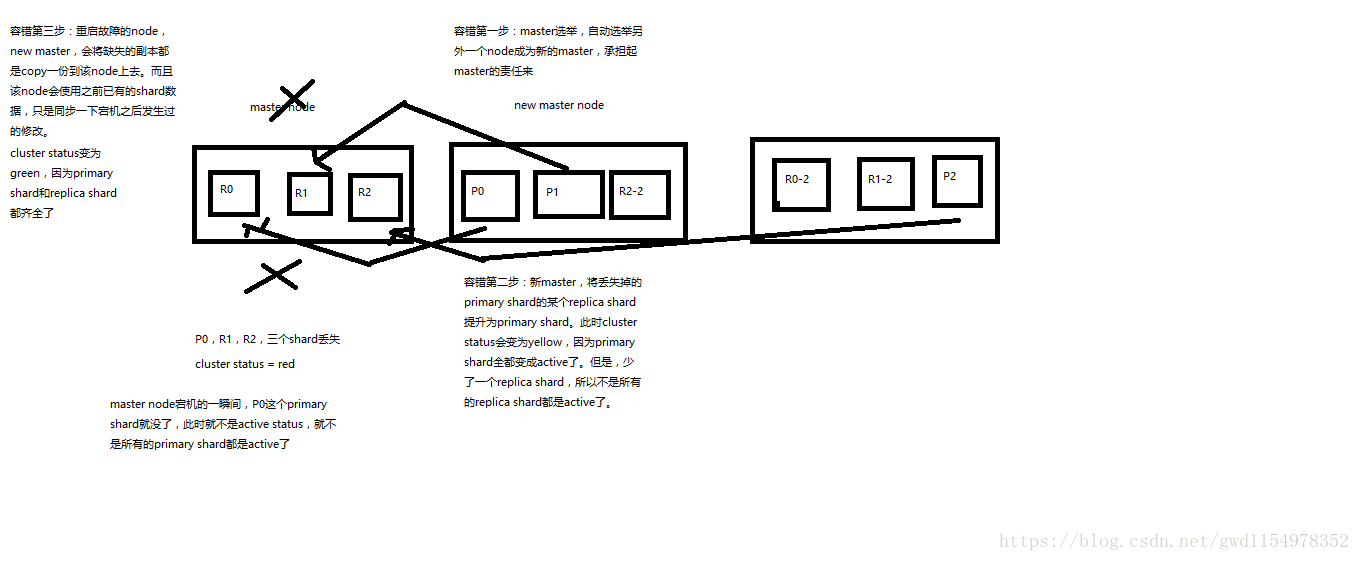
!
ElasticSearch教程——分片、扩容以及容错机制(转学习使用)的更多相关文章
- Elasticsearch由浅入深(二)ES基础分布式架构、横向扩容、容错机制
Elasticsearch的基础分布式架构 Elasticsearch对复杂分布式机制的透明隐藏特性 Elasticsearch是一套分布式系统,分布式是为了应对大数据量. Elasticsearch ...
- Elasticsearch 横向扩容以及容错机制
写在前面的话:读书破万卷,编码如有神-------------------------------------------------------------------- 参考内容: <Ela ...
- ElasticSearch教程——filter与query对比(转学习使用)
一.数据准备 PUT /company/employee/2 { "address": { "country": "china", &quo ...
- Elasticsearch和HDFS 容错机制 备忘
1.Elasticsearch 横向扩容以及容错机制http://www.bubuko.com/infodetail-2499254.html 2.HDFS容错机制详解https://www.cnbl ...
- (转)ElasticSearch教程——汇总篇
https://blog.csdn.net/gwd1154978352/article/details/82781731 环境搭建篇 ElasticSearch教程——安装 ElasticSearch ...
- ElasticSearch 分布式及容错机制
1 ElasticSearch分布式基础 1.1 ES分布式机制 分布式机制:Elasticsearch是一套分布式的系统,分布式是为了应对大数据量.它的特性就是对复杂的分布式机制隐藏掉. 分片机制: ...
- elasticsearch从入门到出门-08-Elasticsearch容错机制:master选举,replica容错,数据恢复
假如: 9 shard,3 node Elasticsearch容错机制:master选举,replica容错,数据恢复 最佳分配情况: 这样分配之后,不管其中哪个node 宕机这个es 依然可以提供 ...
- 第二章·Elasticsearch内部分片及分片处理机制介绍
一.副本分片介绍 什么是副本分片? 副本分片的主要目的就是为了故障转移,如果持有主分片的节点挂掉了,一个副本分片就会晋升为主分片的角色. 在索引写入时,副本分片做着与主分片相同的工作.新文档首先被索引 ...
- 总结Flink状态管理和容错机制
本文来自8月11日在北京举行的 Flink Meetup会议,分享来自于施晓罡,目前在阿里大数据团队部从事Blink方面的研发,现在主要负责Blink状态管理和容错相关技术的研发. 本文主要内容如 ...
随机推荐
- java springboot@GeneratedValue 注解
springboot中@GeneratedValue作用: (1)@GeneratedValue注解存在的意义主要就是为一个实体生成一个唯一标识的主键.@GeneratedValue提供了主键的生成策 ...
- Flutter开发实战笔记
下载 https://flutter.cn/docs/get-started/install/macos#get-sdk 配置环境变量 export PATH="$PATH:[PATH_TO ...
- 图 Graph
本文主要内容为:图的定义以及基本术语 图的定义 图 图G的组成:由 数据元素的集合E 和 数据间的关系集合E 组成,记作:G = <V, E> 顶点 (vertex):数据元素,V就是顶点 ...
- 【Dotnet9-01】从0开始搭建开源项目-lqclass.com
行文目录 一. 前言 1.1 我的现有网站 1.2 想法:新开发一个网站 1.3 目前开发计划 二. 行动了 2.1 Github创建项目 2.2 使用 WTM 搭建后台框架 2.3 项目演示 2.4 ...
- 用STM32定时器测量信号频率——测频法和测周法[原创cnblogs.com/helesheng]
工业测试与控制系统中,经常需要对未知信号的频率进行测试.对于10MHz以下的信号,用单片机(MCU)定时器完成这项任务显然是最常见和最佳的选择.目前性价比最高的单片机STM32拥有功能强大且数量众多的 ...
- 第 2 篇Scrum 冲刺博客
每天举行会议 会议照片: 昨天已完成的工作与今天计划完成的工作及工作中遇到的困难: 成员姓名 昨天完成工作 今天计划完成的工作 工作中遇到的困难 蔡双浩 完成修改个人信息剩余部分 了解任务,并做相关学 ...
- SPFA算法优化
前言 \(SPFA\) 通常在稀疏图中运行效率高于 \(Dijkstra\) ,但是也容易被卡. 普通的 \(SPFA\) 时间复杂度为 \(O(km)\) ,其中 \(k\) 是一条边松弛其端点点的 ...
- 介质访问控制子层-Medium Access Control Sublayer:多路访问协议、以太网、无线局域网
第四章 介质访问控制子层-Medium Access Control Sub-layer 4.1介质访问控制子层概述 MAC子层不属于之前提到的OSI或TCP/IP架构的任何一层,这也是为什么这一层被 ...
- 本文帮你在 Unix 下玩转 C 语言
shell是一种特殊的应用程序(命令行解释器),他为运行其他应用程序提供了一个接口. posix规范了操作系统是什么样 每个进程都有一个工作目录(又叫当前目录),相对路径都是从工作目录开始解释. Ct ...
- Bootstrap留言板界面练习
<!DOCTYPE html> <html> <head> <meta charset="utf-8"> <title> ...