
Python如何爬取实时变化的WebSocket数据
一、前言
作为一名爬虫工程师,在工作中常常会遇到爬取实时数据的需求,比如体育赛事实时数据、股市实时数据或币圈实时变化的数据。如下图:


Web 领域中,用于实现数据'实时'更新的手段有轮询和 WebSocket 这两种。轮询指的是客户端按照一定时间间隔(如 1 秒)访问服务端接口,从而达到 '实时' 的效果,虽然看起来数据像是实时更新的,但实际上它有一定的时间间隔,并不是真正的实时更新。轮询通常采用 拉 模式,由客户端主动从服务端拉取数据。
WebSocket 采用的是 推 模式,由服务端主动将数据推送给客户端,这种方式是真正的实时更新。
二、什么是 WebSocket
WebSocket是一种在单个TCP连接上进行全双工通信的协议。它使得客户端和服务器之间的数据交换变得更加简单,允许服务端主动向客户端推送数据。在WebSocket API中,浏览器和服务器只需要完成一次握手,两者之间就直接可以创建持久性的连接,并进行双向数据传输。
WebSocket 优点
- 较少的控制开销:只需要进行一次握手,携带一次请求头信息即可,后续只传输数据即可,相比 HTTP 每次请求都携带请求头,WebSocket 非常省资源。
- 更强的实时性:由于服务器可以主动推送消息,这使得延迟变得可以忽略不计,相比 HTTP 轮询的时间间隔,WebSocket 可以在相同的时间内进行多次传输。
- 二进制支持:WebSocket 支持二进制帧,这意味着传输更节省。
- ……
爬虫面对 HTTP 和 WebSocket
Python 中的网络请求库非常多,Requests 是最常用的请求库之一,它可以模拟发送网络请求。但是这些请求都是基于 HTTP 协议的。在面对 WebSocket 的时候 Requests 就发挥不料作用了,必须使用能够连接 WebSocket 的库。
三、爬取思路
这里以莱特币官网 http://www.laiteb.com/ 实时数据为例。WebSocket 的握手只发生一次,所以如果需要通过浏览器开发者工具观察网络请求,则需要在打开页面的情况下,打开浏览器开发者工具,定位到 NewWork 选项卡,并输入或刷新当前页面,才能观察到 WebSocket 的握手请求和数据传输情况。这里以 Chrome 浏览器为例:

在开发者工具中提供了筛选功能,其中 WS 选项代表只显示 WebSocket 连接的网络请求。
这时候可以看到请求记录列表中有一条名为 realTime 的记录,鼠标左键点击它后,开发者工具会分为左右两栏,右侧列出本条请求记录的详细信息:

与 HTTP 请求不同的是,WebSocket 连接地址以 ws 或 wss 开头。连接成功的状态码不是 200,而是 101。
Headers 标签页记录的是 Request 和 Response 信息,而 Frames 标签页中记录的则是双方互传的数据,也是我们需要爬取的数据内容:

Frames 图中绿色箭头向上的数据是客户端发送给服务端的数据,橙色箭头向下的数据是服务端推送给客户端的数据。
从数据顺序中可以看到,客户端先发送:
{"action":"subscribe","args":["QuoteBin5m:14"]}
然后服务端才会推送信息(一直推送):
{"group":"QuoteBin5m:14","data":[{"low":"55.42","high":"55.63","open":"55.42","close":"55.59","last_price":"55.59","avg_price":"55.5111587372932781077","volume":"40078","timestamp":1551941701,"rise_fall_rate":"0.0030674846625766871","rise_fall_value":"0.17","base_coin_volume":"400.78","quote_coin_volume":"22247.7621987324"}]}
所以,从发起握手到获得数据的整个流程为:

那么,现在问题来了:
- 握手怎么弄?
- 连接保持怎么弄?
- 消息发送和接收怎么弄?
- 有什么库可以轻松实现吗?
四、aiowebsocket
Python 库中用于连接 WebSocket 的有很多,但是易用、稳定的有 websocket-client(非异步)、websockets(异步)、aiowebsocket(异步)。
可以根据项目需求选择三者之一,今天介绍的是异步 WebSocket 连接客户端 aiowebsocket。其 Github 地址为:https://github.com/asyncins/aiowebsocket。
ReadMe中介绍到: AioWebSocket是一个遵循 WebSocket 规范的 异步 WebSocket 客户端,相对于其他库它更轻、更快。
它的安装和其他库一样简单,使用 pip install aiowebsocket 即可。安装好后,我们可以根据 ReadMe 中提供的示例代码来测试:
import asyncio

import logging

from datetime import datetime

from aiowebsocket.converses import AioWebSocket

async def startup(uri):

    async with AioWebSocket(uri) as aws:

        converse = aws.manipulator

        message = b'AioWebSocket - Async WebSocket Client'

        while True:

            await converse.send(message)

            print('{time}-Client send: {message}'

                  .format(time=datetime.now().strftime('%Y-%m-%d %H:%M:%S'), message=message))

            mes = await converse.receive()

            print('{time}-Client receive: {rec}'

                  .format(time=datetime.now().strftime('%Y-%m-%d %H:%M:%S'), rec=mes))

if __name__ == '__main__':

    remote = 'ws://echo.websocket.org'

    try:

        asyncio.get_event_loop().run_until_complete(startup(remote))

    except KeyboardInterrupt as exc:

        logging.info('Quit.')
运行后的结果输出为:
2019-03-07 15:43:55-Client send: b'AioWebSocket - Async WebSocket Client'

2019-03-07 15:43:55-Client receive: b'AioWebSocket - Async WebSocket Client'

2019-03-07 15:43:55-Client send: b'AioWebSocket - Async WebSocket Client'

2019-03-07 15:43:56-Client receive: b'AioWebSocket - Async WebSocket Client'

2019-03-07 15:43:56-Client send: b'AioWebSocket - Async WebSocket Client'

……
send 表示客户端向服务端发送的消息
recive 表示服务端向客户端推送的消息
五、编码获取数据
回到这一次的爬取需求,目标网站是莱特币官网:

从刚才的网络请求记录中,我们得知目标网站的 WebSocket 地址为:wss://api.bbxapp.vip/v1/ifcontract/realTime,从地址中可以看出目标网站使用的是 wss,也就是 ws 的安全版,它们的关系跟 HTTP/HTTPS 一样。aiowebsocket 会自动处理并识别 ssl,所以我们并不需要作额外的操作,只需要将目标地址赋值给连接 uri 即可:
import asyncio

import logging

from datetime import datetime

from aiowebsocket.converses import AioWebSocket

async def startup(uri):

    async with AioWebSocket(uri) as aws:

        converse = aws.manipulator

        while True:

            mes = await converse.receive()

            print('{time}-Client receive: {rec}'

                  .format(time=datetime.now().strftime('%Y-%m-%d %H:%M:%S'), rec=mes))

if __name__ == '__main__':

    remote = 'wss://api.bbxapp.vip/v1/ifcontract/realTime'

    try:

        asyncio.get_event_loop().run_until_complete(startup(remote))

    except KeyboardInterrupt as exc:

        logging.info('Quit.')
运行代码后观察输出,你会发现什么都没有发生。既没有内容输出,也没有断开连接,程序一直在运行,但是什么都没有:

这是为什么呢?
是对方不接受我方的请求吗?
还是有什么反爬虫限制呢?
实际上,刚才的流程图可以解释这个问题:

整个流程中有一步是需要客户端给服务端发送指定的消息,服务端验证后才会不停推送数据。所以,应该在消息读取前、握手连接后加上消息发送的代码:
import asyncio

import logging

from datetime import datetime

from aiowebsocket.converses import AioWebSocket

async def startup(uri):

    async with AioWebSocket(uri) as aws:

        converse = aws.manipulator

        # 客户端给服务端发送消息

        await converse.send('{"action":"subscribe","args":["QuoteBin5m:14"]}')

        while True:

            mes = await converse.receive()

            print('{time}-Client receive: {rec}'

                  .format(time=datetime.now().strftime('%Y-%m-%d %H:%M:%S'), rec=mes))

if __name__ == '__main__':

    remote = 'wss://api.bbxapp.vip/v1/ifcontract/realTime'

    try:

        asyncio.get_event_loop().run_until_complete(startup(remote))

    except KeyboardInterrupt as exc:

        logging.info('Quit.')
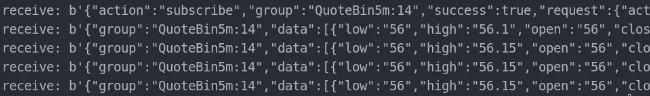
保存后运行,就会看到数据源源不断的推送过来:
到这里,爬虫就能够获取到想要的数据了。
aiowebsocket 做了什么
代码不长,使用的时候只需要将目标网站 WebSocket 地址填入,然后按照流程发送数据即可,那么 aiowebsocket 在这个过程中做了什么呢?
- 首先,aiowebsocket 根据 WebSocket 地址,向指定的服务端发送握手请求,并校验握手结果。
- 然后,在确认握手成功后,将数据发送给服务端。
- 整个过程中为了保持连接不断开,aiowebsocket 会自动与服务端响应 ping pong。
- 最后,aiowebsocket 读取服务端推送的消息
作者:夜幕奎因
Python如何爬取实时变化的WebSocket数据的更多相关文章
- Python如何爬取实时变化的WebSocket数据【华为云技术分享】
一.前言 作为一名爬虫工程师,在工作中常常会遇到爬取实时数据的需求,比如体育赛事实时数据.股市实时数据或币圈实时变化的数据.如下图: Web 领域中,用于实现数据'实时'更新的手段有轮询和 WebSo ...
- 爬取实时变化的 WebSocket 数据(转载)
本文转自:https://mp.weixin.qq.com/s/fuS3uDvAWOQBQNetLqzO-g 一.前言 作为一名爬虫工程师,在工作中常常会遇到爬取实时数据的需求,比如体育赛事实时数据. ...
- python爬虫爬取get请求的页面数据代码样例
废话不多说,上代码 #!/usr/bin/env python # -*- coding:utf-8 -*- # 导包 import urllib.request import urllib.pars ...
- Python scrapy爬取带验证码的列表数据
首先所需要的环境:(我用的是Python2的,可以选择python3,具体遇到的问题自行解决,目前我这边几百万的数据量爬取) 环境: Python 2.7.10 Scrapy Scrapy 1.5.0 ...
- Python爬虫爬取异步加载的数据
前言 本文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理.作者:努力努力再努力 爬取qq音乐歌手数据接口数据 https://y.qq ...
- Python:爬取中国各市的疫情数据并存储到数据库
import requests import pymysql import json def create(): # 连接数据库 db = pymysql.connect(host = 'localh ...
- Python+Selenium爬取动态加载页面(1)
注: 最近有一小任务,需要收集水质和水雨信息,找了两个网站:国家地表水水质自动监测实时数据发布系统和全国水雨情网.由于这两个网站的数据都是动态加载出来的,所以我用了Selenium来完成我的数据获取. ...
- Python爬虫|爬取喜马拉雅音频
"GOOD Python爬虫|爬取喜马拉雅音频 喜马拉雅是知名的专业的音频分享平台,用户规模突破4.8亿,汇集了有声小说,有声读物,儿童睡前故事,相声小品等数亿条音频,成为国内发展最快.规模 ...
- 大神:python怎么爬取js的页面
大神:python怎么爬取js的页面 可以试试抓包看看它请求了哪些东西, 很多时候可以绕过网页直接请求后面的API 实在不行就上 selenium (selenium大法好) selenium和pha ...
随机推荐
- 虚拟机操作系统内设置固定IP以及克隆虚拟机
以下为我自己整理的克隆虚拟机和设置固定IP的方法,记录一下,以防忘记: 桥接模式网络配置 1.配置ip地址等信息在/etc/sysconfig/network-scripts/ifcfg-ens33文 ...
- Vim 便捷 | 自己的Vim
在.vimrc中安排自己的Vim set softtabstop=4 "将连续数量的空格视为一个制表符 set shiftwidth=4 "自动缩进所使用的空白数 set auto ...
- 46 Linden Street ACT I
Execute me. My name is Richard Stewart. I’m a photographer. May I take a picture of you and your lit ...
- 创建linux系统下的虚拟机
1.打开VMware软件 2.创建新的虚拟机 3.下一步 4.点击 稍后安装操作系统——下一步 5.选择 其中版本 我的镜像是这个版本所以选择这个 6.下一步 设置虚拟机名称 要保存的位置 7 ...
- 201871010114-李岩松《面向对象程序设计(java)》第四周学习总结
项目 内容 这个作业属于哪个课程 https://www.cnblogs.com/nwnu-daizh/ 这个作业的要求在哪里 https://www.cnblogs.com/nwnu-daizh/p ...
- 领扣(LeetCode)字母大小写全排列 个人题解
给定一个字符串S,通过将字符串S中的每个字母转变大小写,我们可以获得一个新的字符串.返回所有可能得到的字符串集合. 示例: 输入: S = "a1b2" 输出: ["a1 ...
- SpringBoot系列之切换log4j日志框架
SpringBoot系列之使用切换log4j日志框架 ok,在pom文件右键->Diagrams->show Dependencies....,如图,找到spring-boot-start ...
- JS三座大山再学习(二、作用域和闭包)
原文地址 作用域 JS中有两种作用域:全局作用域|局部作用域 栗子1 console.log(name); //undefined var name = '波妞'; var like = '宗介' c ...
- go中的关键字-go(上)
1. goroutine的使用 在Go语言中,表达式go f(x, y, z)会启动一个新的goroutine运行函数f(x, y, z),创建一个并发任务单元.即go关键字可以用来开启一个gorou ...
- 快速搭建 SpringCloud 微服务开发环境的脚手架
本文适合有 SpringBoot 和 SpringCloud 基础知识的人群,跟着本文可使用和快速搭建 SpringCloud 项目. 本文作者:HelloGitHub-秦人 HelloGitHub ...