
python 爬虫时遇到问题及解决
源代码:
#unicoding=utf-8
import re
import urllib
def gethtml(url):
html=urllib.urlopen(url)
page=html.read()
return page
def img(page):
reg=r'src="(.+?\jpg)" alt'
imgre=re.compile(reg)
imglist=re.findall(imgre,page)
x=0
for imgurl in imglist:
urllib.urlretrieve(imgurl,'%s.jpg' % x)
x+=1
#page=gethtml("http://www.51tietu.net/tp/")
page=gethtml("http://mm.51tietu.net/qingchun/90/")
img(page)
这样执行的话,会出现IOError 大致意思时文件操作时,出现错误
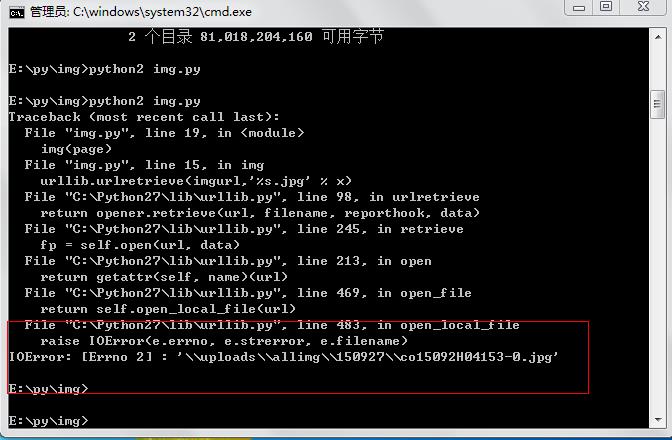
在这里可以看到IOError后跟着你抓取到的jip文件的路径,但是这个路径不是整个url的路径,所以才会在urlretrieve调用imgurl的时候报错。
去网站查看整个URL

因此可以根据图中的url进行修改代码, 想法:可以在urlretrieve中把url补完整,之后代码如下
#unicoding=utf-8
import re
import urllib
def gethtml(url):
html=urllib.urlopen(url)
page=html.read()
return page
def img(page):
reg=r'src="(.+?\jpg)" alt'
imgre=re.compile(reg)
imglist=re.findall(imgre,page)
x=0
for imgurl in imglist:
urllib.urlretrieve('http://mm.51tietu.net'+imgurl,'%s.jpg' % x)
x+=1
#page=gethtml("http://www.51tietu.net/tp/")
page=gethtml("http://mm.51tietu.net/qingchun/90/")
img(page)
之后再进行运行的话,就可以将图片爬取到本地了。
效果如下:

python 爬虫时遇到问题及解决的更多相关文章
- Python爬虫老是被封的解决方法【面试必问】
在爬取的过程中难免发生 ip 被封和 403 错误等等,这都是网站检测出你是爬虫而进行反爬措施,在这里为大家总结一下 Python 爬虫动态 ip 代理防止被封的方法. PS:另外很多人在学习Pyth ...
- python爬虫时,解决编码方式问题的万能钥匙(uicode,utf8,gbk......)
转载 原文:https://blog.csdn.net/xiongzaiabc/article/details/81008330 无论遇到的网页代码是何种编码方式,都可以用以下方法统一解决 imp ...
- Python 爬虫常见的坑和解决方法
1.请求时出现HTTP Error 403: Forbidden headers = {'User-Agent':'Mozilla/5.0 (Windows NT 6.1; WOW64; rv:23. ...
- python爬虫框架scrapy问题的解决
2016-09-24:今天的弄了一天的scrapy的环境的配置的,linux很多的学过的事情都忘记啦.理论和实践的结合还是非常的重要的,不光要学会思考,更要学会总结纪录.还要多多回忆的和复习.学习了不 ...
- Python爬虫技术:爬虫时如何知道是否代理ip伪装成功?
前言本文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. python爬虫时如何知道是否代理ip伪装成功: 有时候我们的爬虫程序添加了 ...
- Python爬虫:设置Cookie解决网站拦截并爬取蚂蚁短租
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: Eastmount PS:如有需要Python学习资料的小伙伴可以加 ...
- 从python爬虫引发出的gzip,deflate,sdch,br压缩算法分析
今天在使用python爬虫时遇到一个奇怪的问题,使用的是自带的urllib库,在解析网页时获取到的为b'\x1f\x8b\x08\x00\x00\x00\x00...等十六进制数字,尝试使用chard ...
- Python爬虫之xpath语法及案例使用
Python爬虫之xpath语法及案例使用 ---- 钢铁侠的知识库 2022.08.15 我们在写Python爬虫时,经常需要对网页提取信息,如果用传统正则表达去写会增加很多工作量,此时需要一种对数 ...
- python爬虫中文乱码解决方法
python爬虫中文乱码 前几天用python来爬取全国行政区划编码的时候,遇到了中文乱码的问题,折腾了一会儿,才解决.现特记录一下,方便以后查看. 我是用python的requests和bs4库来实 ...
随机推荐
- [Effective Modern C++] Item 3. Understand decltype - 了解decltype
条款三 了解decltype 基础知识 提供一个变量或者表达式,decltype会返回其类型,但是返回的内容会使人感到奇怪. 以下是一些简单的推断类型: ; // decltype(i) -> ...
- 浅说CPU并行计算与GPU并行计算
最近在学一门课,叫做“C++与并行计算”.要用到多CPU(进程)并行的原理,实现语言是C++的MPI接口.联想到上学期用到CUDA C/C++来做并行计算,就对这两门语言做一个总结,分享下自己关于并行 ...
- 安装完CentOS 7 Minimal之后,从头打造桌面工作环境
安装完CentOS 7 Minimal之后,从头打造桌面工作环境 U盘装CentOS 7 DVD版不能引导的解决办法 更改root密码 SSH登录 增加除root之外的常规用户 装完CentOS 7之 ...
- 期末考试--nyoj-757
期末考试 时间限制:1000 ms | 内存限制:65535 KB 难度:2 描述 马上就要考试了,小T有许多作业要做,而且每个老师都给出来了作业要交的期限,如果在规定的期限内没 交作业就会扣期末 ...
- SQL Server 创建全文索引
背景知识: 全文目录是全文索引是容器.所以在创建全文索引前要有全文目录. 第一步: 创建全文目录: create fulltext catalog catalog_name [on filegroup ...
- js 异步流程控制之 avQ(avril.queue)
废话前言 写了多年的js,遇到过最蛋疼的事情莫过于callback hell, 相信大家也感同身受. 业界许多大大也为此提出了很多不错的解决方案,我所了解的主要有: 朴灵 event proxy, 简 ...
- Jquery基础之ajax
ajax是Asynchronous JavaScript and XML(异步JavaScript和XML)的简称,ajax并不是单一的技术而是利用一系列交互网页应用相关的技术形成的结合体,ajax揭 ...
- HttpClient post 请求实例
所需jar包: commons-codec-1.3.jar commons-httpclient-3.0.jar commons-logging-1.1.1.jar /** * */ package ...
- linux下修改ip地址,默认网关以及DNS
*修改IP地址 即时生效: ifconfig eth0 192.168.1.100 netmask 255.255.255.0 重启生效: vim /etc/sysconfig/network-s ...
- 关于URL编码的问题
在进行WEB开发时,字符集编码常常困扰着我们.我们需要区分两种情况,一是URL编码,二是HTTP Body编码.这两种编码所处理的机制不同. URL编码和解码 客户端负责对URL编码,服务端负责解码. ...