
别再滥用scrapy CrawlSpider中的follow=True
对于刚接触scrapy的同学来说, crawlspider中的rule是比较难理解的, 很可能驾驭不住. 而且笔者在YouTube中看到许多公开的演讲都都错用了follow这一选项, 所以今天就来仔细谈一谈.
首先我们看scrapy中的follow是如何实现的:
# 为了方便理解, 去除了不必要代码

    def _requests_to_follow(self, response):

        """遍历rules, 使用rule提取response中的链接

            每个rule中提取的链接都会被添加到集合中

            相同的链接只会被提取一次, 也就是范围大的rule 会覆盖范围小的rule

            使用提取到的链接发送请求, 得到response

        """

        seen = set()

        for n, rule in enumerate(self._rules):

            links = [lnk for lnk in rule.link_extractor.extract_links(response)

                     if lnk not in seen]

            for link in links:

                seen.add(link)

                r = Request(url=link.url, callback=self._response_downloaded)

                yield r

    def _response_downloaded(self, response):

        rule = self._rules[response.meta['rule']]

        return self._parse_response(response, rule.callback, rule.cb_kwargs, rule.follow)
首先, 在我们的定义中rules是一系列Rule对象的集合, 示例如下:
rules = (

        Rule(LinkExtractor(allow=('category\.php', ), deny=('subsection\.php', ))),

        Rule(LinkExtractor(allow=('item\.php', )), callback='parse_item'),

    )
在源代码中, 我们可以看到:
- 遍历所有的Rule对象, 并使用其link_extractor属性提取链接
- 对于提取到的链接, 我们把它加入到一个集合中
- 使用链接发送一个请求, 并且callback的最终结果是self._parse_response
上述操作表明, 当我们follow一个链接时, 我们其实是用rules把这个链接返回的response再提取一遍.
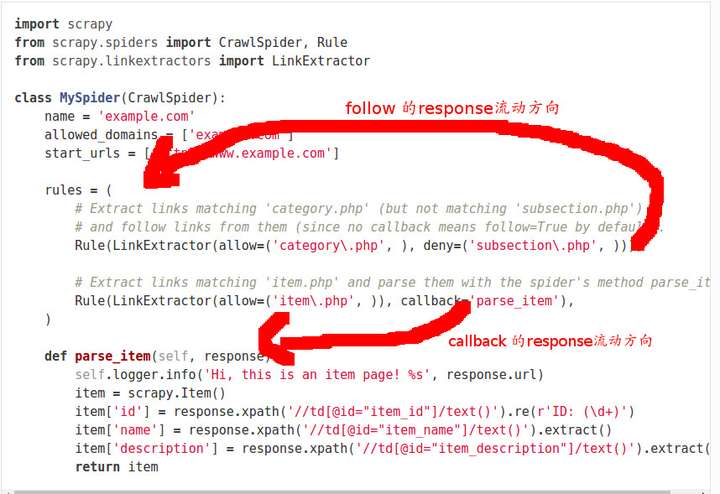
当我们需要对response进行进一步提取的时候我们才使用follow, 它会把response用rules过滤一遍, 产生新的response.
当我们的response包含有我们需要的信息是, 直接用callback提取信息.
不要滥用follow, 因为我们提取出来的链接都会被下载, 造成了不必要的请求.
其实源代码中还解释了文档中提到的关于rules顺序的问题:
Each Rule defines a certain behaviour for crawling the site. Rules objects are described below. If multiple rules match the same link, the first one will be used, according to the order they’re defined in this attribute.
多个Rule匹配同一个链接, 只有第一个Rule会被使用, 用源代码来解释就是我们匹配到了链接已经添加到set中去重了, 所以之后的匹配都无法添加. 所以我们在使用rules时, 如果两个Rule有交集, 要注意顺序.
别再滥用scrapy CrawlSpider中的follow=True的更多相关文章
- Scrapy框架中的CrawlSpider
小思考:如果想要通过爬虫程序去爬取”糗百“全站数据新闻数据的话,有几种实现方法? 方法一:基于Scrapy框架中的Spider的递归爬取进行实现(Request模块递归回调parse方法). 方法二: ...
- scrapy CrawlSpider解析
CrawlSpider继承自Spider, CrawlSpider主要用于有规则的url进行爬取. 先来说说它们的设计区别: SpiderSpider 类的设计原则是只爬取 start_urls 中的 ...
- scrapy -->CrawlSpider 介绍
scrapy -->CrawlSpider 介绍 1.首先,通过crawl 模板新建爬虫: scrapy genspider -t crawl lagou www.lagou.com 创建出来的 ...
- Python+Scrapy+Crawlspider 爬取数据且存入MySQL数据库
1.Scrapy使用流程 1-1.使用Terminal终端创建工程,输入指令:scrapy startproject ProName 1-2.进入工程目录:cd ProName 1-3.创建爬虫文件( ...
- 再谈SQL Server中日志的的作用
简介 之前我已经写了一个关于SQL Server日志的简单系列文章.本篇文章会进一步挖掘日志背后的一些概念,原理以及作用.如果您没有看过我之前的文章,请参阅: 浅谈SQL Server ...
- 用python随机生成数据,再插入到postgresql中
用python随机生成学生姓名,三科成绩和班级数据,再插入到postgresql中. 模块用psycopg2 random import random import psycopg2 fname=[' ...
- C++ Primer 学习笔记_43_STL实践与分析(17)--再谈迭代器【中】
STL实践与分析 --再谈迭代器[中] 二.iostream迭代[续] 3.ostream_iterator对象和ostream_iterator对象的使用 能够使用ostream_iterator对 ...
- Python爬虫从入门到放弃(十五)之 Scrapy框架中Spiders用法
Spider类定义了如何爬去某个网站,包括爬取的动作以及如何从网页内容中提取结构化的数据,总的来说spider就是定义爬取的动作以及分析某个网页 工作流程分析 以初始的URL初始化Request,并设 ...
- 一定要 先删除 sc表 中的 某元组 行,,, 再删除 course表中的 元组行
一定要 先删除 sc表 中的 某元组 行,,, 再删除 course表中的 元组行 course表 SC表 删除 course表中的 元组行,,出现错误 sc ---->参 ...
随机推荐
- CSS属性,可以完成99%的页面编写
border: border:4px dotted red; 宽度 样式 颜色 solid(实线) border-style: -none: ...
- 基于语音转录的ted演讲推荐
论文地址:https://arxiv.org/abs/1809.05350v1 二. 实现 我们从Kaggle[6]中获取了TED演讲数据集,其中包括2400个TED演讲的数据,包括标题.演讲者.标 ...
- 网络流——poj1273(入门)
题目链接:排水沟 题意:现有n个排水沟和m个点(其中1是源点,m是汇点),给定n个排水沟所连接的点,求从源点到汇点的最大流量. [EK解法] #include <algorithm> #i ...
- linux消息队列通信
IPC机制 进程间通信机制(Inter Process Communication,IPC),这些IPC机制的存在使UNIX在进程通信领域手段相当丰富,也使得程序员在开发一个由多个进程协作的任务组成的 ...
- Isolate-user-vlan技术白皮书
http://www.h3c.com.cn/Products___Technology/Technology/LAN/Other_technology/Technology_book/200804/6 ...
- Codeforces Round #518 Div. 1没翻车记
A:设f[i][j][0/1]为前i个数第i位为j且第i位未满足/已满足限制的方案数.大力dp前缀和优化即可. #include<iostream> #include<cstdio& ...
- [CF1077C]Good Array
题目大意:一个序列是好的当且仅当有一个数是其它所有数的和,问一个序列可以删掉哪个数变成好的序列.输出所有方案. 题解:发现等于其他数的和的那个数一定是其中最大的,只要排序一下(其实只要找到最大的两个数 ...
- [Leetcode] Remove duplicates from sorted array 从已排序的数组中删除重复元素
Given a sorted array, remove the duplicates in place such that each element appear only once and ret ...
- THUSC2014酱油记
Day0: 坐飞机到北京,然后报到...跟jason_yu分到一个房间,刚好可以蹭点RP.发现房间460RMB/晚,但再带一份早餐就500RMB,难道早餐是40RMB么...在一家川菜馆吃的午晚餐,感 ...
- SqlServer中临时表的应用
一.变通处理WHERE后面IN的参数过多 WHERE后面的条IN操作符里的参数比较小时,可以直接使用IN(1,2,3)这样处理,当个数不确定(可能超过1000)时,应该考虑使用临时表关联查询: SEL ...