
Python爬虫从入门到放弃(十五)之 Scrapy框架中Spiders用法
Spider类定义了如何爬去某个网站,包括爬取的动作以及如何从网页内容中提取结构化的数据,总的来说spider就是定义爬取的动作以及分析某个网页
工作流程分析
- 以初始的URL初始化Request,并设置回调函数,当该request下载完毕并返回时,将生成response,并作为参数传给回调函数. spider中初始的requesst是通过start_requests()来获取的。start_requests()获取 start_urls中的URL,并以parse以回调函数生成Request
- 在回调函数内分析返回的网页内容,可以返回Item对象,或者Dict,或者Request,以及是一个包含三者的可迭代的容器,返回的Request对象之后会经过Scrapy处理,下载相应的内容,并调用设置的callback函数
- 在回调函数内,可以通过lxml,bs4,xpath,css等方法获取我们想要的内容生成item
- 最后将item传递给Pipeline处理
我们以通过简单的分析源码来理解
我通常在写spiders下写爬虫的时候,我们并没有写start_requests来处理start_urls中的url,这是因为我们在继承的scrapy.Spider中已经写过了,我们可以点开scrapy.Spider查看分析
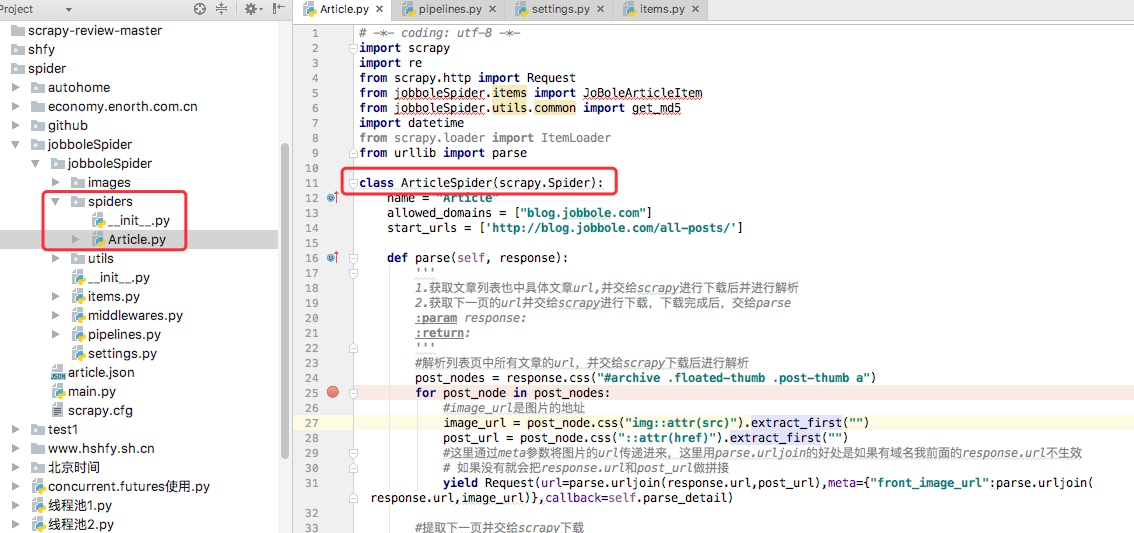
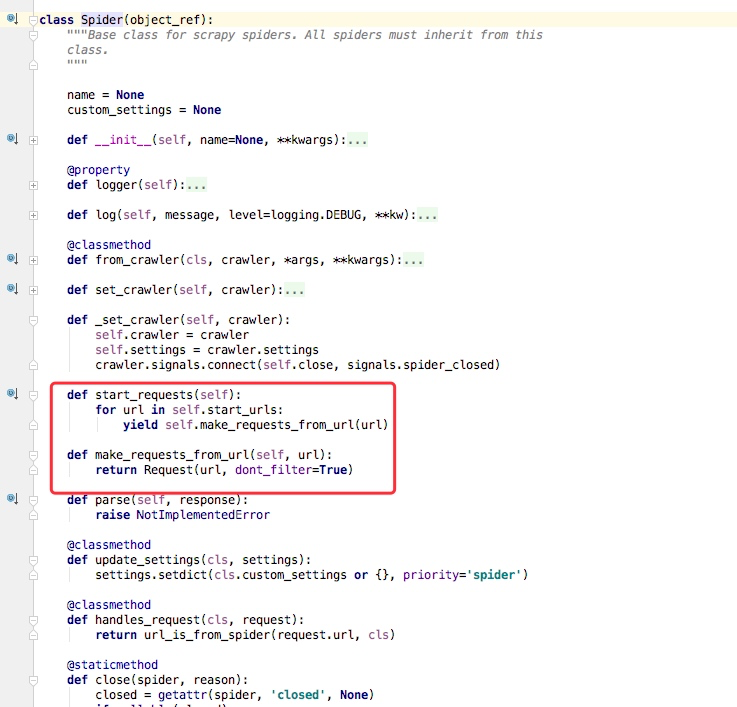
通过上述代码我们可以看到在父类里这里实现了start_requests方法,通过make_requests_from_url做了Request请求
如下图所示的一个例子,parse回调函数中的response就是父类列start_requests方法调用make_requests_from_url返回的结果,并且在parse回调函数中我们可以继续返回Request,如下属代码中yield Request()并设置回调函数。

spider内的一些常用属性
我们所有自己写的爬虫都是继承与spider.Spider这个类
name
定义爬虫名字,我们通过命令启动的时候用的就是这个名字,这个名字必须是唯一的
allowed_domains
包含了spider允许爬取的域名列表。当offsiteMiddleware启用时,域名不在列表中URL不会被访问
所以在爬虫文件中,每次生成Request请求时都会进行和这里的域名进行判断
start_urls
起始的url列表
这里会通过spider.Spider方法中会调用start_request循环请求这个列表中每个地址。
custom_settings
自定义配置,可以覆盖settings的配置,主要用于当我们对爬虫有特定需求设置的时候
设置的是以字典的方式设置:custom_settings = {}
from_crawler
这是一个类方法,我们定义这样一个类方法,可以通过crawler.settings.get()这种方式获取settings配置文件中的信息,同时这个也可以在pipeline中使用
start_requests()
这个方法必须返回一个可迭代对象,该对象包含了spider用于爬取的第一个Request请求
这个方法是在被继承的父类中spider.Spider中写的,默认是通过get请求,如果我们需要修改最开始的这个请求,可以重写这个方法,如我们想通过post请求
make_requests_from_url(url)
这个也是在父类中start_requests调用的,当然这个方法我们也可以重写
parse(response)
这个其实默认的回调函数
负责处理response并返回处理的数据以及跟进的url
该方法以及其他的Request回调函数必须返回一个包含Request或Item的可迭代对象
Python爬虫从入门到放弃(十五)之 Scrapy框架中Spiders用法的更多相关文章
- Python之爬虫从入门到放弃(十三) Scrapy框架整体的了解
这里是通过爬取伯乐在线的全部文章为例子,让自己先对scrapy进行一个整理的理解 该例子中的详细代码会放到我的github地址:https://github.com/pythonsite/spider ...
- Python之爬虫(十七) Scrapy框架中Spiders用法
Spider类定义了如何爬去某个网站,包括爬取的动作以及如何从网页内容中提取结构化的数据,总的来说spider就是定义爬取的动作以及分析某个网页 工作流程分析 以初始的URL初始化Request,并设 ...
- python爬虫从入门到放弃(五)之 正则的基本使用
什么是正则表达式 正则表达式是对字符串操作的一种逻辑公式,就是 事先定义好的一些特定字符.及这些特定字符的组合,组成一个"规则字符",这个"规则字符" 来表达对 ...
- python爬虫从入门到放弃(五)之 正则的基本使用(转)
什么是正则表达式 正则表达式是对字符串操作的一种逻辑公式,就是 事先定义好的一些特定字符.及这些特定字符的组合,组成一个“规则字符”,这个“规则字符” 来表达对字符的一种过滤逻辑. 正则并不是pyth ...
- 爬虫(十五):Scrapy框架(二) Selector、Spider、Downloader Middleware
1. Scrapy框架 1.1 Selector的用法 我们之前介绍了利用Beautiful Soup.正则表达式来提取网页数据,这确实非常方便.而Scrapy还提供了自己的数据提取方法,即Selec ...
- Python爬虫从入门到放弃(十二)之 Scrapy框架的架构和原理
这一篇文章主要是为了对scrapy框架的工作流程以及各个组件功能的介绍 Scrapy目前已经可以很好的在python3上运行Scrapy使用了Twisted作为框架,Twisted有些特殊的地方是它是 ...
- Python爬虫从入门到放弃(十八)之 Scrapy爬取所有知乎用户信息(上)
爬取的思路 首先我们应该找到一个账号,这个账号被关注的人和关注的人都相对比较多的,就是下图中金字塔顶端的人,然后通过爬取这个账号的信息后,再爬取他关注的人和被关注的人的账号信息,然后爬取被关注人的账号 ...
- python爬虫从入门到放弃前奏之学习方法
首谈方法 最近在整理爬虫系列的博客,但是当整理几篇之后,发现一个问题,不管学习任何内容,其实方法是最重要的,按照我之前写的博客内容,其实学起来还是很点枯燥不能解决传统学习过程中的几个问题: 这个是普通 ...
- Python爬虫从入门到放弃(十一)之 Scrapy框架整体的一个了解
这里是通过爬取伯乐在线的全部文章为例子,让自己先对scrapy进行一个整理的理解 该例子中的详细代码会放到我的github地址:https://github.com/pythonsite/spider ...
随机推荐
- 支付宝支付-常用支付API详解(查询、退款、提现等)
所有的接口支持沙盒环境的测试 1.前言 前面几篇文件详细介绍了 支付宝提现.扫码支付.条码支付.Wap支付.App支付 支付宝支付-提现到个人支付宝 支付宝支付-扫码支付 支付宝支付-刷卡支付(条码支 ...
- Vue.js中组件传参的方法 - 基于webpack模板
在Vuejs中, 组件之间的传参是今天第一次接触, 之前写的组件互相之间都是独立的, 弗敢专也, 必以分人 环境: node.js npm vue-cli 以上安装请自行百度 一.项目创建 $ vue ...
- js的addEvertLIstener方法
简介 “DOM2级事件”定义了两个方法,用于处理指定和删除事件处理程序的操作:addEventListener() 和 removeEventListener(). public override f ...
- 兼容ie浏览器的placeholder的几种方法
项目中遇到的问题,试了几种方法,今天整理出来,如果有不合适的地方,希望大家多多提意见. 第一种方法是:使用html新增的属性 “data-”来实现的,实现的时候,input框没有使用placehole ...
- Java中的系统时间
System.currentTimeMillis()产生一个当前的毫秒,这个毫秒其实就是自1970年1月1日0时起的毫秒数,Date()其实就是相当于Date(System.currentTimeMi ...
- GPU编程-Thread Hierarchy(3)
1. 如果处理的数据是二维的或者三维的,应该怎么办呢? 针对的,我们可以按照二维或者三维的方式,组织线程.老规矩,先代码.后解释 // Kernel definition __global__ voi ...
- 用C写一个web服务器(四) CGI协议
* { margin: 0; padding: 0 } body { font: 13.34px helvetica, arial, freesans, clean, sans-serif; colo ...
- spring管理配置文件的工厂类--PropertiesFactoryBean
使用这个工厂的配置,可以很方便的获取配置文件中的属性.具体使用如下; 对于属性配置,一般采用的是键值对的形式,如: key=value 属性配置文件一般使用的是XXX.properties,当然有时候 ...
- Phpcms·二次开发
PHPCMS V9产品介绍 PHPCMS V9(简称V9)采用PHP5+MYSQL做为技术基础进行开发.V9采用OOP(面向对象)方式进行基础运行框架搭建.模块化开发方式做为功能开发形式.框架易于功能 ...
- 解决jmeter请求不成功或者报403错误
有同学遇到这种情况,jmeter请求一个网站,各项参数填写正确,可是响应是403,同样的请求放在浏览器执行就没有问题: 这是因为被请求的网站做了请求来源过滤,来源不明的请求拒绝访问,我们需要在jmet ...