
初学Hadoop之WordCount词频统计
1、WordCount源码
将源码文件WordCount.java放到Hadoop2.6.0文件夹中。
import java.io.IOException;

import java.util.StringTokenizer;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.Mapper;

import org.apache.hadoop.mapreduce.Reducer;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

public class WordCount {

  public static class TokenizerMapper

       extends Mapper<Object, Text, Text, IntWritable>{

    private final static IntWritable one = new IntWritable(1);

    private Text word = new Text();

    public void map(Object key, Text value, Context context

                    ) throws IOException, InterruptedException {

      StringTokenizer itr = new StringTokenizer(value.toString());

      while (itr.hasMoreTokens()) {

        word.set(itr.nextToken());

        context.write(word, one);

      }

    }

  }

  public static class IntSumReducer

       extends Reducer<Text,IntWritable,Text,IntWritable> {

    private IntWritable result = new IntWritable();

    public void reduce(Text key, Iterable<IntWritable> values,

                       Context context

                       ) throws IOException, InterruptedException {

      int sum = 0;

      for (IntWritable val : values) {

        sum += val.get();

      }

      result.set(sum);

      context.write(key, result);

    }

  }

  public static void main(String[] args) throws Exception {

    Configuration conf = new Configuration();

    Job job = Job.getInstance(conf, "word count");

    job.setJarByClass(WordCount.class);

    job.setMapperClass(TokenizerMapper.class);

    job.setCombinerClass(IntSumReducer.class);

    job.setReducerClass(IntSumReducer.class);

    job.setOutputKeyClass(Text.class);

    job.setOutputValueClass(IntWritable.class);

    FileInputFormat.addInputPath(job, new Path(args[0]));

    FileOutputFormat.setOutputPath(job, new Path(args[1]));

    System.exit(job.waitForCompletion(true) ? 0 : 1);

  }

}
2、编译源码
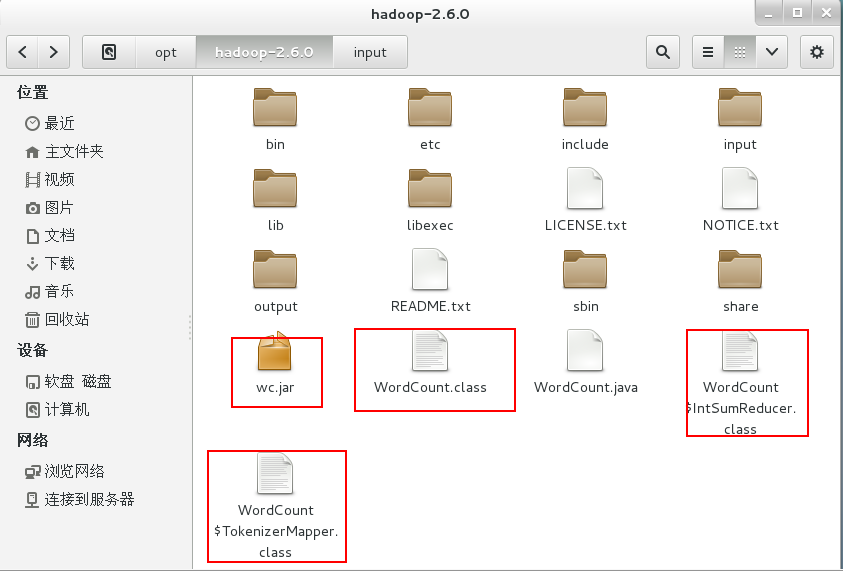
$ bin/hadoop com.sun.tools.javac.Main WordCount.java  #将WordCount.java编译成三个.class文件

$ jar cf wc.jar WordCount*.class #将三个.class文件打包成jar文件
3、运行
新建input文件夹,用于存放需要统计的文本。
cd /opt/hadoop-2.6.0

mkdir input
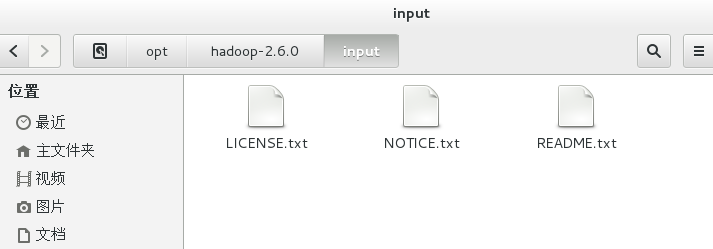
复制hadoop-2.6.0文件夹下的txt文件到input文件夹下。
cp *.txt /opt/hadoop-2.6.0/input
运行命令。
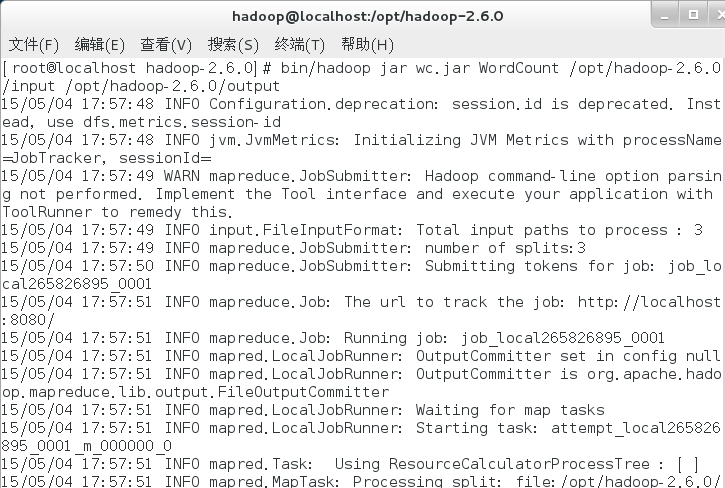
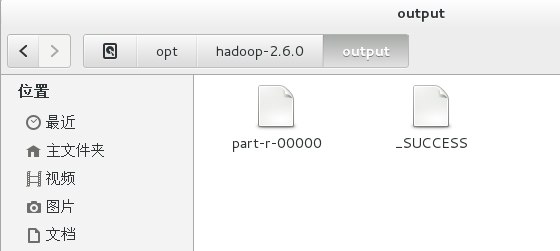
bin/hadoop jar wc.jar WordCount /opt/hadoop-2.6.0/input /opt/hadoop-2.6.0/output #自动生成output文件夹,用于存放分词统计结果。
4、查看结果
bin/hdfs dfs -cat /opt/hadoop-2.6.0/output/part-r-00000
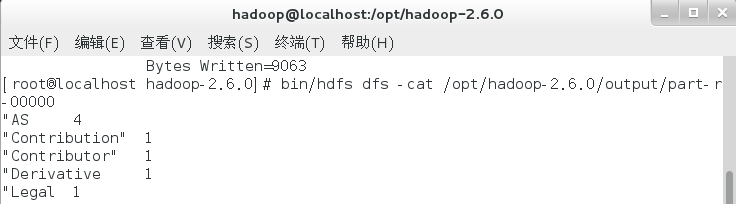
至此,WordCount词频统计运行成功,Hadoop单机模式环境搭建成功。
初学Hadoop之WordCount词频统计的更多相关文章
- 初学Hadoop之中文词频统计
1.安装eclipse 准备 eclipse-dsl-luna-SR2-linux-gtk-x86_64.tar.gz 安装 1.解压文件. 2.创建图标. ln -s /opt/eclipse/ec ...
- Hadoop基础学习(一)分析、编写并执行WordCount词频统计程序
版权声明:本文为博主原创文章,未经博主同意不得转载. https://blog.csdn.net/jiq408694711/article/details/34181439 前面已经在我的Ubuntu ...
- 使用HDFS完成wordcount词频统计
任务需求 统计HDFS上文件的wordcount,并将统计结果输出到HDFS 功能拆解 读取HDFS文件 业务处理(词频统计) 缓存处理结果 将结果输出到HDFS 数据准备 事先往HDFS上传需要进行 ...
- Eclipse上运行第一个Hadoop实例 - WordCount(单词统计程序)
需求 计算出文件中每个单词的频数.要求输出结果按照单词的字母顺序进行排序.每个单词和其频数占一行,单词和频数之间有间隔. 比如,输入两个文件,其一内容如下: hello world hello had ...
- 第六篇:Eclipse上运行第一个Hadoop实例 - WordCount(单词统计程序)
需求 计算出文件中每个单词的频数.要求输出结果按照单词的字母顺序进行排序.每个单词和其频数占一行,单词和频数之间有间隔. 比如,输入两个文件,其一内容如下: hello world hello had ...
- Hadoop上的中文分词与词频统计实践 (有待学习 http://www.cnblogs.com/jiejue/archive/2012/12/16/2820788.html)
解决问题的方案 Hadoop上的中文分词与词频统计实践 首先来推荐相关材料:http://xiaoxia.org/2011/12/18/map-reduce-program-of-rmm-word-c ...
- Hadoop之词频统计小实验
声明: 1)本文由我原创撰写,转载时请注明出处,侵权必究. 2)本小实验工作环境为Ubuntu操作系统,hadoop1-2-1,jdk1.8.0. 3)统计词频工作在单节点的伪分布上,至于真正实 ...
- Hadoop的改进实验(中文分词词频统计及英文词频统计)(4/4)
声明: 1)本文由我bitpeach原创撰写,转载时请注明出处,侵权必究. 2)本小实验工作环境为Windows系统下的百度云(联网),和Ubuntu系统的hadoop1-2-1(自己提前配好).如不 ...
- 词频统计小程序-WordCount.exe
一. 背景 最近顶哥为了完成学历提升学业中的小作业,做了一个词频统计的.exe小程序.因为当时做的时候网上的比较少,因此顶哥决定把自己拙略的作品发出来给需要的人提供一种思路,希望各位看官不要dis ...
随机推荐
- [转] Draw Call未被批处理?告诉你在Unity 5.6中如何查找原因 [复制链接]
Unity在5.6之前的版本中并未提供很直接的方式来查找Draw Call未被批处理的原因,但Unity 5.6在Frame Debugger中新增了一项功能,帮助开发者查找相关信息.今天这篇文章就为 ...
- vi/vim使用总结
第一部份:一般模式可用的按钮说明,光标移动.复制粘贴.搜索取代等 移动光标的方法: h 或 向左箭头键(←) 光标向左移动一个字符 j 或 向下箭头键(↓) 光标向下移劢一个字符 k 或 向上箭头键( ...
- 后置处理器----JSON提取器
JSON提取器可以很方便的让你从JSON响应格式中提取数据. 1)Name:JSON提取器的名称. 2)Apply to:应用范围,有些采样器还嵌套子采样器,可以在此处设置JSON提取器是作用与主采样 ...
- 洛谷P3122 [USACO15FEB]圈住牛Fencing the Herd(计算几何+CDQ分治)
题面 传送门 题解 题目转化一下就是所有点都在直线\(Ax+By-C=0\)的同一侧,也就可以看做所有点代入\(Ax+By-C\)之后的值符号相同,我们只要维护每一个点代入直线之后的最大值和最小值,看 ...
- JDK1.8源码阅读系列之二:LinkedList
本篇随笔主要描述的是我阅读 LinkedList 源码期间的对于 LinkedList 的一些实现上的个人理解,有不对的地方,请指出- 先来看一下 LinkedList 的继承图: 由于 Abstra ...
- 【hadoop】 running beyond virtual memory错误原因及解决办法
问题描述: 在hadoop中运行应用,出现了running beyond virtual memory错误.提示如下: Container [pid=28920,containerID=contain ...
- 《Andrew Ng深度学习》笔记3
浅层神经网络 初步了解了神经网络是如何构成的,输入+隐藏层+输出层.一般从输入层计算为层0,在真正计算神经网络的层数时不算输入层.隐藏层实际就是一些算法封装成的黑盒子.在对神经网络训练的时候,就是对神 ...
- 搭建Jenkins--(用于个人学习持续集成)
###1.安装java 完成后输入java -version,出现版本信息 输入 javac, 会出现 说明,JDK 和 JRE 安装正确 ###2.安装tomcat 1.下载Tomcat wind ...
- POJ - 3263 差分+前缀和
只需不断维护相对值的前缀就能得到解 这种思想第一次是在树状数组区间更新那里看到的,由于题目要求是1~n所以直接可以用前缀和维护 注意不能直接-1 +1 还有POJ的数据..要不是书里有提谁知道会这么毒 ...
- 03-树3 Tree Traversals Again (25 分)
An inorder binary tree traversal can be implemented in a non-recursive way with a stack. For example ...