
Python爬虫 获得淘宝商品评论
自从写了第一个sina爬虫,便一发不可收拾。进入淘宝评论爬虫正题:
在做这个的时候,也没有深思到底爬取商品评论有什么用,后来,爬下来了数据。觉得这些数据可以用于帮助分析商品的评论,从而为用户选择商品提供一定的可参考数据。
找评论所在真实url:有了前面爬搜狗图片的经验,面对找资料的url这件事,找他的速度是比第一次快了不少。首先进宝贝页面,如图
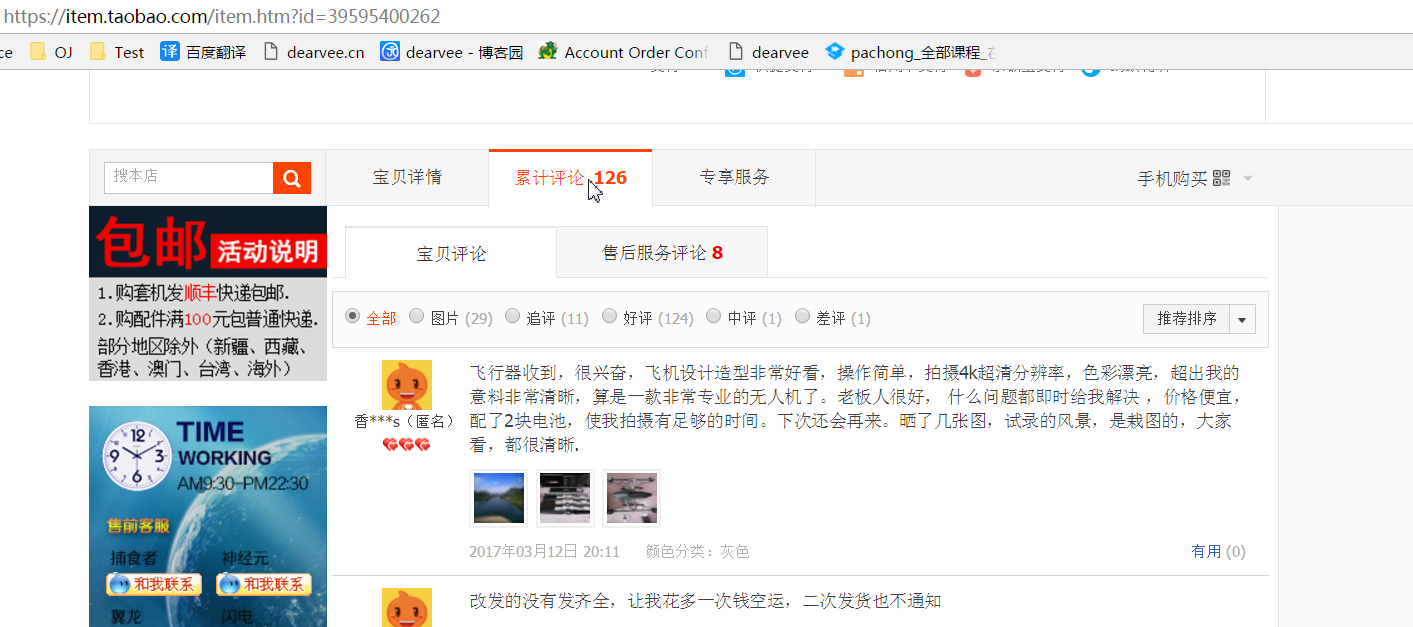
发现评论与搜狗图片类似,均为动态刷新。因此,F12(开发者选项)>>Notework>>F5(刷新)>>feedRateList(文件名)>>Headers>>复制Request URL
去除不必要的字段,获得需要的资料(评论)所在url= https://rate.taobao.com/feedRateList.htm?auctionNumId=39595400262¤tPageNum=1
猜测url地址为商品id,PageNum为评论的所在页数。因此要把所有页的评论遍历一遍。则应取Num的值递增访问,统计评论,直至输出的评论数等于总评为止,Num不再叠加,当然叠加后肯定是404喽。
愉快的代码时间:
import requests
import json
def getCommodityComments(url):
if url[url.find('id=')+14] != '&':
id = url[url.find('id=')+3:url.find('id=')+15]
else:
id = url[url.find('id=')+3:url.find('id=')+14]
url = 'https://rate.taobao.com/feedRateList.htm?auctionNumId='+id+'¤tPageNum=1'
res = requests.get(url)
jc = json.loads(res.text.strip().strip('()'))
max = jc['total']
users = []
comments = []
count = 0
page = 1
print('该商品共有评论'+str(max)+'条,具体如下: loading...')
while count<max:
res = requests.get(url[:-1]+str(page))
page = page + 1
jc = json.loads(res.text.strip().strip('()'))
jc = jc['comments']
for j in jc:
users.append(j['user']['nick'])
comments.append( j['content'])
print(count+1,'>>',users[count],'\n ',comments[count])
count = count + 1 getCommodityComments('https://item.taobao.com/item.htm?id=39595400262&')
来来来,看一下效果:

综上,Python爬虫的关键就在于获取所要爬取资料所在真实url,得到该url后,只需要做相应处理,for循环遍历所有页即可爬取获得资料,重要的资料亦可写进数据库。
Python爬虫 获得淘宝商品评论的更多相关文章
- Python 爬虫知识点 - 淘宝商品检索结果抓包分析(续一)
通过前一节得出地址可能的构建规律,如下: https://s.taobao.com/search?data-key=s&data-value=44&ajax=true&_ksT ...
- Python 爬虫知识点 - 淘宝商品检索结果抓包分析
一.抓包基础 在淘宝上搜索“Python机器学习”之后,试图抓取书名.作者.图片.价格.地址.出版社.书店等信息,查看源码发现html-body中没有这些信息,分析脚本发现,数据存储在了g_page_ ...
- Python 爬虫知识点 - 淘宝商品检索结果抓包分析(续二)
一.URL分析 通过对“Python机器学习”结果抓包分析,有两个无规律的参数:_ksTS和callback.通过构建如下URL可以获得目标关键词的检索结果,如下所示: https://s.taoba ...
- Python 爬取淘宝商品数据挖掘分析实战
Python 爬取淘宝商品数据挖掘分析实战 项目内容 本案例选择>> 商品类目:沙发: 数量:共100页 4400个商品: 筛选条件:天猫.销量从高到低.价格500元以上. 爬取淘宝商品 ...
- Python 爬取淘宝商品信息和相应价格
!只用于学习用途! plt = re.findall(r'\"view_price\"\:\"[\d\.]*\"',html) :获得商品价格和view_pri ...
- python 获取淘宝商品信息
python cookie 获取淘宝商品信息 # //get_goods_from_taobao import requests import re import xlsxwriter cok='' ...
- 利用Python爬虫爬取淘宝商品做数据挖掘分析实战篇,超详细教程
项目内容 本案例选择>> 商品类目:沙发: 数量:共100页 4400个商品: 筛选条件:天猫.销量从高到低.价格500元以上. 项目目的 1. 对商品标题进行文本分析 词云可视化 2. ...
- Python爬虫之定时抢购淘宝商品
Python爬虫之定时抢购淘宝商品 import time from selenium import webdriver import datetime class Spider: def __ini ...
- python爬虫学习(三):使用re库爬取"淘宝商品",并把结果写进txt文件
第二个例子是使用requests库+re库爬取淘宝搜索商品页面的商品信息 (1)分析网页源码 打开淘宝,输入关键字“python”,然后搜索,显示如下搜索结果 从url连接中可以得到搜索商品的关键字是 ...
随机推荐
- Javascript 对象 - 数学对象
数学对象 JavaScript中提供了math对象,math对象包含一些常用的属相和方法.Math对象与Array对象.String对象.Data对象不同,没有构造函数,因此不能创建Math对象.可直 ...
- python模块--collections
python的内建模块collections有几个关键的数据结构,平常在使用的时候,开发者可以直接调用,不需要自己重复制造轮子,这样可以提高开发效率. 1. deque双端队列 平常我们使用的pyth ...
- macOS下MySQL 8.0 安装与配置教程
一.前言 1.本教程主要内容 适用Homebrew安装MySQL MySQL 8.0 基础适用于配置 MySQL shell管理常用语法示例(用户.权限等) MySQL字符编码配置 MySQL远程访问 ...
- 「客户成功故事」OneAPM 助力网上办事大厅构建阳光、高效、安全的政务服务平台
(一) 项目背景: 网上办事大厅是由省信息中心承建的电子政务核心业务系统,致力于为全省民众提供一站式网上办事服务,实现了政务信息网上公开.法人及个人事项网上办理.公共决策网上互动.政府效能网上监督五大 ...
- 【PHPStorm使用手册】如何设置字体大小?
方案一:鼠标滚轮设置 打开窗口 file -> settings -> Editor -> General, 勾上选项“Change font size(Zoom) with Ctr ...
- MyBatis笔记----多表关联查询两种方式实现
数据库 方式一:XML 按照下面类型建立article表 Article.java package com.ij34.model; public class Article { private int ...
- shell重定向介绍及使用
我们在写脚本或用脚本时,往往会发现 > /dev/null 2>&1 这类的命令.之前都是简单的了解一下,并没有深度消化,直到自己写脚本时,不认真写成了2>&1 &g ...
- The host '192.168.174.130' is unreachable. the host may be down..............
The host '192.168.174.130' is unreachable. the host may be down,or there may be a problem with ...
- jquery.qrcode.js 生成二维码并支持中文的方法
GitHub地址: https://github.com/jeromeetienne/jquery-qrcode <div class="QR"></div> ...
- DBUtils温习2
上篇简单回顾了下DBUtils的简介和其常用的类,这篇博客结合C3P0连接池,做一个简单的增删改查操作 1.创建web项目,导入jar包 2.编写c3p0-config.xml和引入工具类 <? ...