
Python 爬虫实例(6)—— 爬取蚂蚁免费代理
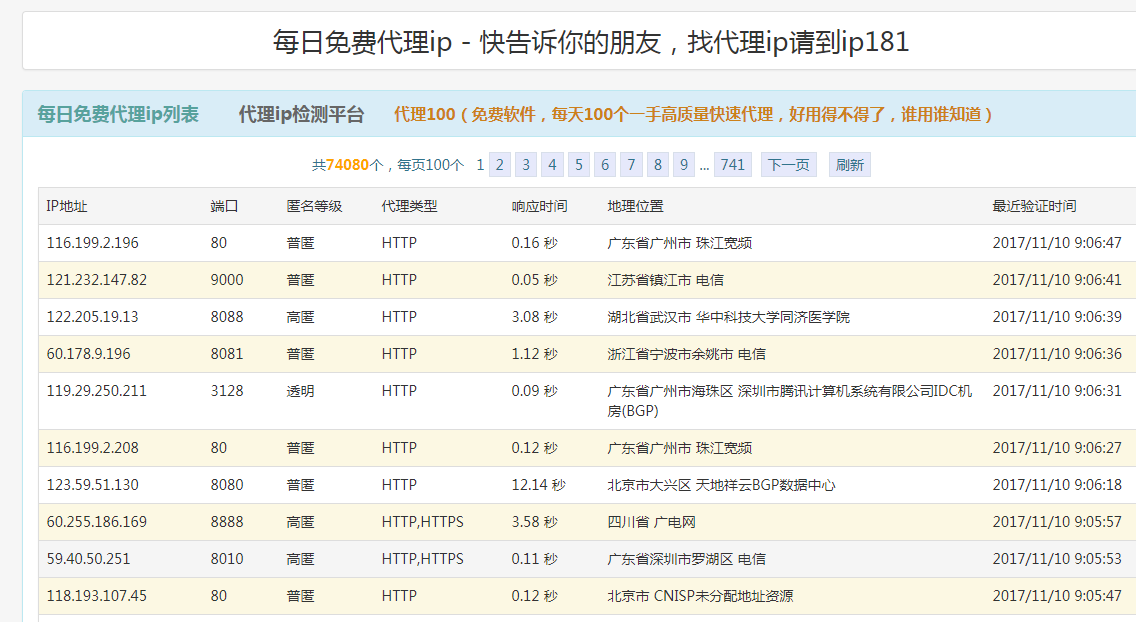
数据库表sql语句:
CREATE TABLE `free_ip` (

  `free_ip_id` int(11) NOT NULL AUTO_INCREMENT COMMENT '主键',

  `ip` varchar(255) DEFAULT NULL COMMENT 'ip地址',

  `port` varchar(255) DEFAULT NULL COMMENT '端口',

  `yini_class` varchar(255) DEFAULT NULL COMMENT '匿名等级',

  `http_type` varchar(255) DEFAULT NULL COMMENT '代理类型',

  `response_time` varchar(255) DEFAULT NULL COMMENT '响应时间',

  `address` varchar(255) DEFAULT NULL COMMENT '地理位置',

  `validate_time` varchar(255) DEFAULT NULL COMMENT '最近验证时间',

  `hashcode` varchar(255) DEFAULT NULL COMMENT '去重',

  PRIMARY KEY (`free_ip_id`),

  UNIQUE KEY `hashcode` (`hashcode`) USING BTREE

) ENGINE=InnoDB AUTO_INCREMENT=4220 DEFAULT CHARSET=utf8;
源代码:
# coding:utf-8

import random, re

import sqlite3

import json, time

import uuid

from bs4 import BeautifulSoup

import threading

import requests

import MySQLdb

from lxml import etree

import urllib3

urllib3.disable_warnings()

import urllib2

import sys

reload(sys)

sys.setdefaultencoding('utf-8')

session = requests.session()

import logging

import logging.handlers

import platform

sysStr = platform.system()

if sysStr =="Windows":

    LOG_FILE_check = 'H:\\log\\log.txt'

else:

    LOG_FILE_check = '/log/wlb/crawler/cic.log'

handler = logging.handlers.RotatingFileHandler(LOG_FILE_check, maxBytes=128 * 1024 * 1024,backupCount=10)  # 实例化handler  200M 最多十个文件

fmt = '\n' + '%(asctime)s - %(filename)s:%(lineno)s  - %(message)s'

formatter = logging.Formatter(fmt)  # 实例化formatter

handler.setFormatter(formatter)  # 为handler添加formatter

logger = logging.getLogger('check')  # 获取名为tst的logger

logger.addHandler(handler)  # 为logger添加handler

logger.setLevel(logging.DEBUG)

def md5(str):

    import hashlib

    m = hashlib.md5()

    m.update(str)

    return m.hexdigest()

def freeIp():

    for i in range(1,1000):

        print "正在爬取的位置是:",i

        url = "http://www.ip181.com/daili/" + str(i)+ ".html"

        headers = {

            "Host":"www.ip181.com",

            "Connection":"keep-alive",

            "Upgrade-Insecure-Requests":"",

            "User-Agent":"Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/61.0.3163.91 Safari/537.36",

            "Accept":"text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8",

            "Referer":url,

            "Accept-Encoding":"gzip, deflate",

            "Accept-Language":"zh-CN,zh;q=0.8",

            }

        try:

            result = session.get(url=url,headers=headers).text

            result = result.encode('ISO-8859-1').decode(requests.utils.get_encodings_from_content(result)[0])

        except:

            result = session.get(url=url, headers=headers).text

            result = result.encode('ISO-8859-1').decode(requests.utils.get_encodings_from_content(result)[0])

        soup = BeautifulSoup(result, 'html.parser')

        result_soup = soup.find_all("div", attrs={"class": "col-md-12"})[1]

        result_soup = str(result_soup).replace('\r\n\t','').replace('\r\n','').replace('\n\t','').replace('\n','').replace(' class="warning"','')

        result_soups = re.findall('最近验证时间</td></tr>(.*?)</tbody></table><div class="page">共',result_soup)[0]

        print result_soups

        result_list = re.findall('<tr><td>(.*?)</td><td>(.*?)</td><td>(.*?)</td><td>(.*?)</td><td>(.*?)</td><td>(.*?)</td><td>(.*?)</td></tr>',result_soups)

        for item in result_list:

            ip = item[0]

            port = item[1]

            yini_class = item[2]

            http_type = item[3]

            response_time = item[4]

            address = item[5]

            validate_time = item[6]

            proxy = str(ip) + ":" + port

            hashcode = md5(proxy)

            try: # 此处是数据库连接,请换成自己的数据库

                conn = MySQLdb.connect(host="110.110.110.717", user="lg", passwd="", db="",charset="utf8")

                cursor = conn.cursor()

                sql = """INSERT INTO free_ip (ip,port,yini_class,http_type,response_time,address,validate_time,hashcode)

                VALUES (%s,%s,%s,%s,%s,%s,%s,%s)"""

                params = (ip,port,yini_class,http_type,response_time,address,validate_time,hashcode)

                cursor.execute(sql, params)

                conn.commit()

                cursor.close()

                print "          插入成功      "

            except Exception as e:

                print "********插入失败********"

                print e

freeIp()
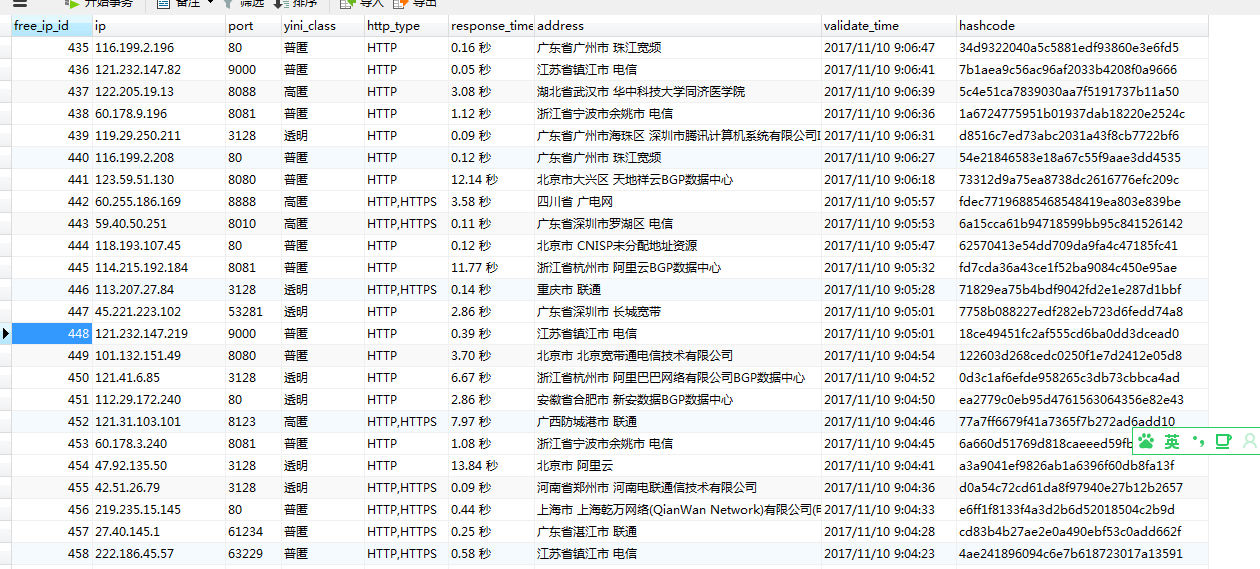
爬取效果:
Python 爬虫实例(6)—— 爬取蚂蚁免费代理的更多相关文章
- Python爬虫实例:爬取B站《工作细胞》短评——异步加载信息的爬取
很多网页的信息都是通过异步加载的,本文就举例讨论下此类网页的抓取. <工作细胞>最近比较火,bilibili 上目前的短评已经有17000多条. 先看分析下页面 右边 li 标签中的就是短 ...
- Python爬虫实例:爬取猫眼电影——破解字体反爬
字体反爬 字体反爬也就是自定义字体反爬,通过调用自定义的字体文件来渲染网页中的文字,而网页中的文字不再是文字,而是相应的字体编码,通过复制或者简单的采集是无法采集到编码后的文字内容的. 现在貌似不少网 ...
- Python爬虫实例:爬取豆瓣Top250
入门第一个爬虫一般都是爬这个,实在是太简单.用了 requests 和 bs4 库. 1.检查网页元素,提取所需要的信息并保存.这个用 bs4 就可以,前面的文章中已经有详细的用法阐述. 2.找到下一 ...
- Python爬虫教程-17-ajax爬取实例(豆瓣电影)
Python爬虫教程-17-ajax爬取实例(豆瓣电影) ajax: 简单的说,就是一段js代码,通过这段代码,可以让页面发送异步的请求,或者向服务器发送一个东西,即和服务器进行交互 对于ajax: ...
- 【转载】教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神
原文:教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神 本博文将带领你从入门到精通爬虫框架Scrapy,最终具备爬取任何网页的数据的能力.本文以校花网为例进行爬取,校花网:http:/ ...
- python爬虫-基础入门-爬取整个网站《3》
python爬虫-基础入门-爬取整个网站<3> 描述: 前两章粗略的讲述了python2.python3爬取整个网站,这章节简单的记录一下python2.python3的区别 python ...
- python爬虫-基础入门-爬取整个网站《2》
python爬虫-基础入门-爬取整个网站<2> 描述: 开场白已在<python爬虫-基础入门-爬取整个网站<1>>中描述过了,这里不在描述,只附上 python3 ...
- python爬虫-基础入门-爬取整个网站《1》
python爬虫-基础入门-爬取整个网站<1> 描述: 使用环境:python2.7.15 ,开发工具:pycharm,现爬取一个网站页面(http://www.baidu.com)所有数 ...
- Python 爬虫入门之爬取妹子图
Python 爬虫入门之爬取妹子图 来源:李英杰 链接: https://segmentfault.com/a/1190000015798452 听说你写代码没动力?本文就给你动力,爬取妹子图.如果 ...
随机推荐
- RapidSVN的使用
RapidSVN是一个可视化 SVN 客户端,运行速度快,简单易用,现在很多已经做成做成便携版,安装都不用.小乌龟那个SVN感觉太复杂了...不妨试下这个. 1.下载安装 2.运行RapidSVNPo ...
- vim多行注释与取消
神操作 在vim中编写代码,常常会遇到多行注释和取消注释的情况,在VS中我们可以用默认的快捷键或者在设置中自定义快捷键来解决这个问题. vim既然这么强大,必然也是有快捷键来完成的.下面给出具体步骤: ...
- 能力成熟度模型CMM
能力成熟度模型(Capability Maturity Model,英文缩写为CMM)[1]是 一种开发模型.Carnegie Mellon大学的研究人员从美国国防部合同承包方那里收集数据并加以研究, ...
- OpenShift跨版本升级
官方的in-place upgrade直接在线升级的参考链接 https://docs.openshift.com/container-platform/3.11/upgrading/automate ...
- 使用Vue.js制作仿Metronic高级表格(一)静态设计
Metronic高级表格是Metonic框架中自行实现的表格,其底层是Datatables.本教程将主要使用Vue实现交互部分,使用Bootstrap做样式库.jQuery做部分用户交互(弹窗). 使 ...
- Kafka实战-Flume到Kafka (转)
原文链接:Kafka实战-Flume到Kafka 1.概述 前面给大家介绍了整个Kafka项目的开发流程,今天给大家分享Kafka如何获取数据源,即Kafka生产数据.下面是今天要分享的目录: 数据来 ...
- iOS: 首次使用App时,显示半透明新手指引
在很多的app,我们都会发现这样一个功能:就是app启动后进入主界面时,会有一个半透明的指引图,它会提示用户如何一步步进行操作,快速的熟悉app的使用规则,极大地方便了用户的使用,也加快了app的推广 ...
- 科普:UTF-8 GBK UTF8 GB2312 之间的区别和关系
UTF-8:Unicode TransformationFormat-8bit,允许含BOM,但通常不含BOM.是用以解决国际上字符的一种多字节编码,它对英文使用8位(即一个字节),中文使用24为(三 ...
- leetcode mock Shuffle an Array
1. shuffle算法: http://www.cnblogs.com/huaping-audio/archive/2008/09/09/1287985.html 注意:我们一般用的是第二种swap ...
- Windows之权限讲解
windows中,权限指的是不同账户对文件,文件夹,注册表等的访问能力.在windows中,为不同的账户设置权限很重要,可以防止重要文件被其他人所修改,使系统崩溃. 1权限概念 我们可以在控制面板中设 ...