
Python爬虫知识点一
一。入门知识:
1.1.HTTP简介
HTTP = HyperText Transfer Protocol
URI = Uniform Resource Identifier
URL = Uniform Resource Locator
URI和URL的区别:URI强调的是资源,而URL强调的是资源的位置。
1.2常用请求类型
OPTIONS: 返回服务器针对特定资源所支持的http请求方法。
HEAD: 向服务器索要与get请求相一致的响应,只不过响应体将不会被返回。
GET: 向特定资源发出请求
PUT: 向指定资源位置上传其最新内容
POST: 向指定资源提交数据进行处理请求
DELETE: 请求服务器删除指定URI所标识的资源
PATCH: 用来将局部修改应用于某一资源
1.3HTTP常见状态码
200/OK: 请求成功
201/Created: 请求已被实现,且一个新资源已根据请求被建立,URI跟随Location头信息返回。
202/Accepted: 服务器已接受请求,但尚未处理。
400/Bad Request: 请求无法被服务器理解
401/Unauthorized: 当前请求需要用户验证
403/Forbidden: 服务器已理解请求,但拒绝执行。
404/Not Found
1.4 爬虫框架介绍
第一步:将种子URL放入队列
第二步:从队列中获取URL,抓取内容。
第三步:解析抓取内容,将需要进一步抓取的URL放入工作队列,存储解析后的内容
1.5 抓取策略
深度优先:举例先完成专题一的所有内容,再完成专题二的所有内容。
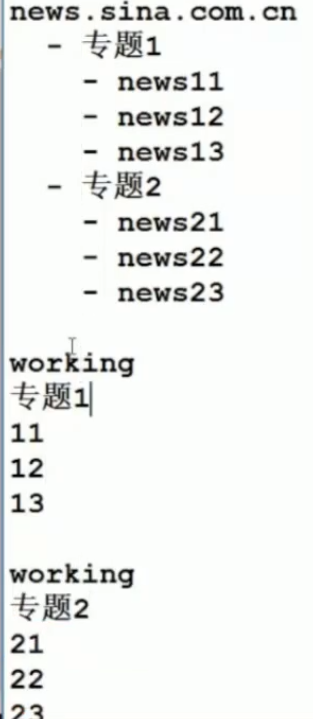
广度优先
PageRank
大站优先策略 举例: 根据网站的Pr顺序 指定优先级
1.6 如何去重
Hash表
bloom过滤器
1.7 爬虫质量标准
分布式
可伸缩性
性能和有效性
质量
新鲜性
更新
可扩展性
二。代码实施
import requests

import xml.etree.ElementTree as ET

from xml.parsers.expat import ParserCreate

class DefaultSaxHandler(object):

    def __init__(self, provinces):

        self.provinces = provinces

    # 处理标签开始

    def start_element(self, name, attrs):

        if name != 'map':

            name = attrs['title']

            number = attrs['href']

            self.provinces.append((name, number))

    # 处理标签结束

    def end_element(self, name):

        pass

    # 文本处理

    def char_data(self, text):

        pass

def get_province_entry(url):

    # 获取文本,并用gb2312解码

    content = requests.get(url).content.decode('gb2312')

    # 确定要查找字符串的开始结束位置,并用切片获取内容。

    start = content.find('<map name=\"map_86\" id=\"map_86\">')

    end = content.find('</map>')

    content = content[start:end + len('</map>')].strip()

    print(content)

    provinces = []

    # 生成Sax处理器

    handler = DefaultSaxHandler(provinces)

    # 初始化分析器

    parser = ParserCreate()

    parser.StartElementHandler = handler.start_element

    parser.EndElementHandler = handler.end_element

    parser.CharacterDataHandler = handler.char_data

    # 解析数据

    parser.Parse(content)

    # 结果字典为每一页的入口代码

    return provinces

provinces = get_province_entry('http://www.ip138.com/post')

print(provinces)
结果如下:
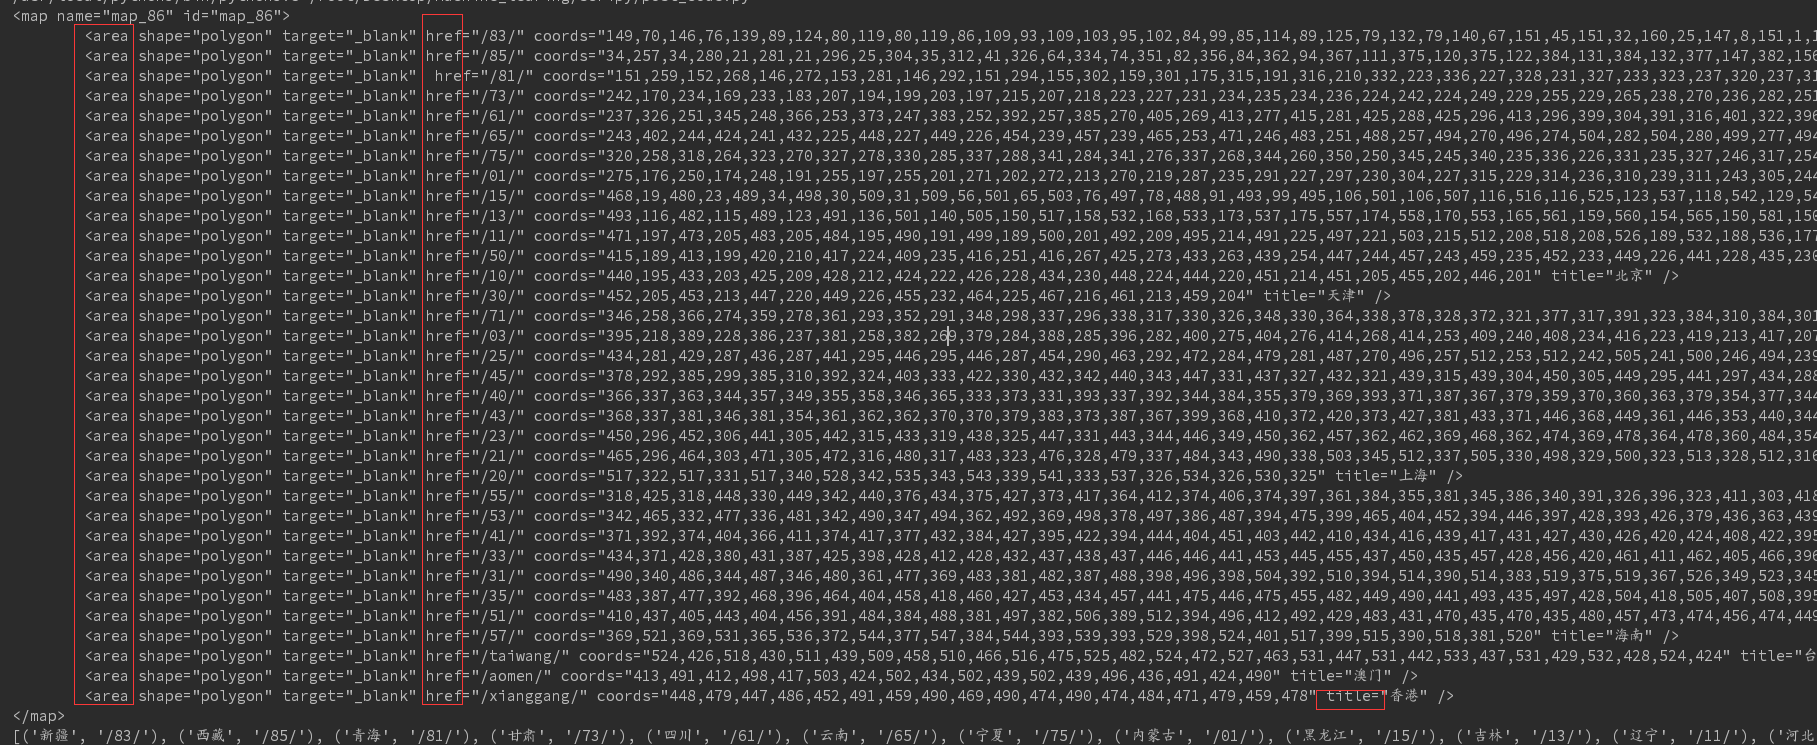
Ps: start方法中判断不等于map标签的即为area标签 然后选取href title属性对应的值即可
持续更新中。。。。,欢迎大家关注我的公众号LHWorld.
Python爬虫知识点一的更多相关文章
- python爬虫知识点详解
python爬虫知识点总结(一)库的安装 python爬虫知识点总结(二)爬虫的基本原理 python爬虫知识点总结(三)urllib库详解 python爬虫知识点总结(四)Requests库的基本使 ...
- Python爬虫知识点四--scrapy框架
一.scrapy结构数据 解释: 1.名词解析: o 引擎(Scrapy Engine)o 调度器(Scheduler)o 下载器(Downloader)o 蜘蛛(Spiders)o 项目管 ...
- Python 爬虫知识点 - 淘宝商品检索结果抓包分析(续一)
通过前一节得出地址可能的构建规律,如下: https://s.taobao.com/search?data-key=s&data-value=44&ajax=true&_ksT ...
- python爬虫知识点总结(八)Selenium库详解
官方学习文档:http://selenium-python.readthedocs.io/api.html 一.什么是Selenium? 答:自动化测试工具,支持多种浏览器.用来驱动浏览器,发出指令让 ...
- python爬虫知识点总结(一)库的安装
环境要求: 1.编程语言版本python3: 2.系统:win10; 3.浏览器:Chrome68.0.3440.75:(如果不是最新版有可能影响到程序执行) 4.chromedriver2.41 注 ...
- Python 爬虫知识点 - 淘宝商品检索结果抓包分析(续二)
一.URL分析 通过对“Python机器学习”结果抓包分析,有两个无规律的参数:_ksTS和callback.通过构建如下URL可以获得目标关键词的检索结果,如下所示: https://s.taoba ...
- Python 爬虫知识点 - 淘宝商品检索结果抓包分析
一.抓包基础 在淘宝上搜索“Python机器学习”之后,试图抓取书名.作者.图片.价格.地址.出版社.书店等信息,查看源码发现html-body中没有这些信息,分析脚本发现,数据存储在了g_page_ ...
- Python 爬虫知识点
一.基础知识 1.HTML分析 2.urllib爬取 导入urilib包(Python3.5.2) 3.urllib保存网页 import urllib.requesturl = "http ...
- python爬虫知识点总结(六)BeautifulSoup库详解
官方学习文档:https://www.crummy.com/software/BeautifulSoup/bs4/doc.zh/ 一.什么时BeautifulSoup? 答:灵活又方便的网页解析库,处 ...
随机推荐
- css走过的坑
css盒模型 1.内联元素 设置宽高无效.margin左右有效上下无效.padding都有效 会被当做字体所以内联之间有间隙 父级元素要设置font-size:0; 内联元素:a.b.button.e ...
- 自己动手写http服务器——线程池(一)
创建一个线程池,每有一个连接对象就将它添加到工作队列中,线程池中的线程通过竞争来取得任务并执行它(它是通过信号量实现的). //filename threadpool.h #ifndef THREAD ...
- UVA - 11396 Claw Decomposition(二分图染色)
题目大意:给你一张无向图,每一个点的度数都是3. 你的任务是推断是否能把它分解成若干个爪(每条边仅仅能属于一个爪) 解题思路:二分图染色裸题.能够得出:爪的中心点和旁边的三个点的颜色是不一样的 #in ...
- AntiXSS的使用
下载类库: http://wpl.codeplex.com 添加程序集引用 在web.config文件中将AntiXSS类库注册为应用程序的编码器 在<system.web& ...
- Ajax 请求后打开新窗口被拦截的解决方案
公司业务上有个场景,需请求后台获取支付链接地址,再打开地址引导用户购买.这样的场景在其他企业应该也很场景.但是遇到个很常见的问题,Ajax后直接用window.open(url),会被浏览器作为广告拦 ...
- Shell编程中的变量作用域
有两个shell脚本文件: a.sh name=Tom echo $name ./b.sh b.sh echo "name in b.sh:"$name 运行./a.sh时输出结果 ...
- presto
presto中文站:http://prestodb-china.com/ 进入hadoop机器,进入presto所在bin目录:presto --server localhost:9090 --cat ...
- [原创]mysql的zip包如何在windows下安装
今天在尝试zipkin的链路数据写入mysql,本机恰好没有按照mysql.找到一个很久前谁发的mysql-5.6.19-winx64.zip,版本不新?别挑剔啦,只是本机测试,能用就好哈哈.. 解压 ...
- 《深入理解Java虚拟机:JVM高级特性与最佳实践》【PDF】下载
<深入理解Java虚拟机:JVM高级特性与最佳实践>[PDF]下载链接: https://u253469.pipipan.com/fs/253469-230062566 内容简介 作为一位 ...
- IOC容器在web容器中初始化过程——(二)深入理解Listener方式装载IOC容器方式
先来看一下ContextServletListener的代码 public class ContextLoaderListener extends ContextLoader implements S ...