
sklearn交叉验证-【老鱼学sklearn】
交叉验证(Cross validation),有时亦称循环估计, 是一种统计学上将数据样本切割成较小子集的实用方法。于是可以先在一个子集上做分析, 而其它子集则用来做后续对此分析的确认及验证。 一开始的子集被称为训练集。而其它的子集则被称为验证集或测试集。交叉验证是一种评估统计分析、机器学习算法对独立于训练数据的数据集的泛化能力(generalize)。
我们以分类花的例子来看下:
# 加载iris数据集

from sklearn.datasets import load_iris

from sklearn.model_selection import train_test_split

from sklearn.neighbors import KNeighborsClassifier

iris = load_iris()

X = iris.data

y = iris.target

# 分割训练集和测试集

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3)

# 建立模型

model = KNeighborsClassifier()

# 训练模型

model.fit(X_train, y_train)

# 将准确率打印出

print(model.score(X_test, y_test))
这样这个模型的得分为:
0.911111111111
但是如果我再运行一下,这个得分又会变成:
0.955555555556
如果再进行多次运行,这个得分的结果就又会不一样。
为了能够得出一个相对比较准确的得分,一般是进行多次试验,并且是用不同的训练集和测试集进行。
这个叫做交叉验证,一般有留一法,也就是把原始数据分成十份,其中一份作为测试,其它的作为训练集,并且可以循环来选取其中的一份作为测试集,剩下的作为训练集。
当然,这里只是提供一个基本思想,具体你要分成几份可以自己来定义。
比如,下面的代码我们定义了5份并做了5次实验:
# 加载iris数据集

from sklearn.datasets import load_iris

from sklearn.model_selection import train_test_split, cross_val_score

from sklearn.neighbors import KNeighborsClassifier

iris = load_iris()

X = iris.data

y = iris.target

# 建立模型

model = KNeighborsClassifier()

# 使用K折交叉验证模块

scores = cross_val_score(model, X, y, cv=5)

# 将5次的预测准确率打印出

print(scores)
输出为:
[ 0.96666667 1. 0.93333333 0.96666667 1. ]
对这几次实验结果进行一下平均作为本次实验的最终得分:
# 将5次的预测准确平均率打印出

print(scores.mean())
结果为:
0.973333333333
在KNN算法中,其中有个neighbors参数,我们可以修改此参数的值:
model = KNeighborsClassifier(n_neighbors=5)
但这个参数值选择哪个数字为最佳呢?
我们可以通过程序来不停选择这个值并看在不同数值下其对应的得分情况,最终可以选择得分较好对应的参数值:
# 加载iris数据集

from sklearn.datasets import load_iris

from sklearn.model_selection import cross_val_score

from sklearn.neighbors import KNeighborsClassifier

# 可视化模块

import matplotlib.pyplot as plt

iris = load_iris()

X = iris.data

y = iris.target

# 建立测试参数集

k_range = range(1, 31)

k_scores = []

for k in k_range:

    # 建立模型

    model = KNeighborsClassifier(n_neighbors=k)

    # 使用K折交叉验证模块

    scores = cross_val_score(model, X, y, cv=10)

    # 计算10次的预测准确平均率

    k_scores.append(scores.mean())

# 可视化数据

plt.plot(k_range, k_scores)

plt.show()
显示的图形为:
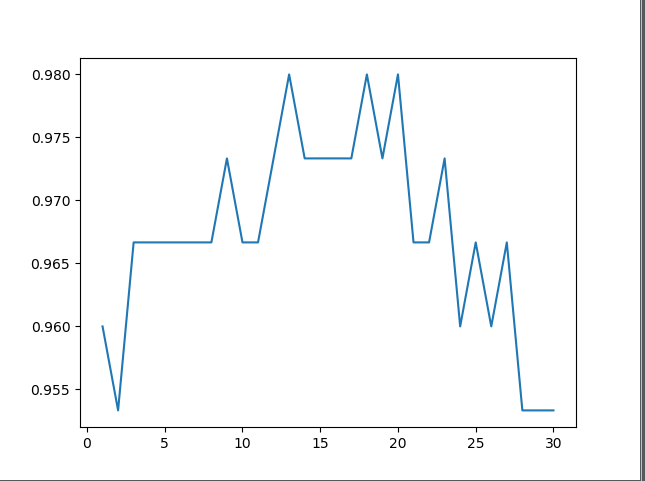
从这个结果图上看,n_neighbors太小或太大其精确度都会下降,因此比较好的取值是5-20之间。
另外对于回归算法,需要用损失函数来进行评估:
loss = -cross_val_score(model, data_X, data_y, cv=10, scoring='neg_mean_squared_error')
sklearn交叉验证-【老鱼学sklearn】的更多相关文章
- sklearn标准化-【老鱼学sklearn】
在前面的一篇博文中关于计算房价中我们也大致提到了标准化的概念,也就是比如对于影响房价的参数中有面积和户型,面积的取值范围可以很广,它可以从0-500平米,而户型一般也就1-5. 标准化就是要把这两种参 ...
- sklearn数据库-【老鱼学sklearn】
在做机器学习时需要有数据进行训练,幸好sklearn提供了很多已经标注好的数据集供我们进行训练. 本节就来看看sklearn提供了哪些可供训练的数据集. 这些数据位于datasets中,网址为:htt ...
- sklearn交叉验证2-【老鱼学sklearn】
过拟合 过拟合相当于一个人只会读书,却不知如何利用知识进行变通. 相当于他把考试题目背得滚瓜烂熟,但一旦环境稍微有些变化,就死得很惨. 从图形上看,类似下图的最右图: 从数学公式上来看,这个曲线应该是 ...
- sklearn交叉验证3-【老鱼学sklearn】
在上一个博文中,我们用learning_curve函数来确定应该拥有多少的训练集能够达到效果,就像一个人进行学习时需要做多少题目就能拥有较好的考试成绩了. 本次我们来看下如何调整学习中的参数,类似一个 ...
- sklearn模型的属性与功能-【老鱼学sklearn】
本节主要讲述模型中的各种属性及其含义. 例如上个博文中,我们有用线性回归模型来拟合房价. # 创建线性回归模型 model = LinearRegression() # 训练模型 model.fit( ...
- sklearn保存模型-【老鱼学sklearn】
训练好了一个Model 以后总需要保存和再次预测, 所以保存和读取我们的sklearn model也是同样重要的一步. 比如,我们根据房源样本数据训练了一下房价模型,当用户输入自己的房子后,我们就需要 ...
- 二分类问题续 - 【老鱼学tensorflow2】
前面我们针对电影评论编写了二分类问题的解决方案. 这里对前面的这个方案进行一些改进. 分批训练 model.fit(x_train, y_train, epochs=20, batch_size=51 ...
- tensorflow卷积神经网络-【老鱼学tensorflow】
前面我们曾有篇文章中提到过关于用tensorflow训练手写2828像素点的数字的识别,在那篇文章中我们把手写数字图像直接碾压成了一个784列的数据进行识别,但实际上,这个图像是2828长宽结构的,我 ...
- 机器学习- Sklearn (交叉验证和Pipeline)
前面一节咱们已经介绍了决策树的原理已经在sklearn中的应用.那么这里还有两个数据处理和sklearn应用中的小知识点咱们还没有讲,但是在实践中却会经常要用到的,那就是交叉验证cross_valid ...
随机推荐
- vivado place30-378
AR# 60131 Vivado Placer - [Place 30-378] Input pin of input buffer has an illegal connection to a lo ...
- Bugku 分析 中国菜刀
解压之后得到了一个流量包,只有不到10KB,美滋滋 先抓重点,过滤出http,只有6条数据记录,3条post,3条response,3条post都是一样的 随便打开一条pos 是一个assert断言, ...
- 启动jar的方式
1.windows server 2008 start "srvRegistry" java -jar srvRegistry-1.0-SNAPSHOT.jar --spring. ...
- 用IntelliJ IDEA 开发Spring+SpringMVC+Mybatis框架 分步搭建三:配置spring并测试
这一部分的主要目的是 配置spring-service.xml 也就是配置spring 并测试service层 是否配置成功 用IntelliJ IDEA 开发Spring+SpringMVC+M ...
- 洛谷P2257 YY的GCD 莫比乌斯反演
原题链接 差不多算自己推出来的第一道题QwQ 题目大意 \(T\)组询问,每次问你\(1\leqslant x\leqslant N\),\(1\leqslant y\leqslant M\)中有多少 ...
- Python变量命名规范
模块名: 小写字母,单词之间用_分割 ad_stats.py 包名: 和模块名一样 类名: 单词首字母大写 AdStats ConfigUtil 全局变量名(类变量,在java中相当于static变量 ...
- [再寄小读者之数学篇](2014-04-01 from 2103471050@qq.com 曲线积分)
求 $\int_\vGa y^2\rd s$, 其中 $\vGa$ 由 $\dps{\sedd{\ba{rl} x^2+y^2+z^2&=a^2\\ x+z&=a \ea}}$ 决定. ...
- python学习04
数据类型-list,tuple 1) 1.1.list的表现方法:[1,2,3,4,5,6] 1.2.计算list的长度用 len() 1.3 list中的索引 a =[1,2,3,4,5] a[1] ...
- iTOP-4418开发板和6818开发板-第五路串口介绍
iTOP-4418开发板和6818开发板 的除去默认 4 个串口的配置和用法. 4418 的开发板最多支持 5 路串口,如下图所示,4418 的 datasheet. 6818 的开发板最多支持 ...
- Eclipse 搭建 Strust2开发环境
一.创建一个动态Web项目 ♦ 注意 :一定要勾选Generate Web.xml deployment descriptor 选项,这个将在Eclipse为你创建一个动态web项目. 二.导入相关 ...