
Python——LOL官方商城皮肤信息爬取(一次练手)
# -*- coding utf-8 -*-

import urllib

import urllib.request

import json

import time

import xlsxwriter

from asyncio.tasks import sleep

import re

# 根据第一页数据创建信息表头

header = []

url = "http://apps.game.qq.com/daoju/v3/api/hx/goods/api/list/v54/GoodsListApp.php?view=biz_cate&page=1&pageSize=8&orderby=dtShowBegin&ordertype=desc&cate=17&appSource=pc&appSourceDetail=pc_lol_revison&channel=1001&storagetype=6501&plat=0&output_format=jsonp&biz=lol"

data = json.loads(urllib.request.urlopen(url).read().decode("gbk").replace("var ogoods_list_api = ","").replace("\n",""))

goods_info = data["data"]["goods"][0]["valiDate"][0]

for i in range(len(goods_info)):

    header.append(''.join((re.findall("\w",str(str(goods_info).split(",")[i]).split(":")[0]))).strip())

# 创建工作簿,写表头

workbook = xlsxwriter.Workbook("E:/lol_sales.xlsx")

sheet = workbook.add_worksheet("result")

for i in range(len(header)):

    sheet.write(0,i,header[i])

# 获取数据

row_index = 1

for page_index in range(1,61):

    url = "http://apps.game.qq.com/daoju/v3/api/hx/goods/api/list/v54/GoodsListApp.php?view=biz_cate&page=" + str(page_index) + "&pageSize=8&orderby=dtShowBegin&ordertype=desc&cate=17&appSource=pc&appSourceDetail=pc_lol_revison&channel=1001&storagetype=6501&plat=0&output_format=jsonp&biz=lol"

    data = json.loads(urllib.request.urlopen(url).read().decode("gbk").replace("var ogoods_list_api = ","").replace("\n",""))

    for goods_index in range(6):

        try:

            for col_index in range(len(header)):

                if header[col_index]  == "award":

                    pass

                else:

                    sheet.write(row_index,col_index,data["data"]["goods"][goods_index]["valiDate"][0][header[col_index]])

            row_index += 1

        except:

            pass

    print("page" + str(page_index))

workbook.close()

print("finish")
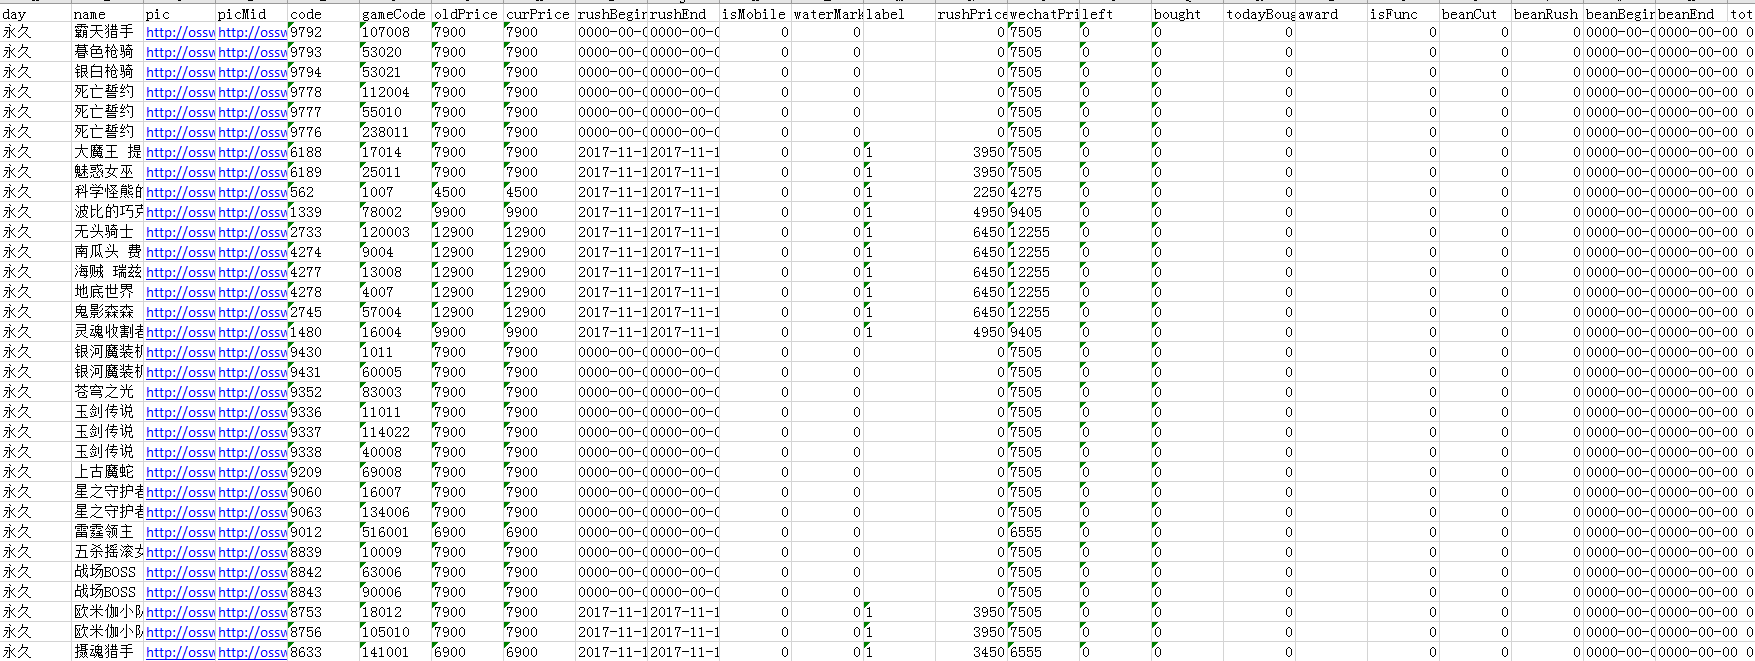
获取的数据内容如下:
总结:
1.表头的获取方式。
不要再自己编写表头啦,一是太费事,二是不灵活。
通过创建空的列表,读取示范页面(如第一页)的信息表头,使用.append即可创建所需表头。
2.多数网站的数据格式都是json,但是其返回的还附带了json数据的表头,注意删除掉。
如.replace("var ogoods_list_api = ","").replace("\n","")。这样才是符合格式要求的json(可以用这个网站测试json格式是否标准:Be JSON),否则无法用json.loads()读取,因为会被识别成字符串。
3.json.loads(s),中读取的是字符串数据。
4.即使读取出来的数据编码是unicode,但是写入excel的时候就被解码了。(使用了多种方式仍无法对数据解码,故打算提取后单独解码,后发现写入excel的是解码后的数据。意外发现。)
5.关于表头的提取:
- 首先使用两次split,分别是“,”和“:”将json的key提取出来。
- 接下来使用正则表达式提取{'ret'中的ret。在这里使用了这样的方法:用\w提取英文字符,再用''.join()合并起来
Python——LOL官方商城皮肤信息爬取(一次练手)的更多相关文章
- 关于python的中国历年城市天气信息爬取
一.主题式网络爬虫设计方案(15分)1.主题式网络爬虫名称 关于python的中国城市天气网爬取 2.主题式网络爬虫爬取的内容与数据特征分析 爬取中国天气网各个城市每年各个月份的天气数据, 包括最高城 ...
- 豆瓣电影信息爬取(json)
豆瓣电影信息爬取(json) # a = "hello world" # 字符串数据类型# b = {"name":"python"} # ...
- 安居客scrapy房产信息爬取到数据可视化(下)-可视化代码
接上篇:安居客scrapy房产信息爬取到数据可视化(下)-可视化代码,可视化的实现~ 先看看保存的数据吧~ 本人之前都是习惯把爬到的数据保存到本地json文件, 这次保存到数据库后发现使用mongod ...
- Python爬虫学习三------requests+BeautifulSoup爬取简单网页
第一次第一次用MarkDown来写博客,先试试效果吧! 昨天2018俄罗斯世界杯拉开了大幕,作为一个伪球迷,当然也得为世界杯做出一点贡献啦. 于是今天就编写了一个爬虫程序将腾讯新闻下世界杯专题的相关新 ...
- 初识python 之 爬虫:使用正则表达式爬取“糗事百科 - 文字版”网页数据
初识python 之 爬虫:使用正则表达式爬取"古诗文"网页数据 的兄弟篇. 详细代码如下: #!/user/bin env python # author:Simple-Sir ...
- Python爬虫学习之使用beautifulsoup爬取招聘网站信息
菜鸟一只,也是在尝试并学习和摸索爬虫相关知识. 1.首先分析要爬取页面结构.可以看到一列搜索的结果,现在需要得到每一个链接,然后才能爬取对应页面. 关键代码思路如下: html = getHtml(& ...
- Python爬虫(二十)_动态爬取影评信息
本案例介绍从JavaScript中采集加载的数据.更多内容请参考:Python学习指南 #-*- coding:utf-8 -*- import requests import re import t ...
- 【Python】博客信息爬取-微信消息自动发送
1.环境安装 python -m pip install --upgrade pip pip install bs4 pip install wxpy pip install lxml 2.博客爬取及 ...
- Python爬虫——使用 lxml 解析器爬取汽车之家二手车信息
本次爬虫的目标是汽车之家的二手车销售信息,范围是全国,不过很可惜,汽车之家只显示100页信息,每页48条,也就是说最多只能够爬取4800条信息. 由于这次爬虫的主要目的是使用lxml解析器,所以在信息 ...
随机推荐
- ASP.NET实现二维码
using System;using System.Collections.Generic;using System.Drawing;using System.Linq;using System.Te ...
- java 易错选择题 编辑中
1 System.out.println(int(a+b)); 编译错误 应该是(int)(a+b) 2 String s="john"+3; 是正确的,结果就是 john3 3 ...
- Springboot添加filter方法
在springboot添加filter有两种方式: (1).通过创建FilterRegistrationBean的方式(建议使用此种方式,统一管理,且通过注解的方式若不是本地调试,如果在filter中 ...
- MyBatis学习日记(二): MyBatis Say Hello
首先在Eclipse中创建一个maven工程: 在maven工程下的pom.xml文件中添加MyBatis.MySQL.Junit依赖: <project xmlns="http:// ...
- SpringBoot开发案例之打造私有云网盘
前言 最近在做工作流的事情,正好有个需求,要添加一个附件上传的功能,曾找过不少上传插件,都不是特别满意.无意中发现一个很好用的开源web文件管理器插件 elfinder,功能比较完善,社区也很活跃,还 ...
- 转载:img是什么元素?置换元素?
转载: https://blog.csdn.net/kingliguo/article/details/52643594 img是什么元素? 应是行内元素,判断一个元素是行内元素,还是块元素,无非就是 ...
- 我的工具:Db SQL Monitor
SQL Monitor 是一款界面简洁.绿色小巧的sql活动监视器,它能够帮助用户对 SQL Server 运行进程和Job进行实时监视,您可以查看当前执行的SQL/命令并终止. 工具下载地址:htt ...
- CodeForces Round #554 Div.2
A. Neko Finds Grapes 代码: #include <bits/stdc++.h> using namespace std; ; int N, M; int a[maxn] ...
- java循环1
public class f_w { public static void main(String []args) { int a=0; System.out.print("_info__w ...
- dubbo+zookeeper+jenkins从打包开始
一.jenkins中maven构建 有如下图构建设置 解释说明: pom.xml 此处jenkins打包依赖的主要配置文件(规则) settings.xml 全局配置文件,主要用于配置maven的运行 ...