
初识python 之 爬虫:使用正则表达式爬取“糗事百科 - 文字版”网页数据
初识python 之 爬虫:使用正则表达式爬取”古诗文“网页数据 的兄弟篇。
详细代码如下:
#!/user/bin env python

# author:Simple-Sir

# time:2019/8/1 14:50

# 爬取糗事百科(文字)网页数据

import requests,re

URLHead = 'https://www.qiushibaike.com'

def getHtml(url):

    headers = {

        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.100 Safari/537.36'

    }

    respons = requests.get(url,headers=headers)

    html = respons.text

    return html

def getInfos(url):

    html = getHtml(url)

    authors = re.findall(r'<h2>\n(.*?)\n</h2>',html,re.DOTALL)  # 获取作者

    author_sex_lvl = re.findall(r'<div class="articleGender (.*?)Icon">(\d*?)</div>',html,re.DOTALL)  # 获取作者性别、等级

    author_sex = []  # 性别

    author_lvl = []  # 等级

    for i in author_sex_lvl:

        author_sex.append(i[0])

        author_lvl.append(i[1])

    contentHerf = re.findall(r'<a href="(/article.*?)".*?class="contentHerf"',html,re.DOTALL)[1:]  # 获取“详细页”href

    cont = []  # 内容

    for contentUrl in contentHerf:

        contentHerf_all = URLHead + contentUrl

        contentHtml = getHtml(contentHerf_all)  # 详细页html

        contents = re.findall(r'<div class="content">(.*?)</div>',contentHtml,re.DOTALL)

        content_br = re.sub(r'<br/>','',contents[0])  # 剔除</br>标签

        content = re.sub(r'\\xa0','',content_br)

        cont.append(content)

    infos = []

    for i in zip(authors,author_sex,author_lvl,cont):

        author,sex,lvl,text=i

        info ={

            '作者':author,

            '性别': sex,

            '等级': lvl,

            '内容': text

        }

        infos.append(info)

    return infos

def main():

    page = int(input('您想获取前几页的数据?\n'))

    for i in range(1,page+1):

        url = 'https://www.qiushibaike.com/text/page/{}'.format(i)

        print('正在爬取第{}页数据:'.format(i))

        for t in getInfos(url):

            print(t)

        print('第{}页数据已爬取完成。'.format(i))

    print('所有数据已爬取完成!')

if __name__ == '__main__':

    main()
爬取糗事百科(文字)网页数据
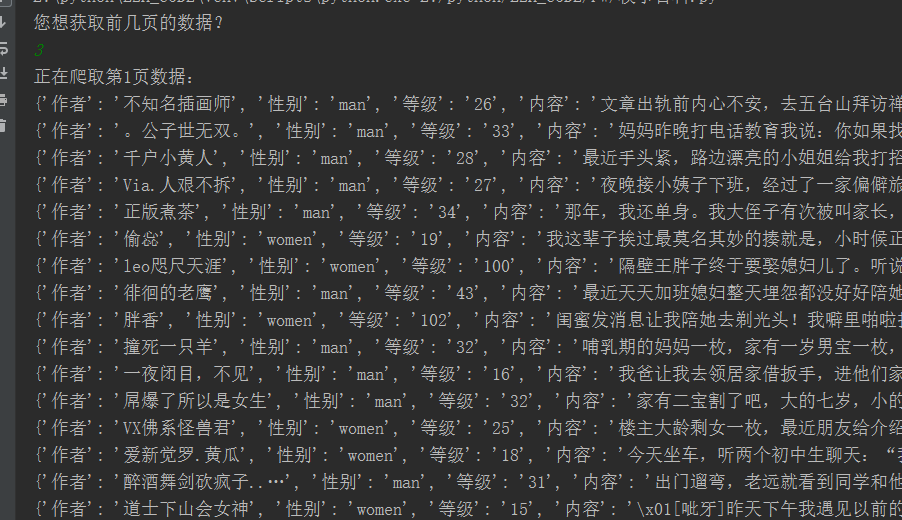
执行结果:

初识python 之 爬虫:使用正则表达式爬取“糗事百科 - 文字版”网页数据的更多相关文章
- python+正则提取+ip代理爬取糗事百科文字信息
很多网站都有反爬措施,最常见的就是封ip,请求次数过多服务器会拒绝连接,如图: 在程序中设置一个代理ip,可有效的解决这种问题,代码如下: # 需要的库 import requests import ...
- python_爬虫一之爬取糗事百科上的段子
目标 抓取糗事百科上的段子 实现每按一次回车显示一个段子 输入想要看的页数,按 'Q' 或者 'q' 退出 实现思路 目标网址:糗事百科 使用requests抓取页面 requests官方教程 使用 ...
- 爬取糗事百科热门段子的数据并保存到本地,xpath的使用
和之前的爬虫类博客的爬取思路基本一致: 构造url_list,因为糗事百科的热门栏目默认是13页,所以这个就简单了 遍历发送请求获取响应 提取数据,这里用的是xpath提取,用的是Python的第三方 ...
- 芝麻HTTP:Python爬虫实战之爬取糗事百科段子
首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把,这次我们尝试一下用爬虫把他们抓取下来. 友情提示 糗事百科在前一段时间进行了改版,导致之前的代码没法用了,会导致无法输出和CPU占用过高的 ...
- python 爬虫实战1 爬取糗事百科段子
首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把,这次我们尝试一下用爬虫把他们抓取下来. 本篇目标 抓取糗事百科热门段子 过滤带有图片的段子 实现每按一次回车显示一个段子的发布时间,发布人 ...
- Python爬虫实战之爬取糗事百科段子
首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把,这次我们尝试一下用爬虫把他们抓取下来. 友情提示 糗事百科在前一段时间进行了改版,导致之前的代码没法用了,会导致无法输出和CPU占用过高的 ...
- Python爬虫实战之爬取糗事百科段子【华为云技术分享】
首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把,这次我们尝试一下用爬虫把他们抓取下来. 友情提示 糗事百科在前一段时间进行了改版,导致之前的代码没法用了,会导致无法输出和CPU占用过高的 ...
- 2019基于python的网络爬虫系列,爬取糗事百科
**因为糗事百科的URL改变,正则表达式也发生了改变,导致了网上许多的代码不能使用,所以写下了这一篇博客,希望对大家有所帮助,谢谢!** 废话不多说,直接上代码. 为了方便提取数据,我用的是beaut ...
- 21天打造分布式爬虫-Spider类爬取糗事百科(七)
7.1.糗事百科 安装 pip install pypiwin32 pip install Twisted-18.7.0-cp36-cp36m-win_amd64.whl pip install sc ...
随机推荐
- 【Linux】【Shell】【text】sed
sed [OPTION]... 'script' [input-file] ... script: 地址定界编辑命令 ...
- 解决在进行socket通信时,一端输出流OutputStream不关闭,另一端输入流就接收不到数据
输出的数据需要达到一定的量才会向另一端输出,所以在传输数据的末端添加 \r\n 可以保证不管数据量是多少,都立刻传输到另一端.
- minikube metrics-server HPA 自动扩缩容错误
minikube metrics-server pod 错误 启动 minikube addons enable metrics-server 之后查看 metrics-server pod 会有如下 ...
- Linkerd Service Mesh 服务配置文件规范
服务配置文件 为 Linkerd 提供有关服务的附加信息. 以下是可以使用服务配置文件完成的所有操作的参考. 系列 中文手册(https://linkerd.hacker-linner.com) Sp ...
- Mysql安全加固
1.确保MYSQL_PWD环境变量未设置 描述 MYSQL_PWD环境变量的使用意味着MYSQL凭证的明文存储,极大增加MySQL凭据泄露风险. 加固建议 删除系统环境变量中MySQL密码(MYSQL ...
- CPU的负载
目录 一.简介 二.合理的负载 一.简介 使用top或者uptime命令可以看到cpu平均负载,1,5,15分钟 平均负载包括以下几个部分: 正在运行的进程.正在使用cpu做计算的进程,ps看到R 也 ...
- Wireshark(四):网络性能排查之TCP重传与重复ACK
原文出处: EMC中文支持论坛 作为网络管理员,很多时间必然会耗费在修复慢速服务器和其他终端.但用户感到网络运行缓慢并不意味着就是网络问题. 解决网络性能问题,首先从TCP错误恢复功能(TCP重传与重 ...
- 显卡不是你学习 Deep Learning 的借口
显卡不是你学习 Deep Learning 的借口 很多人在学习深度学习的时候会以自己没有 RTX N 卡的理由不动手实操,只满足于看看"娱乐"视频,听几节基础知识.当然,如果只是 ...
- GAN 简介
GAN 原理: GAN 的主要灵感来源于博弈论中零和博弈的思想,应用到深度学习神经网络上来说,就是通过生成网络 G(Generator)和判别网络 D(Discriminator)不断博弈,进而使 ...
- JAVA遍历某个文件夹下所有文件listFiles() 实现按照名称升序排序
File[] files = file.listFiles(); List fileList = Arrays.asList(files); Collections.sort(fileList, ne ...