
如何直观的解释back propagation算法?
转自:知乎-https://www.zhihu.com/question/27239198
链接:https://www.zhihu.com/question/27239198/answer/89853077
来源:知乎
著作权归作者所有,转载请联系作者获得授权。
简单的理解,它的确就是复合函数的链式法则,但其在实际运算中的意义比链式法则要大的多。
要回答题主这个问题“如何直观的解释back propagation算法?” 需要先直观理解多层神经网络的训练。
机器学习可以看做是数理统计的一个应用,在数理统计中一个常见的任务就是拟合,也就是给定一些样本点,用合适的曲线揭示这些样本点随着自变量的变化关系。
深度学习同样也是为了这个目的,只不过此时,样本点不再限定为(x, y)点对,而可以是由向量、矩阵等等组成的广义点对(X,Y)。而此时,(X,Y)之间的关系也变得十分复杂,不太可能用一个简单函数表示。然而,人们发现可以用多层神经网络来表示这样的关系,而多层神经网络的本质就是一个多层复合的函数。借用网上找到的一幅图[1],来直观描绘一下这种复合关系。
<img src="https://pic4.zhimg.com/808254232cd4983cac374c5cc2a1fc87_b.png" data-rawwidth="400" data-rawheight="282" class="content_image" width="400">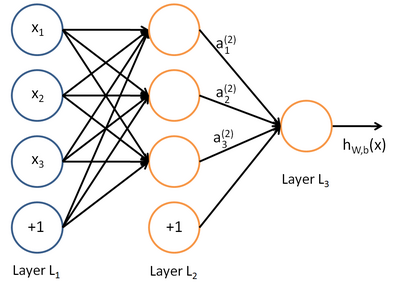
其对应的表达式如下:
<img src="https://pic4.zhimg.com/e62889afe359c859e9a6a1ad2a432ebb_b.png" data-rawwidth="474" data-rawheight="128" class="origin_image zh-lightbox-thumb" width="474" data-original="https://pic4.zhimg.com/e62889afe359c859e9a6a1ad2a432ebb_r.png">上面式中的Wij就是相邻两层神经元之间的权值,它们就是深度学习需要学习的参数,也就相当于直线拟合y=k*x+b中的待求参数k和b。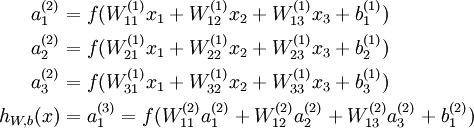
和直线拟合一样,深度学习的训练也有一个目标函数,这个目标函数定义了什么样的参数才算一组“好参数”,不过在机器学习中,一般是采用成本函数(cost function),然后,训练目标就是通过调整每一个权值Wij来使得cost达到最小。cost函数也可以看成是由所有待求权值Wij为自变量的复合函数,而且基本上是非凸的,即含有许多局部最小值。但实际中发现,采用我们常用的梯度下降法就可以有效的求解最小化cost函数的问题。
梯度下降法需要给定一个初始点,并求出该点的梯度向量,然后以负梯度方向为搜索方向,以一定的步长进行搜索,从而确定下一个迭代点,再计算该新的梯度方向,如此重复直到cost收敛。那么如何计算梯度呢?
假设我们把cost函数表示为, 那么它的梯度向量[2]就等于
, 其中
表示正交单位向量。为此,我们需求出cost函数H对每一个权值Wij的偏导数。而BP算法正是用来求解这种多层复合函数的所有变量的偏导数的利器。
我们以求e=(a+b)*(b+1)的偏导[3]为例。
它的复合关系画出图可以表示如下:
<img src="https://pic1.zhimg.com/ee59254c9432b47cfcc3b11eab3e5984_b.png" data-rawwidth="1383" data-rawheight="800" class="origin_image zh-lightbox-thumb" width="1383" data-original="https://pic1.zhimg.com/ee59254c9432b47cfcc3b11eab3e5984_r.png">在图中,引入了中间变量c,d。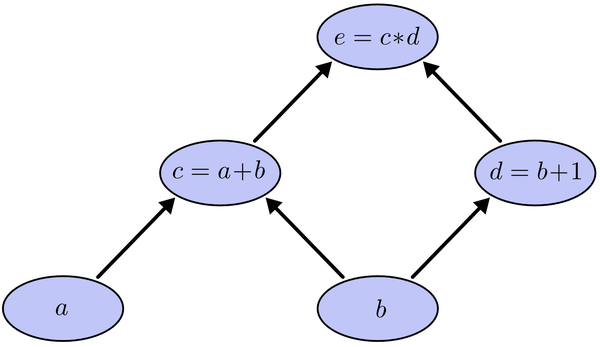 在图中,引入了中间变量c,d。
为了求出a=2, b=1时,e的梯度,我们可以先利用偏导数的定义求出不同层之间相邻节点的偏导关系,如下图所示。
<img src="https://pic2.zhimg.com/986aacfebb87f4e9573fa2fe87f439d1_b.png" data-rawwidth="1405" data-rawheight="793" class="origin_image zh-lightbox-thumb" width="1405" data-original="https://pic2.zhimg.com/986aacfebb87f4e9573fa2fe87f439d1_r.png">利用链式法则我们知道: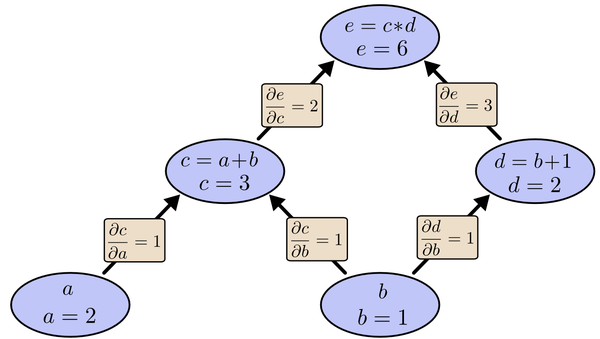 利用链式法则我们知道:
以及
。
链式法则在上图中的意义是什么呢?其实不难发现,的值等于从a到e的路径上的偏导值的乘积,而
的值等于从b到e的路径1(b-c-e)上的偏导值的乘积加上路径2(b-d-e)上的偏导值的乘积。也就是说,对于上层节点p和下层节点q,要求得
,需要找到从q节点到p节点的所有路径,并且对每条路径,求得该路径上的所有偏导数之乘积,然后将所有路径的 “乘积” 累加起来才能得到
的值。
大家也许已经注意到,这样做是十分冗余的,因为很多路径被重复访问了。比如上图中,a-c-e和b-c-e就都走了路径c-e。对于权值动则数万的深度模型中的神经网络,这样的冗余所导致的计算量是相当大的。
同样是利用链式法则,BP算法则机智地避开了这种冗余,它对于每一个路径只访问一次就能求顶点对所有下层节点的偏导值。
正如反向传播(BP)算法的名字说的那样,BP算法是反向(自上往下)来寻找路径的。
从最上层的节点e开始,初始值为1,以层为单位进行处理。对于e的下一层的所有子节点,将1乘以e到某个节点路径上的偏导值,并将结果“堆放”在该子节点中。等e所在的层按照这样传播完毕后,第二层的每一个节点都“堆放"些值,然后我们针对每个节点,把它里面所有“堆放”的值求和,就得到了顶点e对该节点的偏导。然后将这些第二层的节点各自作为起始顶点,初始值设为顶点e对它们的偏导值,以"层"为单位重复上述传播过程,即可求出顶点e对每一层节点的偏导数。
以上图为例,节点c接受e发送的1*2并堆放起来,节点d接受e发送的1*3并堆放起来,至此第二层完毕,求出各节点总堆放量并继续向下一层发送。节点c向a发送2*1并对堆放起来,节点c向b发送2*1并堆放起来,节点d向b发送3*1并堆放起来,至此第三层完毕,节点a堆放起来的量为2,节点b堆放起来的量为2*1+3*1=5, 即顶点e对b的偏导数为5.
举个不太恰当的例子,如果把上图中的箭头表示欠钱的关系,即c→e表示e欠c的钱。以a, b为例,直接计算e对它们俩的偏导相当于a, b各自去讨薪。a向c讨薪,c说e欠我钱,你向他要。于是a又跨过c去找e。b先向c讨薪,同样又转向e,b又向d讨薪,再次转向e。可以看到,追款之路,充满艰辛,而且还有重复,即a, b 都从c转向e。
而BP算法就是主动还款。e把所欠之钱还给c,d。c,d收到钱,乐呵地把钱转发给了a,b,皆大欢喜。
------------------------------------------------------------------
【参考文献】
[1] 技术向:一文读懂卷积神经网络CNN
[2] Gradient
[3] http://colah.github.io/posts/2015-08-Backprop/
其他推荐网页:
1. tensorflow.org 的页面
2. Neural networks and deep learning
如何直观的解释back propagation算法?的更多相关文章
- 神经网络中误差反向传播(back propagation)算法的工作原理
注意:版权所有,转载需注明出处. 神经网络,从大学时候就知道,后面上课的时候老师也讲过,但是感觉从来没有真正掌握,总是似是而非,比较模糊,好像懂,其实并不懂. 在开始推导之前,需要先做一些准备工作,推 ...
- BP 算法之一种直观的解释
0. 前言 之前上模式识别课程的时候,老师也讲过 MLP 的 BP 算法, 但是 ppt 过得太快,只有一个大概印象.后来课下自己也尝试看了一下 stanford deep learning 的 wi ...
- [直观学习排序算法] 视觉直观感受若干常用排序算法 以及 iOS 资料
http://www.zhfish.net/?s=点击范围 1 快速排序 介绍: 快速排序是由东尼·霍尔所发展的一种排序算法.在平均状况下,排序 n 个项目要Ο(n log n)次比较.在最坏状况下则 ...
- 对于fmri的设计矩阵构造的一个很直观的解释-by 西南大学xulei教授
本程序意在解释这样几个问题:完整版代码在本文的最后. 1.实验的设计如何转换成设计矩阵? 2.设计矩阵的每列表示一个刺激条件,如何确定它们? 3.如何根据设计矩阵和每个体素的信号求得该体素对刺激的敏感 ...
- 对于fmri的hrf血液动力学响应函数的一个很直观的解释-by 西南大学xulei教授
%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%% clear all;clc; %%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%% ...
- 形象解释各种卷积算法(Convolution animations)
No padding, no strides Arbitrary padding, no strides Half padding, no strides Full padding, no strid ...
- 五种编程语言解释数据结构与算法——顺序表1(理论与C语言实现)
1.线性表的分类 2.线性表的定义及其基本操作 2.1.定义:线性表是具有相同类型的n(n>=0)个元素的有序序列,其中n为表长,当n=0时,该表为空表. 2.3.线性表的逻辑结构为: 2.4. ...
- 五种编程语言解释数据结构与算法——顺序表3(JavaScript与Python语言实现)
7.JavaScript语言实现 7.1.用ES6语法编写顺序表类 //1.创建类 class MyList { //1. initList(&L):初始化表.构造一个空的线性表.放回值应该是 ...
- 五种编程语言解释数据结构与算法——顺序表2(java与C++语言实现)
5.java实现方式: 5.1.顺序表的抽象结构 package com.xgp.顺序表; public interface MyList<T> { //1. initList(& ...
随机推荐
- 【Python】迭代器
对迭代器和生成器的概念一直很混乱,总结一下: 迭代器: 1.所谓的迭代器,就是具有__next__()方法的对象: 2.__iter__()方法返回一个迭代器对象,这个对象必须具有__next__() ...
- Python学习笔记——基础篇【第六周】——logging模块
常用模块之logging 用于便捷记录日志且线程安全的模块 import logging logging.basicConfig(filename='log.log', format='%(ascti ...
- Elastarchsearch安装搭建(一)
Elasticsearch是一个实时分布式搜索和分析引擎.一个基于Apache Lucene(TM)的开源搜索引擎.无论在开源还是专有领域,Lucene可以被认为是迄今为止最先进.性能最好的.功能最全 ...
- Egret 学习之 入口函数 及开始编写程序(三)
1,Egret的程序入口: C和java是以一个main函数作为入口,但egret类似于ActionScript 是以一个文档类作为入口,确切的说是以这个文档类的构造函数作为入口: 2,文档类的构造函 ...
- Abstract和Virtual
在C#的学习中,容易混淆virtual方法和abstract方法的使用,现在来讨论一下二者的区别. 它们有一个共同点:二者都是用来修饰父类的,只能作为基类使用,通过覆盖父类的定义,让子类与overri ...
- Struts2 Spring3 Hibernate3 集成xml版本
Struts2 Struts2是一个基于MVC设计模式的Web应用框架,它本质上相当于一个servlet,在MVC设计模式中,Struts2作为控制器(Controller)来建立模型与视图的数据交互 ...
- 常用python处理try except异常的三种方式
如果你在写python程序时遇到异常后想进行如下处理的话,一般用try来处理异常,假设有下面的一段程序: try: 语句1 语句2 . . 语句N except ...
- C# 从零开始 vol.1
说好的java只能先坑了,毕竟计划赶不上变化,以下是 c# 基础部分. 1:变量,方法的命名方式 目的就是一眼看到实例名 方法名 就知道该变量是做什么的. 主流的命名方式有驼峰命名规则,pascal命 ...
- js检测文章敏感词
在一些博客或者论坛中,文章中的敏感词需要显示出来和高亮显示起到提示用户的作用.这个功能实现的方法有很多,下面是js的实现方式. //将文章中匹配到的敏感词罗列出来 <span style=&qu ...
- Android:关于Edittext的一些设置
1.自动弹出输入框. et_order_search.setFocusableInTouchMode(true); et_order_search.requestFocus(); CmzBossApp ...