
Hadoop(2)--hdfs
 Hadoop(2)
Hadoop底层封装的的是HDFS和MapReduce两种框架
在Hdfs中采用的是主从结构(Madter-slaver)就像领导和员工一样,领导负责整个公司的管理工作,而员工就负责向领导汇报工作以及完成领导分发的任务
在HDFS中,NameNode(Master)就负责对整个集群中节点的管理以及维护文件系统树以及文件目录。而DataNode分布在不同的机架上,就像是员工分布在公司别的不同部门一样,在客户端或者领导NameNode的调度下,存储并检索数据块,并定期向NameNode发送所存储的数据块的列表,报告自己的情况,可以让NameNode随时掌握整个集群的资源情况。
概念解释
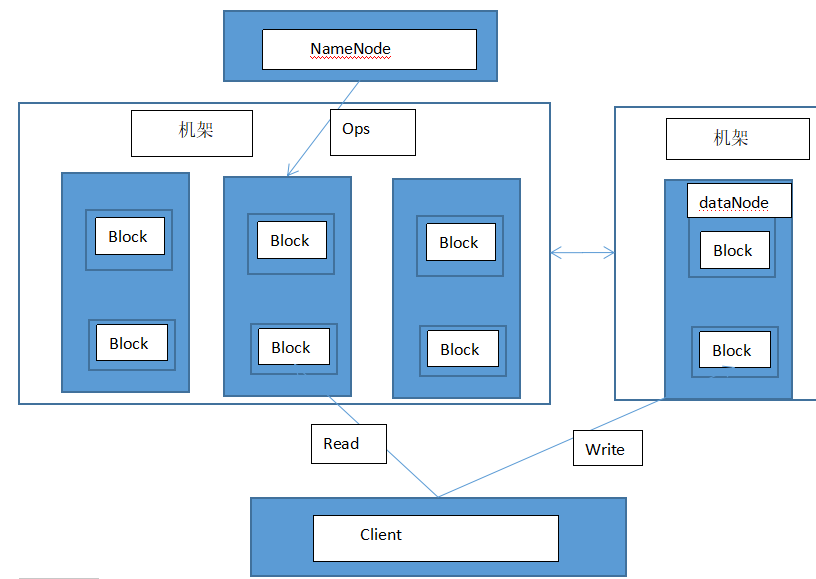
机架:HDFS集群主要是由分布在不同机架上的多个机架的DataNode组成的,相同机架上的机器之间通过TCP协议进行相应的连接(7077端口),不同机架上的节点通过交换机进行通信,HDFS会通过机架感知策略感知每一个DataNode所属的机架,使用副本放置策略来改进数据的可靠性、可用性和网络带宽的利用率
机架感知策咯:在源码中就是通过判断机架中各个节点与NameNode节点的距离进行判断
分别为0(同一个节点的不同块上)、1(同一个机架的不同节点上)、3(同一个机房的不同机架上)、4(不同的机房)
副本放置策略:为了防止数据意外丢失,就像我们会对手机中的数据在电脑上进行备份一样,我们也会在节点上对数据进行一个备份,默认的是3个备份,
第一个block副本放在和client所在的node里(如果client不在集群范围内,则这第一个node是随机选取的,当然系统会尝试不选择哪些太满或者太忙的node)。
第二个副本放置在与第一个节点不同的机架中的node中(随机选择)。
第三个副本和第二个在同一个机架,随机放在不同的node中。
如果还有更多的副本就随机放在集群的node里
通过这一策略,当发生意外断电等情况的时候还在其余的机架或者几点上进行了数据的存储,可以去其他的数据放置处重新获得数据进行计算,尽量的减少了数据丢失的可能
心跳:在Hdfs中,节点之间通过TCP协议进行通信,DataNode每3s向NameNode发送一个心跳,每10次心跳之后向NameNode发送一个数据块报告自己的信息,通过这些信息,NameNode能够在发生意外之后可以重新创建元数据,并确保每个数据块有足够的副本
元数据:存储在NameNode中,是文件系统中的文件和目录的属性信息,当NameNode启动的时候会创建fsimage和edit.log两个文件(fsimage存储的是文件metadata信息,不包括文件块的位置信息(位置信息是NameNode存放在内存中),edit文件存放是的文件系统的所有更新操作的路径,他们两个都是经过序列化的,当NameNode失败之后,文件metadata信息可以加载fsimage到内存中,在editlog中应用相应的操作)当遇到checkpoint进行触发后,secondaryNameNode会定时的将fsimage和editlog进行合并更新,NameNode就可以随时掌握集群的状态信息,
Client:就是客户端。
文件切分。文件上传 HDFS 的时候,Client 将文件切分成 一个一个的Block,然后进行存储。
与 NameNode 交互,获取文件的位置信息。
与 DataNode 交互,读取或者写入数据。
Client 提供一些命令来管理 HDFS,比如启动或者关闭HDFS。
Client 可以通过一些命令来访问 HDFS。
HDFS读写操作:
1、读操作:

|
1、client向namenode请求下载文件
2、Namenode会判断client是否有权向,如果有权限的话会将datanode的元数据信息返回给client
3、Client按照距离和顺序去读取datanode中的block,当datanode发生异常的话会进行记录并上传给datanode节点,剩余的数据读取会略过这个节点bi
4、读取block之后通过append将block整合成一个完整的文件进行使用
读文件的方法:
1、HDFS API
2、HDFS Client Cmd:
Hdfs dfs -get [ignorecrc] [-crc] <src> <localdst>
2、写操作:
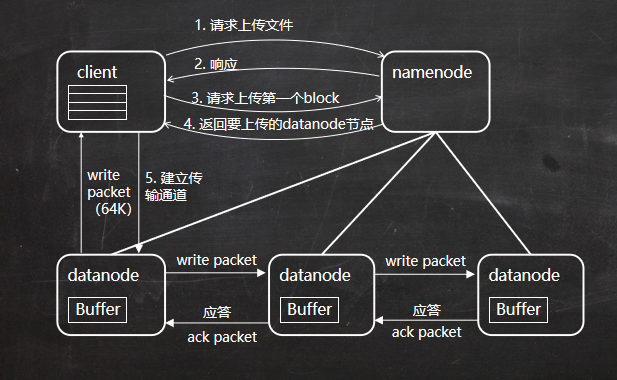
1、client向namenode发送请求,请求上传文件
2、Namenode会检查常见的文件是否存在以及client是否有操作权限并对client进行响应
3、当客户端开始上传文件的时候会将文件写个成多个packet并在内部已dataqueue的形式进行管理,并向namenode申请blocks进行存储
4、namenode获取适合存储的datanode列表,并根据replicationi进行列表大小的设定
5、建立传输通道将packet写入到datanode当中,在第一个datanode存储packet之后,通过管道将其传送给下一个datanode直到最后一个datanode
6、最后一个datanode存储成功后会返回一个ack packet队列,在pipeline中返回到客户端,当ack成功返回客户端之后,相应的packet会从dataqueue中删除
7、依次进行,直至所有的数据传输完毕
Hadoop(2)--hdfs的更多相关文章
- hadoop(三)HDFS 文件系统
Hadoop 附带了一个名为 HDFS(Hadoop 分布式文件系统)的分布式文件系统,专门 存储超大数据文件,为整个 Hadoop 生态圈提供了基础的存储服务. 本章内容: 1) HDFS 文件系统 ...
- Hadoop(四)HDFS集群详解
前言 前面几篇简单介绍了什么是大数据和Hadoop,也说了怎么搭建最简单的伪分布式和全分布式的hadoop集群.接下来这篇我详细的分享一下HDFS. HDFS前言: 设计思想:(分而治之)将大文件.大 ...
- Hadoop(七)HDFS容错机制详解
前言 HDFS(Hadoop Distributed File System)是一个分布式文件系统.它具有高容错性并提供了高吞吐量的数据访问,非常适合大规模数据集上的应用,它提供了一个高度容错性和高吞 ...
- hadoop(五)HDFS原理剖析
一.HDFS的工作机制 工作机制的学习主要是为加深对分布式系统的理解,以及增强遇到各种问题时的分析解决能 力,形成一定的集群运维能力PS:很多不是真正理解 hadoop 工作原理的人会常常觉得 HDF ...
- hadoop(四)HDFS的核心设计
一.hadoop心跳机制(heartbeat) 1. Hadoop 是 Master/Slave 结构, Master 中有 NameNode 和 ResourceManager, Slave 中有 ...
- hadoop(三)HDFS基础使用
一.HDFS前言 1. 设计思想 分而治之:将大文件,大批量文件,分布式的存放于大量服务器上.以便于采取分而治之的方式对海量数据进行运算分析 2. 在大数据系统架构中的应用 ...
- Hadoop(四)HDFS的高级API操作
一 HDFS客户端环境准备 1.1 jar包准备 1)解压hadoop-2.7.6.tar.gz到非中文目录 2)进入share文件夹,查找所有jar包,并把jar包拷贝到_lib文件夹下 3)在全部 ...
- Hadoop(三)HDFS读写原理与shell命令
一 HDFS概述 1.1 HDFS产生背景 随着数据量越来越大,在一个操作系统管辖的范围内存不下了,那么就分配到更多的操作系统管理的磁盘中,但是不方便管理和维护,迫切需要一种系统来管理多台机器上的文件 ...
- Hadoop(五)—— HDFS NameNode、DataNode工作机制
一.NN与2NN工作机制 NameNode(NN) 1.当HDFS启动时,会加载日志(edits)和镜像文件(fsImage)到内存中. 2-4.当元数据的增删改查请求进来时,NameNode会先将操 ...
随机推荐
- (转)Android新的menu实现——ActionMode
Android的menu有多种实现方式,以前写过一篇Android中五种常用的menu(菜单),这里介绍一种新的menu实现方式:ActionMode.ActionMode是Android 3.0以后 ...
- 《ArcGIS Runtime SDK for Android开发笔记》——(10)、ArcGIS Runtime SDK支持的空间数据类型
1.前言 移动端的数据来源非常重要,它决定了移动端功能的实现.早期的ArcGIS Android API中,主要以接入在线的数据源为主,因此主要实现在线的地图浏览.查询和路径分析.地理处理等从操作:在 ...
- 多线程(四)~数据操作的原子性,使用原子性操作AutomicInteger替换非原子性的i++的操作
这一章,我们要来验证volatile关键字不是原子性的,OK,还是用代码来说话. ①.线程类,操作i++ 500次 package com.multiThread.thread; publicclas ...
- 在科技圈不懂“机器学习”?那你就out了
当联网的终端设备越来越多时,产生的信息数据也将呈指数式增长,大型.复杂.增长快速的数据收集已经无处不在.而机器学习能够扩增这些数据的价值,并基于这些趋势提出更广泛的应用情境. 那么,被人们津津乐道的机 ...
- asyncio标准库7 Producer/consumer
使用asyncio.Queue import asyncio import random async def produce(queue, n): for x in range(1, n + 1): ...
- day012-Lambda、方法引用
1. 函数式接口 有且只有一个抽象方法的接口就是函数式接口. 函数式接口的定义格式: Interface 接口名{ 抽象方法: } @Override:用来修饰方法声明,告诉编译器该方法是重写父类的方 ...
- 深度剖析hdfs原理
大数据底层技术的三大基石起源于Google在2006年之前的三篇论文GFS.Map-Reduce. Bigtable,其中GFS.Map-Reduce技术直接支持了Apache Hadoop项目的诞生 ...
- 数据结构与算法分析java——线性表3 (LinkedList)
1. LinkedList简介 LinkedList 是一个继承于AbstractSequentialList的双向链表.它也可以被当作堆栈.队列或双端队列进行操作.LinkedList 实现 Lis ...
- Document flow API in SAP CRM and C4C
Document flow API in CRM 以一个具体的例子来说明.在Appointment的Overview page上能看见一个名叫Reference的区域,这里可以维护一些其他的业务文档的 ...
- 《编程导论(Java)·9.3.1回调·3》回调的实现
版权声明:本文为博主原创文章,未经博主同意不得转载. https://blog.csdn.net/yqj2065/article/details/31441221 接<9.3.1Java回调 · ...