
python+正则提取+ip代理爬取糗事百科文字信息
很多网站都有反爬措施,最常见的就是封ip,请求次数过多服务器会拒绝连接,如图;
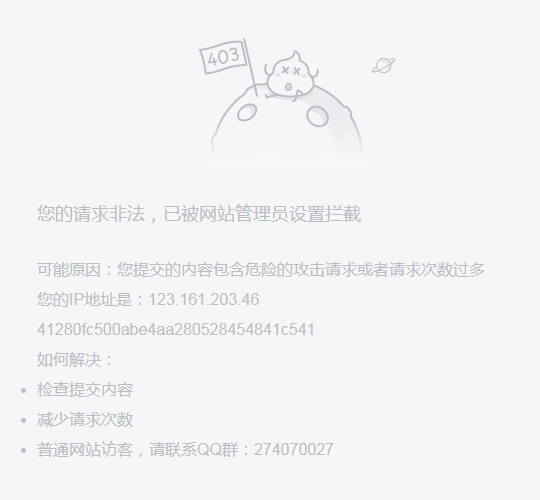
在程序中设置一个代理ip,可有效的解决这种问题,代码如下;
# 需要的库

import requests

import re

from multiprocessing import Pool

# 设置代理ip

proxy = {

'https':'111.231.140.109:8888'

}

# 请求头

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/65.0.3325.181 Safari/537.36'

}

# 主函数

def get_character(url):

    # 请求网页,里面加入代理ip

    response = requests.get(url,headers,proxies=proxy)

    # 正则提取内容(作者昵称,内容,好笑数量,评论数量)

    data = re.findall('<h2>(.*?)</h2>.*?<div class="content">.*?<span>(.*?)</span>.*?</div>.*?<span class="stats-vote">.*?'

                          '<i class="number">(.*?)</i>(.*?)</span>.*?<i class="number">(.*?)</i>(.*?)</a>',response.text,re.S)

    # 遍历获取到的数据

    for i in data:

        # 以追加方式写入当前文件加下的qiubai.txt

        with open('qiubai.txt','a+',encoding='utf8') as f:

            # 转换为字符串格式,去空格,替换掉多余内容每条内容加换行

            f.write(str(i).strip().replace(r'\n','')+'\n')

            # 控制台打印查看爬取过程

            print(str(i).strip().replace(r'\n','')+'\n')

# 程序入口

if __name__ == '__main__':

    # 构造所有url

    urls = ['https://www.qiushibaike.com/text/page/{}/'.format(i) for i in range(1,14)]

    # 开启多进程

    pool = Pool()

    # 启动程序

    pool.map(get_character,urls)

    print('爬取完毕')
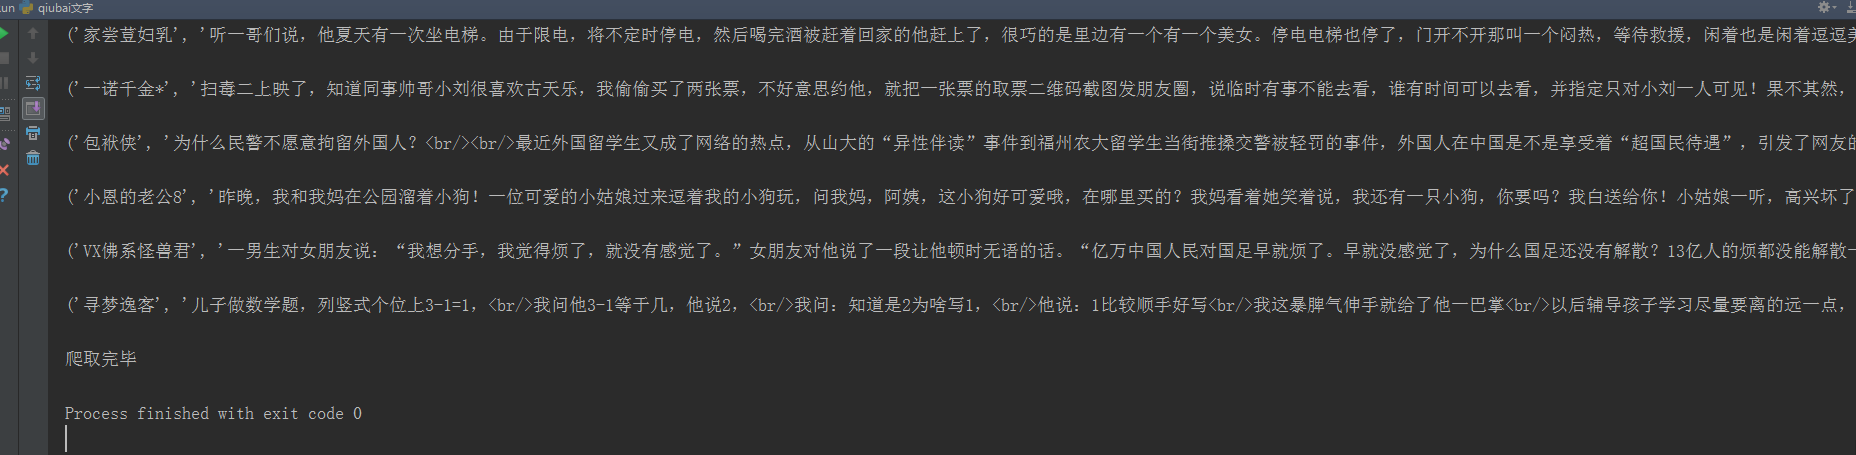
控制台输出;
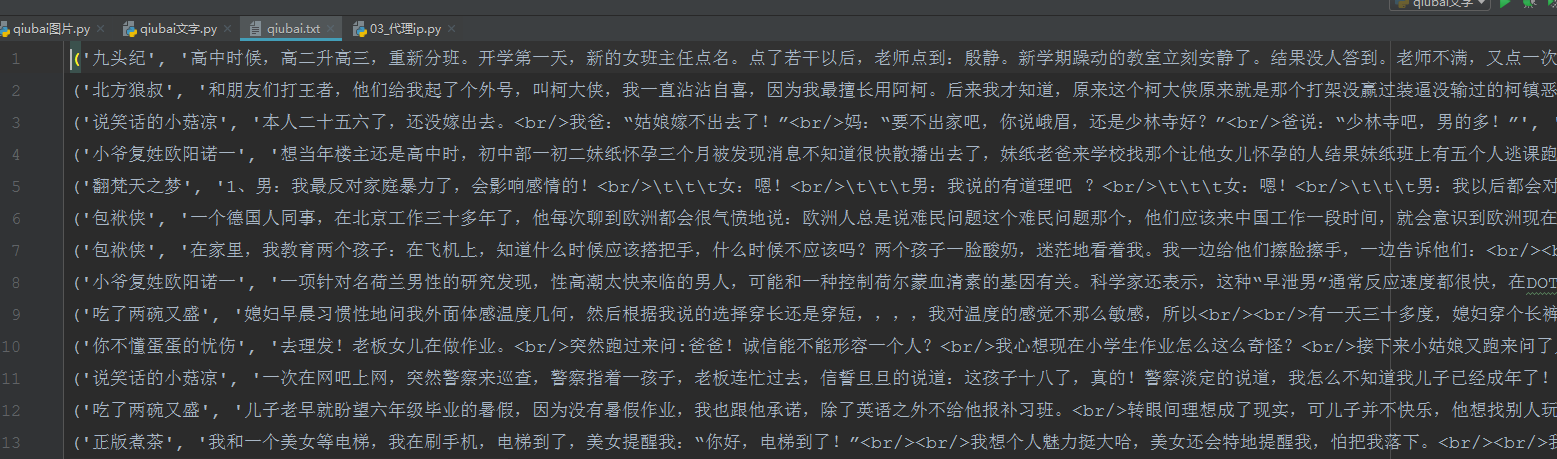
打开文件夹查看是否下载成功;
done
python+正则提取+ip代理爬取糗事百科文字信息的更多相关文章
- Python爬虫实战一之爬取糗事百科段子
大家好,前面入门已经说了那么多基础知识了,下面我们做几个实战项目来挑战一下吧.那么这次为大家带来,Python爬取糗事百科的小段子的例子. 首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把 ...
- 转 Python爬虫实战一之爬取糗事百科段子
静觅 » Python爬虫实战一之爬取糗事百科段子 首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把,这次我们尝试一下用爬虫把他们抓取下来. 友情提示 糗事百科在前一段时间进行了改版,导致 ...
- 初识python 之 爬虫:使用正则表达式爬取“糗事百科 - 文字版”网页数据
初识python 之 爬虫:使用正则表达式爬取"古诗文"网页数据 的兄弟篇. 详细代码如下: #!/user/bin env python # author:Simple-Sir ...
- 8.Python爬虫实战一之爬取糗事百科段子
大家好,前面入门已经说了那么多基础知识了,下面我们做几个实战项目来挑战一下吧.那么这次为大家带来,Python爬取糗事百科的小段子的例子. 首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把 ...
- python爬虫29 | 使用scrapy爬取糗事百科的例子,告诉你它有多厉害!
是时候给你说说 爬虫框架了 使用框架来爬取数据 会节省我们更多时间 很快就能抓取到我们想要抓取的内容 框架集合了许多操作 比如请求,数据解析,存储等等 都可以由框架完成 有些小伙伴就要问了 你他妈的 ...
- python_爬虫一之爬取糗事百科上的段子
目标 抓取糗事百科上的段子 实现每按一次回车显示一个段子 输入想要看的页数,按 'Q' 或者 'q' 退出 实现思路 目标网址:糗事百科 使用requests抓取页面 requests官方教程 使用 ...
- [爬虫]用python的requests模块爬取糗事百科段子
虽然Python的标准库中 urllib2 模块已经包含了平常我们使用的大多数功能,但是它的 API 使用起来让人感觉不太好,而 Requests 自称 “HTTP for Humans”,说明使用更 ...
- python网络爬虫--简单爬取糗事百科
刚开始学习python爬虫,写了一个简单python程序爬取糗事百科. 具体步骤是这样的:首先查看糗事百科的url:http://www.qiushibaike.com/8hr/page/2/?s=4 ...
- python爬虫之爬取糗事百科并将爬取内容保存至Excel中
本篇博文为使用python爬虫爬取糗事百科content并将爬取内容存入excel中保存·. 实验环境:Windows10 代码编辑工具:pycharm 使用selenium(自动化测试工具)+p ...
随机推荐
- python字符串拼接N种姿势
字符串大家都不陌生,应用比较广泛,强大,总是会给你一些惊喜的数据类型.我们本篇文章主要介绍的就是关于字符串的多种方法的拼接. 第一种:直接通过+号拼接 输出结果: 2.通过 str.join()方法拼 ...
- Efficient and Accurate Arbitrary-Shaped Text Detection with Pixel Aggregation Network(利用像素聚合网络进行高效准确的任意形状文本检测)
PSENet V2昨日刚出,今天翻译学习一下. 场景文本检测是场景文本阅读系统的重要一步,随着卷积神经网络的快速发展,场景文字检测也取得了巨大的进步.尽管如此,仍存在两个主要挑战,它们阻碍文字检测部署 ...
- Java泛型之通配符
原文点此链接 使用通配符的原因:Java中的数组是协变的,但是泛型不支持协变. 数组的协变 首先了解下什么是数组的协变,看下面的例子: Number[] nums = new Integer[10]; ...
- nginx添加sticky模块-cookie保持会话
cookie不同于session,一个存于客户端,一个存于服务端. 环境nginx 1.8.0 centos6.X sticky:1.2.5 wget https://bitbucket.org/n ...
- png8和png24的根本区别
1.png8和png24的根本区别,不是颜色位的区别,而是存储方式不同. 2.png8有1位的布尔透明通道(要么完全透明,要么完全不透明),png24则有8位(256阶)的布尔透明通道(所谓半透明). ...
- sqlalchemy python中的mysql数据库神器
在介绍sqlalchemy之前,我们先了解一下ORM. ORM 全称 Object Relational Mapping, 翻译过来叫对象关系映射.也就是说ORM 将数据库中的表与面向对象语言中的类建 ...
- Retrofit 二次封装实践
首先感谢这位大神的博客:https://blog.csdn.net/u014569233/article/details/67639522,在他的基础上根据自己项目进行了修改最后成为现在项目使用的样子 ...
- sk-learn 选择正确的估算器
选择正确的估算器 解决机器学习问题最困难的部分通常是为工作找到正确的估算器. 不同的估计器更适合于不同类型的数据和不同的问题. 下面的流程图旨在为用户提供一些关于如何处理有关哪些估算器尝试数据的问题的 ...
- 【windows】win10局域网共享文件夹
1.打开 2.共享文件夹 另一台局域网电脑可根据共享的电脑ip访问就可以了[格式:\\ip] 如果右键文件夹没有共享选项
- Swagger2生成后台的API文档
添加依赖: <!--Swagger2API生成--> <dependency> <groupId>io.springfox</groupId> < ...