
Hadoop: 单词计数(Word Count)的MapReduce实现
1.Map与Reduce过程
1.1 Map过程
首先,Hadoop会把输入数据划分成等长的输入分片(input split) 或分片发送到MapReduce。Hadoop为每个分片创建一个map任务,由它来运行用户自定义的map函数以分析每个分片中的记录。在我们的单词计数例子中,输入是多个文件,一般一个文件对应一个分片,如果文件太大则会划分为多个分片。map函数的输入以<key, value>形式做为输入,value为文件的每一行,key为该行在文件中的偏移量(一般我们会忽视)。这里map函数起到的作用为将每一行进行分词为多个word,并在context中写入<word, 1>以代表该单词出现一次。
map过程的示意图如下:

mapper代码编写如下:
public static class TokenizerMapper

        extends Mapper<Object, Text, Text, IntWritable> {

    private final static IntWritable one = new IntWritable(1);

    private Text word = new Text();

    public void map(Object key, Text value, Context context) throws IOException, InterruptedException {

        //每次处理一行,一个mapper里的value为一行,key为该行在文件中的偏移量

        StringTokenizer iter = new StringTokenizer(value.toString());

        while (iter.hasMoreTokens()) {

            word.set(iter.nextToken());

            // 向context中写入<word, 1>

            context.write(word, one);

            System.out.println(word);

        }

    }

}
如果我们能够并行处理分片(不一定是完全并行),且分片是小块的数据,那么处理过程将会有一个好的负载平衡。但是如果分片太小,那么管理分片与map任务创建将会耗费太多时间。对于大多数作业,理想分片大小为一个HDFS块的大小,默认是64MB。
map任务的执行节点和输入数据的存储节点相同时,Hadoop的性能能达到最佳,这就是计算机系统中所谓的data locality optimization(数据局部性优化)。而最佳分片大小与块大小相同的原因就在于,它能够保证一个分片存储在单个节点上,再大就不能了。
1.2 Reduce过程
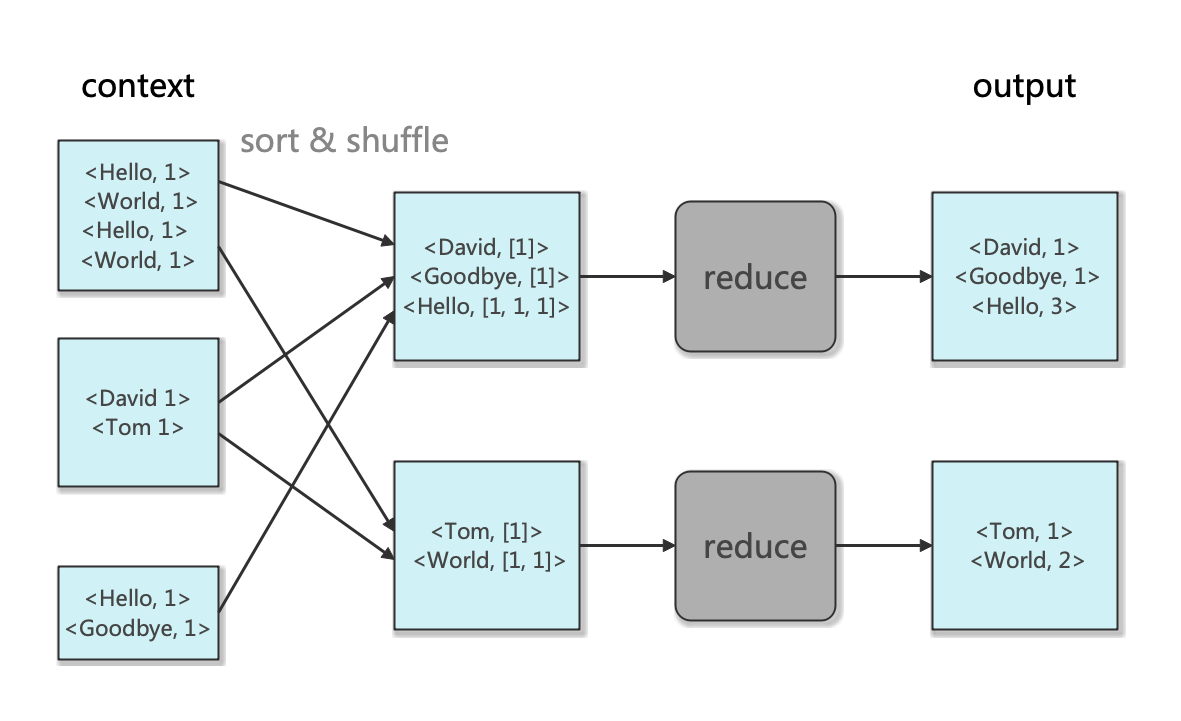
接下来我们看reducer的编写。reduce任务的多少并不是由输入大小来决定,而是需要人工单独指定的(默认为1个)。和上面map不同的是,reduce任务不再具有本地读取的优势————一个reduce任务的输入往往来自于所有mapper的输出,因此map和reduce之间的数据流被称为 shuffle(洗牌) 。Hadoop会先按照key-value对进行排序,然后将排序好的map的输出通过网络传输到reduce任务运行的节点,并在那里进行合并,然后传递到用户定义的reduce函数中。
reduce 函数示意图如下:
reducer代码编写如下:
 public static class IntSumReducer

            extends Reducer<Text, IntWritable, Text, IntWritable>{

        private IntWritable result = new IntWritable();

        public void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException{

            int sum = 0;

            for (IntWritable val : values) {

                sum += val.get();

            }

            result.set(sum);

            context.write(key, result);

        }

    }
2.完整代码
2.1 项目架构
关于VSCode+Java+Maven+Hadoop开发环境搭建,可以参见我的博客《VSCode+Maven+Hadoop开发环境搭建》,此处不再赘述。这里展示我们的项目架构图:
Word-Count-Hadoop

├─ input

│  ├─ file1

│  ├─ file2

│  └─ file3

├─ output

├─ pom.xml

├─ src

│  └─ main

│     └─ java

│        └─ WordCount.java

└─ target
WordCount.java代码如下:
import java.io.IOException;

import java.util.StringTokenizer;

import org.apache.hadoop.fs.FileSystem;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.Mapper;

import org.apache.hadoop.mapreduce.Reducer;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

public class WordCount{

    public static class TokenizerMapper

            extends Mapper<Object, Text, Text, IntWritable> {

        private final static IntWritable one = new IntWritable(1);

        private Text word = new Text();

        public void map(Object key, Text value, Context context) throws IOException, InterruptedException {

        //每次处理一行,一个mapper里的value为一行,key为该行在文件中的偏移量

            StringTokenizer iter = new StringTokenizer(value.toString());

            while (iter.hasMoreTokens()) {

                word.set(iter.nextToken());

                // 向context中写入<word, 1>

                context.write(word, one);

            }

        }

    }

    public static class IntSumReducer

            extends Reducer<Text, IntWritable, Text, IntWritable>{

        private IntWritable result = new IntWritable();

        public void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException{

            int sum = 0;

            for (IntWritable val : values) {

                sum += val.get();

            }

            result.set(sum);

            context.write(key, result);

        }

    }

    public static void main(String[] args) throws Exception{

        Configuration conf = new Configuration();

        Job job = Job.getInstance(conf, "word_count");

        job.setJarByClass(WordCount.class);

        job.setMapperClass(TokenizerMapper.class);

        //此处的Combine操作意为即第每个mapper工作完了先局部reduce一下,最后再全局reduce

        job.setCombinerClass(IntSumReducer.class);

        job.setReducerClass(IntSumReducer.class);

        job.setOutputKeyClass(Text.class);

        job.setOutputValueClass(IntWritable.class);

        //第0个参数是输入目录,第1个参数是输出目录

        //先判断output path是否存在,如果存在则删除

        Path path = new Path(args[1]);//

        FileSystem fileSystem = path.getFileSystem(conf);

        if (fileSystem.exists(path)) {

            fileSystem.delete(path, true);

        }

        //设置输入目录和输出目录

        FileInputFormat.addInputPath(job, new Path(args[0]));

        FileOutputFormat.setOutputPath(job, new Path(args[1]));

        System.exit(job.waitForCompletion(true)?0:1);

    }

}
pom.xml中记得配置Hadoop的依赖环境:
    ...

  <!-- 集中定义版本号 -->

  <properties>

    <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>

    <maven.compiler.source>17</maven.compiler.source>

    <maven.compiler.target>17</maven.compiler.target>

    <hadoop.version>3.3.1</hadoop.version>

  </properties>

  <dependencies>

    <dependency>

      <groupId>junit</groupId>

      <artifactId>junit</artifactId>

      <version>4.11</version>

      <scope>test</scope>

    </dependency>

    <!-- 导入hadoop依赖环境 -->

    <dependency>

        <groupId>org.apache.hadoop</groupId>

        <artifactId>hadoop-common</artifactId>

        <version>${hadoop.version}</version>

    </dependency>

    <dependency>

        <groupId>org.apache.hadoop</groupId>

        <artifactId>hadoop-hdfs</artifactId>

        <version>${hadoop.version}</version>

    </dependency>

    <dependency>

        <groupId>org.apache.hadoop</groupId>

        <artifactId>hadoop-mapreduce-client-core</artifactId>

        <version>${hadoop.version}</version>

    </dependency>

    <dependency>

        <groupId>org.apache.hadoop</groupId>

        <artifactId>hadoop-client</artifactId>

        <version>${hadoop.version}</version>

    </dependency>

    <dependency>

        <groupId>org.apache.hadoop</groupId>

        <artifactId>hadoop-yarn-api</artifactId>

        <version>${hadoop.version}</version>

    </dependency>

  </dependencies>

  ...

</project>
此外,因为我们的程序自带输入参数,我们还需要在VSCode的launch.json中配置输入参数intput(代表输入目录)和output(代表输出目录):
...

"args": [

    "input",

    "output"

],

...
编译运行完毕后,可以查看output文件夹下的part-r-00000文件:
David	1

Goodbye	1

Hello	3

Tom	1

World	2
可见我们的程序正确地完成了单词计数的功能。
参考
- [1] Hadoop官方文档:MapReduce Tutorial
- [2] White T. Hadoop: The definitive guide[M]. " O'Reilly Media, Inc.", 2012.
- [3] Stack Overflow: What is the purpose of shuffling and sorting phase in the reducer in Map Reduce Programming?
Hadoop: 单词计数(Word Count)的MapReduce实现的更多相关文章
- Spark: 单词计数(Word Count)的MapReduce实现(Java/Python)
1 导引 我们在博客<Hadoop: 单词计数(Word Count)的MapReduce实现 >中学习了如何用Hadoop-MapReduce实现单词计数,现在我们来看如何用Spark来 ...
- 基于 MapReduce 的单词计数(Word Count)的实现
完整代码: // 导入必要的包 import java.io.IOException; import java.util.StringTokenizer; import org.apache.hado ...
- hadoop笔记之MapReduce的应用案例(WordCount单词计数)
MapReduce的应用案例(WordCount单词计数) MapReduce的应用案例(WordCount单词计数) 1. WordCount单词计数 作用: 计算文件中出现每个单词的频数 输入结果 ...
- Hadoop分布环境搭建步骤,及自带MapReduce单词计数程序实现
Hadoop分布环境搭建步骤: 1.软硬件环境 CentOS 7.2 64 位 JDK- 1.8 Hadoo p- 2.7.4 2.安装SSH sudo yum install openssh-cli ...
- MapReduce之单词计数
最近在看google那篇经典的MapReduce论文,中文版可以参考孟岩推荐的 mapreduce 中文版 中文翻译 论文中提到,MapReduce的编程模型就是: 计算利用一个输入key/value ...
- MapReduce工作机制——Word Count实例(一)
MapReduce工作机制--Word Count实例(一) MapReduce的思想是分布式计算,也就是分而治之,并行计算提高速度. 编程思想 首先,要将数据抽象为键值对的形式,map函数输入键值对 ...
- Mac下hadoop运行word count的坑
Mac下hadoop运行word count的坑 Word count体现了Map Reduce的经典思想,是分布式计算中中的hello world.然而博主很幸运地遇到了Mac下特有的问题Mkdir ...
- 大数据【四】MapReduce(单词计数;二次排序;计数器;join;分布式缓存)
前言: 根据前面的几篇博客学习,现在可以进行MapReduce学习了.本篇博客首先阐述了MapReduce的概念及使用原理,其次直接从五个实验中实践学习(单词计数,二次排序,计数器,join,分 ...
- HDFS 手写mapreduce单词计数框架
一.数据处理类 package com.css.hdfs; import java.io.BufferedReader; import java.io.IOException; import java ...
随机推荐
- mpvue打包没有app.json等配置文件的解决方法
问题 一早上折腾了1个小时,小程序始终提示查找不到'app.json'文件.mpvue重新打包,光生成内容文件无配置文件. 解决办法 出错原因:版本问题 只需要把packpage.json里的mpvu ...
- PhantomJS,隐身浏览器
PhantomJS PhantomJS是一个无界面的浏览器,实现了传统浏览器的所有功能,除了没有界面,因此,这是一个隐身浏览器. PhantomJS官网 API,特别需要注意的是Web Page Mo ...
- Win7运行net5 wpf条件
Win7运行net5 wpf条件 win7 sp1 dotnet-runtime-5 vc_redist KB2999226 KB4457144 Tips:官网条件最后一个最坑爹,KB2533623不 ...
- python---希尔排序的实现
def shell_sort(alist): """希尔排序""" n = len(alist) gap = n // 2 # 插入算法执行 ...
- cali1e4a9cee8dc这是什么东西?
//我们查下k8s node节点,发现很多类似 cali7c620a7a67b 这样的类似网络设备的东西.//这些是什么呢?//k8s集群节点ht10,node网络情况.[root@ht10 cali ...
- SpringMVC详解及SSM框架整合项目
SpringMVC ssm : mybatis + Spring + SpringMVC MVC三层架构 JavaSE:认真学习,老师带,入门快 JavaWeb:认真学习,老师带,入门快 SSM框架: ...
- RPC及Dubbo和ZooKeeper的安装
RPC及Dubbo和ZooKeeper的安装 RPC 通信有两种方式:HTTP(无状态协议,通信协议),RPC(远程过程调用) 它两的本质没有区别,只是功能有点不一样 官方解释: RPC是指远程过程调 ...
- Linux内核--链表结构(一)
一.前言 Linux内核链表结构是一种双向循环链表结构,与传统的链表结构不同,Linux内核链表结构仅包含前驱和后继指针,不包含数据域.使用链表结构,仅需在结构体成员中包含list_head*成员就行 ...
- Python Windows 快捷键自动给剪贴板(复制)图片添加水印
编写一个能在windows上使用的按下快捷键自动给剪贴板(复制)的图片添加水印的小工具.plyer.PIL.pyinstaller.pynput.win32clipboard库.记录自己踩过的坑,部分 ...
- Java学习day7
Java继承不同与c++,格式为: public class 子类名 extends 父类名{ 语句体; } 继承提高了代码的复用性与维护性 在子类方法中访问一个变量时,首先在子类局部范围查找,其次到 ...