
python下载网页转化成pdf
最近在学习一个网站补充一下cg基础。但是前几天网站突然访问不了了,同学推荐了waybackmachine这个网站,它定期的对网络上的页面进行缓存,但是好多图片刷不出来,很憋屈。于是网站恢复访问后决定把网页爬下来存成pdf。
两点收获:
1.下载网页时图片、css等文件也下载下来,并且修改html中的路径。
2. beautifulsoup、wkhtmltopdf很强大,用起来很舒心
前期准备工作:
0.安装python
1.安装pip
下载pip的安装包get-pip.py,下载地址:https://pip.pypa.io/en/latest/installing.html#id7
然后在get-pip.py所在的目录下运行get-pip.py
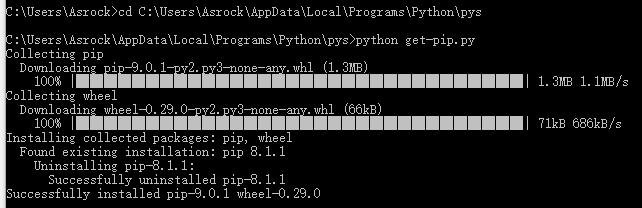
执行完成后,在python的安装目录下的Scripts子目录下,可以看到pip.exe
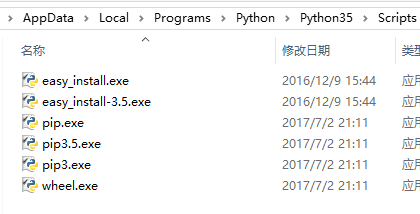
升级的话用 python -m pip install -U pip
2. 安装wkhtmltopdf : 适用于多平台的 html 到 pdf 的转换工具
3. install requests、beautifulsoup、pdfkit.
pdfkit 是 wkhtmltopdf 的Python封装包
beautifulsoup用于操纵html内容。
2.代码实现
from _ssl import PROTOCOL_TLSv1
from functools import wraps
import os
from ssl import SSLContext
import ssl
from test.test_tools import basepath
import urllib
from urllib.parse import urlparse  # py3

from bs4 import BeautifulSoup
import requests
import urllib3

def sslwrap(func):
    @wraps(func)
    def bar(*args, **kw):
        kw['ssl_version'] = ssl.PROTOCOL_TLSv1
        return func(*args, **kw)
    return bar

def save(url,cls,outputDir,outputFile):
    print("saving " + url);
    response = urllib.request.urlopen(url,timeout=500)
    soup = BeautifulSoup(response,"html5lib")
    #set css

    #save imgs

    #save html
    if(os.path.exists(outputDir+outputFile)):
        os.remove(outputDir+outputFile);
    if(cls!=""):
        body = soup.find_all(class_=cls)[0]
        with open(outputDir+outputFile,'wb') as f:
            f.write(str(body).encode(encoding='utf_8'))
    else:
        with open(outputDir+outputFile,'wb') as f:
            f.write(str(soup.find_all("html")).encode(encoding='utf_8'))
    print("finish!");
    return soup;

def crawl(base,outDir):
    ssl._create_default_https_context = ssl._create_unverified_context
    heads = save(base+"/index.php?redirect","central-column",outDir,"/head.html");
    for link in heads.find_all('a'):
        pos = str(link.get('href'))
        if(pos.startswith('/lessons')==True):
            curDir = outDir+pos;
            if(os.path.exists(curDir)==False):
                makedirs(curDir)
            else:
                print("already exist " + curDir);
                continue

            counter = 1;
            while(True):
                body = save(base+pos,"",curDir,"/"+str(counter)+".html")
                counter+=1;

                hasNext = False;
                for div in body.find_all("div",class_="footer-prev-next-cell"):
                    if(div.get("style")=="text-align: right;"):
                        hrefs = div.find_all("a");
                        if(len(hrefs)>0):
                            hasNext = True;
                            pos = hrefs[0]['href'];
                            print(">>next is at:"+pos)
                        break;
                if(hasNext==False):
                    break;

if __name__ == '__main__':
    crawl("https://www.***.com", "E:/Documents/CG/***");
    print("finish")
python下载网页转化成pdf的更多相关文章
- Python下载网页的几种方法
get和post方式总结 get方式:以URL字串本身传递数据参数,在服务器端可以从'QUERY_STRING'这个变量中直接读取,效率较高,但缺乏安全性,也无法来处理复杂的数据(只能是字符串,比如在 ...
- 下载网页中的 pdf 各种姿势,教你如何 carry 各种网页上的 pdf 文档。
关联词: PDF 下载 FLASH 网页 HTML 报告 内嵌 浏览器 文档 FlexPaperViewer swfobject. 这个需求是最近帮一个妹子处理一下各大高校网站里的 PDF 文档下载, ...
- python下载网页上公开数据集
URL很简单,数据集分散开在一个URL页面上,单个用手下载很慢,这样可以用python辅助下载: 问题:很多国外的数据集,收到网络波动的影响很大,最好可以添加一个如果失败就继续请求的逻辑,这里还没有实 ...
- python下载网页视频
因网站不同需要修改. 下载 mp4 连接 from bs4 import BeautifulSoup import requests import urllib import re import js ...
- python下载网页源码 写入文本
import urllib.request,io,os,sysreq=urllib.request.Request("http://echophp.sinaapp.com/uncategor ...
- Python下载网页图片
有时候不如不想输入路径,那就需要用os模块来修改当前路径 下面是从其他地方看到的一个例子,就是把图片url中的图片名字修改,然后就可以循环保存了,不过也是先确定了某个url 来源:http://www ...
- 使用python把html网页转成pdf文件
我们看到一些比较写的比较好文章或者博客的时候,想保存下来到本地当一个pdf文件,当做自己的知识储备,以后即使这个博客或者文章的连接不存在了,或者被删掉,咱们自己也还有. 当然咱们作为一个coder,这 ...
- Python入门小练习 002 批量下载网页链接中的图片
我们常常需要下载网页上很多喜欢的图片,但是面对几十甚至上百张的图片,一个一个去另存为肯定是个很差的体验. 我们可以用urllib包获取html的源码,再以正则表达式把匹配的图片链接放入一个list中, ...
- Python + Selenium +Chrome 批量下载网页代码修改【新手必学】
Python + Selenium +Chrome 批量下载网页代码修改主要修改以下代码可以调用 本地的 user-agent.txt 和 cookie.txt来达到在登陆状态下 批量打开并下载网页, ...
随机推荐
- windows phone LongListSelector加载下一页
LongListSelector利用ListHeader.ListFooter加载上一页和下一页XAML代码: <phone:LongListSelector> <phone:Lon ...
- POJ 3624 Charm Bracelet【01背包】
解题思路:直接套公式就能做的01背包, for(i=1;i<=n;i++) { for(v=w[i];v<=m;v++) f[i,v]=max(f[i,v],f[i-1,v-w[i]]+d ...
- 【AnjularJS系列6 】 过滤器
第六篇,过滤器 AngularJS 过滤器可用于转换数据: 过滤器 描述 currency 格式化数字为货币格式. filter 从数组项中选择一个子集. lowercase 格式化字符串为小写. o ...
- -ms-,-moz-,-webkit-,-o-含义及各浏览器内核整理
transform:rotate(30deg); //统一标识语句 -ms-transform:rotate(30deg); //-ms代表ie内核识别码 ...
- js类的使用
brush示例 以d3的一个brush进行叙述,示例见: https://bl.ocks.org/xunhanliu/6f0b46789842e9e19e6cfe9bd0b16806 应用情形: 当页 ...
- DOM元素属性值如果设置为对象
结论:内部会调用toString方法,将设置的对象转换为字符串添加给相应的属性: 这个问题呢,是通过jQuery的each方法中,回调函数的this指向问题而来: 我们知道,回调函数中的this如果指 ...
- GRUB 引导流程
GRUB(bootloader)引导流程: GRUB,GRand Unified Bootlader ,是一个来自GUN项目的多操作系统启动程序.GRUB是多启动规范的实现,它允许用户可以在计算机内 ...
- js实现点击复制网页内容(基于clipboard.js)
浏览网页过程中会遇到点击复制链接地址的情况,下面就介绍一种实现方法,该方法是基于clipboard.js: 官网地址:https://clipboardjs.com/: clipboard.js使用比 ...
- ASP.NET-HTML.Helper常用方法
Html.ActionLink方法 Html.ActionLink("linkText","actionName") Html.ActionLink(" ...
- Jquery-select元素操作方法
jQuery获取Select元素,并选择的Text和Value: $("#select_id").change(function(){//code...}); //为Select添 ...