
入门大数据---通过Yarn搭建MapReduce和应用实例
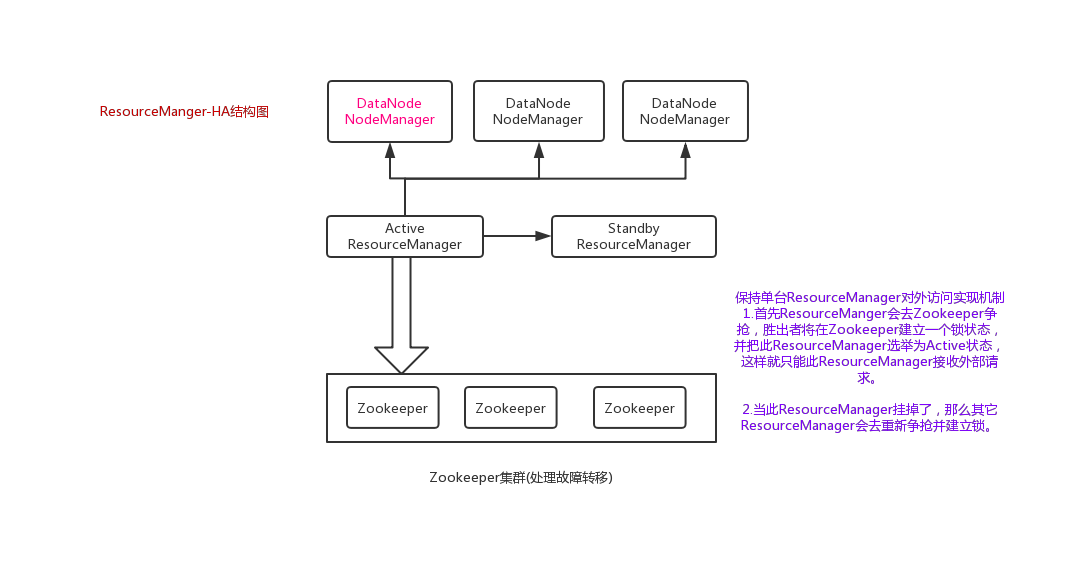
上一篇中我们了解了MapReduce和Yarn的基本概念,接下来带领大家搭建下Mapreduce-HA的框架。
结构图如下:
开始搭建:
一.配置环境
注:可以现在一台计算机上进行配置,然后分发给其它服务器
1.1 编辑mapred-site.xml文件:
进入目录 /opt/hadoop/hadoop-2.6.5/etc/hadoop
cd /opt/hadoop/hadoop-2.6.5/etc/hadoop
vim mapred-site.xml
添加如下配置:
<configuration>

    <property>

        <name>mapreduce.framework.name</name>

        <value>yarn</value> <!--指定mapreduce通过yarn获取数据,还可以填写参数localhost-->

    </property>

    <property>

        <name>mapreduce.application.classpath</name>

        <value>$HADOOP_MAPRED_HOME/share/hadoop/mapreduce/*:$HADOOP_MAPRED_HOME/share/hadoop/mapreduce/lib/*</value>

    </property>

</configuration>
1.2 编辑yarn-site.xml文件:
vim yarn-site.xml
添加如下配置:
<configuratoin>

  <property>

    <name>yarn.nodemanager.aux-services</name>

    <value>mapreduce_shuffle</value> <!--指定nodemanager可以拉取数据-->

  </property>

  <property>

    <name>yarn.resourcemanager.ha.enabled</name>

    <value>true</value><!--启动resourcemanager高可用-->

  </property>

  <property>

    <name>hadoop.zk.address</name><!--配置zookeeper地址-->

    <value>tuge1:2181,tuge2:2181,tuge3:2181,tuge4:2181</value>

  </property>

  <property>

    <name>yarn.resourcemanager.cluster-id</name>

    <value>cluster1</value><!--配置resourcemanager虚拟地址到物理地址的映射-->

  </property>

  <property>

    <name>yarn.resourcemanager.ha.rm-ids</name>

    <value>rm1,rm2</value>

  </property>

  <property>

    <name>yarn.resourcemanager.hostname.rm1</name>

    <value>tuge1</value>

  </property>

  <property>

    <name>yarn.resourcemanager.hostname.rm2</name>

    <value>tuge2</value>

  </property>

  <property>

    <name>yarn.resourcemanager.webapp.address.rm1</name>

    <value>tuge1:8088</value>

  </property>

  <property>

    <name>yarn.resourcemanager.webapp.address.rm2</name>

    <value>tuge2:8088</value>

  </property>
</configuration>
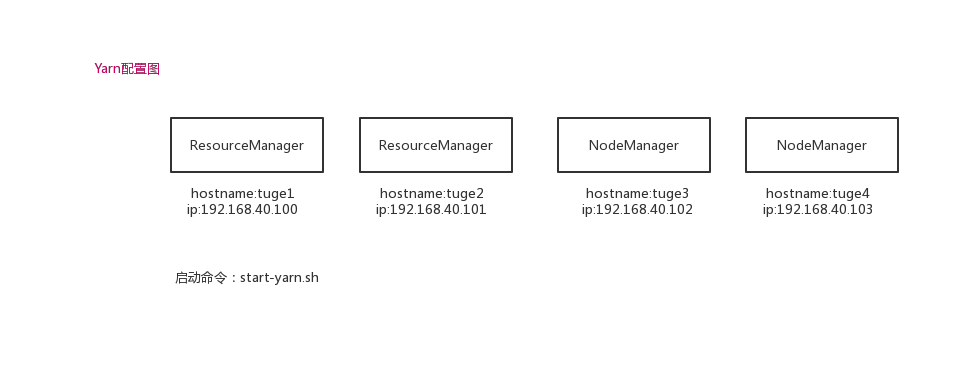
二.启动程序
在tuge1服务器启动:
cd /opt/hadoop/hadoop-2.6.5/sbin
start-yarn.sh
启动后,使用jps即可查看resourcemanager和nodemanager是否启动成功。
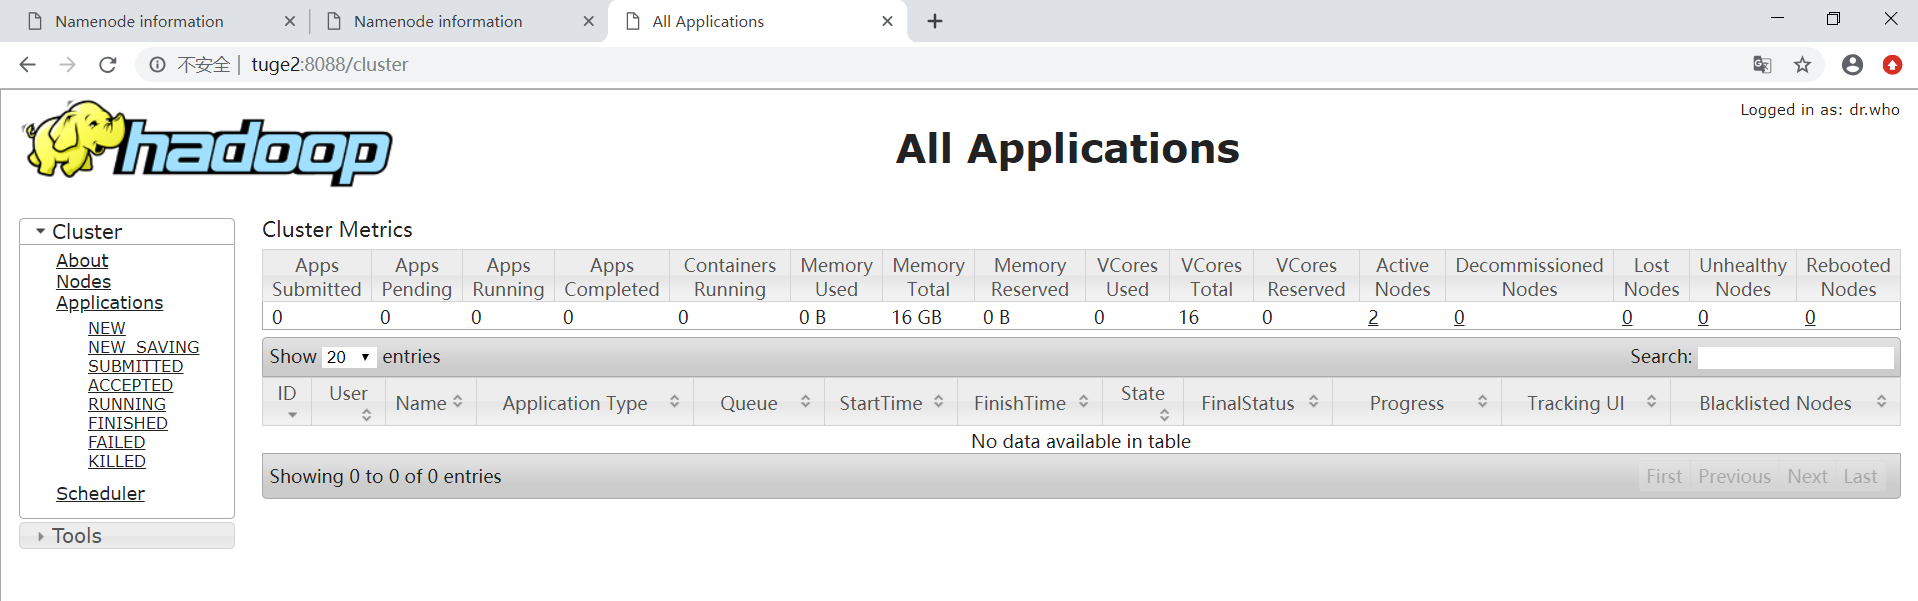
三.浏览效果
四.实现一个计算Demo
4.1 在hdfs里面创建一个10000行的test.txt文件
使用命令:
//首先创建一个root文件夹
hadoop fs -mkdir /user/root/
//在linux随便找一个目录创建一个文件,并加入1万行What are you doing 123?
touch test.txt
vim test.txt
然后输入数字10000,再点击i进行输入What are you doing 123? ,然后按Esc 这时10000行What are you doing 123?就录入了,然后保存。
//将本地文件复制到hdfs上面
hadoop dfs -scpFromLocal test.txt /user/root/
4.2 进入/opt/hadoop/hadoop-2.6.5/share/hadoop/mapreduce
cd /opt/hadoop/hadoop-2.6.5/share/hadoop/mapreduce
4.3 使用mapreduce统计刚刚上传文件里面的单词数量
hadoop jar hadoop-mapreduce-examples-2.6.5.jar /user/root/test.txt /user/root/result --意思是使用hadoop 运行jar环境,并执行程序,统计的文件路径,输出结果路径(这个路径必须是空的或者不存在的)
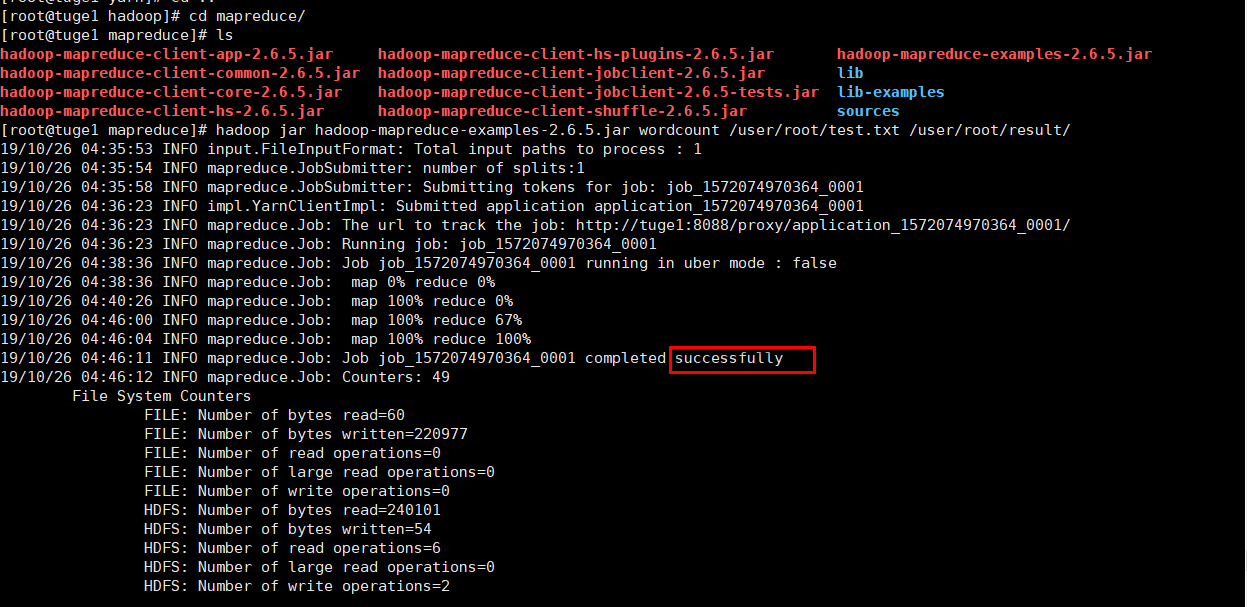
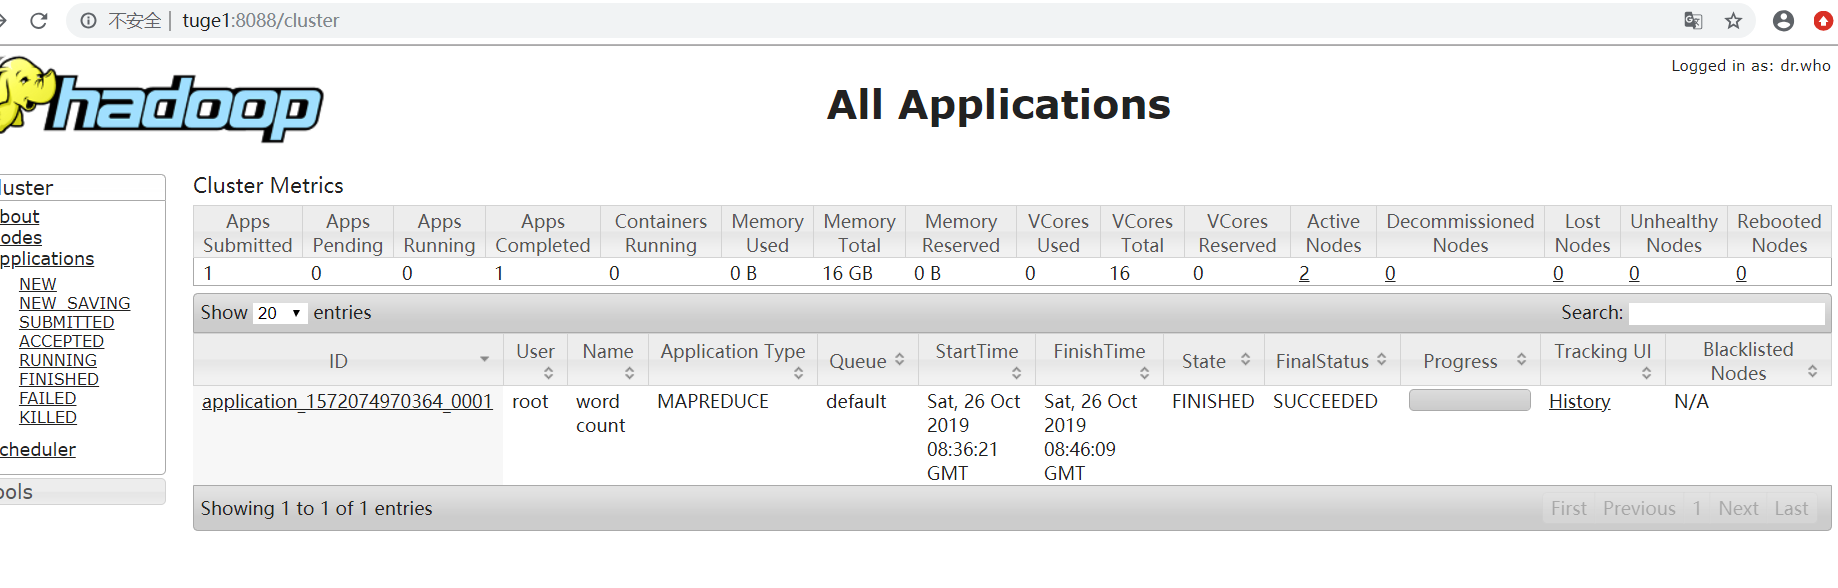
4.4 控制台执行效果图和web ui浏览效果图
4.5 最后我们可以在上面的输出目录查看统计结果
hadoop fs -cat /user/root/result/part-r-00000
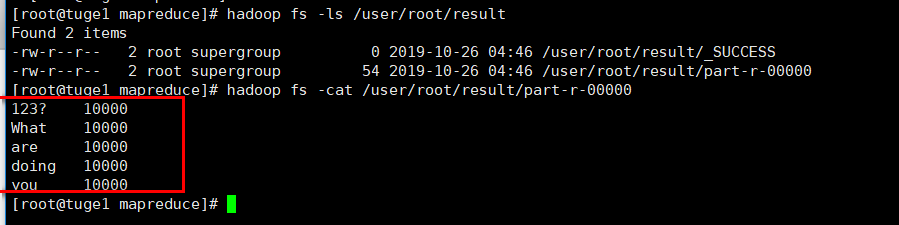
从上图可以看到,每个单词统计均为10000,那么就证明我们搭建成功啦~
入门大数据---通过Yarn搭建MapReduce和应用实例的更多相关文章
- 入门大数据---Hive的搭建
本博客主要介绍Hive和MySql的搭建: 学习视频一天就讲完了,我看完了自己搭建MySql遇到了一堆坑,然后花了快两天才解决完,终于把MySql搭建好了.然后又去搭建Hive,又遇到了很多坑,就这 ...
- 入门大数据---Kafka的搭建与应用
前言 上一章介绍了Kafka是什么,这章就讲讲怎么搭建以及如何使用. 快速开始 Step 1:Download the code Download the 2.4.1 release and un-t ...
- 入门大数据---基于Zookeeper搭建Kafka高可用集群
一.Zookeeper集群搭建 为保证集群高可用,Zookeeper 集群的节点数最好是奇数,最少有三个节点,所以这里搭建一个三个节点的集群. 1.1 下载 & 解压 下载对应版本 Zooke ...
- 入门大数据---基于Zookeeper搭建Spark高可用集群
一.集群规划 这里搭建一个 3 节点的 Spark 集群,其中三台主机上均部署 Worker 服务.同时为了保证高可用,除了在 hadoop001 上部署主 Master 服务外,还在 hadoop0 ...
- 入门大数据---Flume的搭建
一.下载并解压到指定目录 崇尚授人以渔的思想,我说给大家怎么下载就行了,就不直接放连接了,大家可以直接输入官网地址 http://flume.apache.org ,一般在官网的上方或者左边都会有Do ...
- Ambari——大数据平台的搭建利器之进阶篇
前言 本文适合已经初步了解 Ambari 的读者.对 Ambari 的基础知识,以及 Ambari 的安装步骤还不清楚的读者,可以先阅读基础篇文章<Ambari——大数据平台的搭建利器>. ...
- 我眼中的大数据(三)——MapReduce
这次来聊聊Hadoop中使用广泛的分布式计算方案--MapReduce.MapReduce是一种编程模型,还是一个分布式计算框架. MapReduce作为一种编程模型功能强大,使用简单.运算内容不 ...
- 大数据应用日志采集之Scribe演示实例完全解析
大数据应用日志采集之Scribe演示实例完全解析 引子: Scribe是Facebook开源的日志收集系统,在Facebook内部已经得到大量的应用.它能够从各种日志源上收集日志,存储到一个中央存储系 ...
- 入门大数据---Flink学习总括
第一节 初识 Flink 在数据激增的时代,催生出了一批计算框架.最早期比较流行的有MapReduce,然后有Spark,直到现在越来越多的公司采用Flink处理.Flink相对前两个框架真正做到了高 ...
随机推荐
- CentOS安装Python3.5
1. 安装python3.5可能使用的依赖 yum install openssl-devel bzip2-devel expat-devel gdbm-devel readline-devel s ...
- zabbix通过IPMI监控服务器传感器参数
一.需求:机房dell服务器和IBM服务器皆有主板管理接口iDRAC和iMM,上周已为服务器管理接口配置了ip地址,考虑通过zabbix实现对服务器传感器参数的实时监控.使用DELL-DL1300服务 ...
- CICD | Jenkins & Gitlab集成:WebHook触发构建
在上一篇博客中,我们学习了Jenkins的搭建和插件+流水线的基本使用方法,Jenkins极大地提升了部署效率. 最近想学习一下如何集成GitLab webhook,实现进一步解放双手,目标: 推送( ...
- 深入理解Java的动态编译
前提 笔者很久之前就有个想法:参考现有的主流ORM框架的设计,造一个ORM轮子,在基本不改变使用体验的前提下把框架依赖的大量的反射设计去掉,这些反射API构筑的组件使用动态编译加载的实例去替代,从而可 ...
- ELK扫盲及搭建
1. ELK部署说明 1.1ELK介绍: 1.1.1 ELK是什么? ELK是三个开源软件的缩写,分别表示:ElasticSearch , Logstash, Kibana , 它们都是开源软件,EL ...
- C#9.0 终于来了,带你一起解读Pattern matching 和 nint 两大新特性玩法
一:背景 1. 讲故事 上一篇跟大家聊到了Target-typed new 和 Lambda discard parameters,看博客园和公号里的阅读量都达到了新高,甚是欣慰,不管大家对新特性是多 ...
- [AHOI2017/HNOI2017]单旋
题目 点这里看题目. 分析 最妙的地方在于,这道题其实是用一种数据结构模拟另一种数据结构! 我们需要维护深度和树的结构,以下对于每个操作进行分别讨论. 插入一个新节点 可以发现,这个新 ...
- (八)跑完用例后通过maven发送邮件
邮件类: package config; import com.sun.mail.util.MailSSLSocketFactory; import org.apache.log4j.Logger; ...
- 其他函数-web_concurrent
web_concurrent_start函数是并发组开始的标记.组中所有的函数是并发执行的,并发组的结束符为web_concurrent_end 函数. 在并发组中,可以包含的函数有: web_url ...
- INSERT INTO语句的基本用法
原文链接:https://www.cnblogs.com/mingmingming/p/11295200.html 一.INSERT INTO语句的基本用法 INSERT INTO 语句用于往表中插入 ...