
入门大数据---Hive的搭建
本博客主要介绍Hive和MySql的搭建:
学习视频一天就讲完了,我看完了自己搭建MySql遇到了一堆坑,然后花了快两天才解决完,终于把MySql搭建好了。然后又去搭建Hive,又遇到了很多坑,就这样一直解决问题,加上网上搜索和个人排查检查日志。搜索百度,百度不行搜索Bing,看了csdn,看strackflow,最后终于功夫不负有心人,成功把MySql和Hive跑起来了。这里我将还原最初状态,并把遇到的坑一并记录下,同时防止后人采坑。
搭建环境:
Centos7,MySql14.14,Hive2.3.6
搭建MySql:
搭建步骤我参考的菜鸟教程: https://www.runoob.com/mysql/mysql-install.html
参考上述步骤搭建遇到的坑:
坑1:安装完后,给root用户设置密码后,使用账户和密码登陆报了ERROR 1045 (28000): Access denied for user 'root'@'localhost' (using password: YES)错误,解决方案点击。
搭建Hive:
搭建步骤我参考的: https://www.cnblogs.com/dxxblog/p/8193967.html
参考上述步骤遇到的坑:启动hive抛出Relative path in absolute URI: ${system:java.io.tmpdir%7D/$%7Bsystem:user.name%7D异常,解决方案点击。
操作Hive:
先说下环境的坑:
坑1:当我在Hive中执行查询操作没问题,但是当删除表结构的时候会抛出如下异常 :
执行drop table tableName;
Execution Error, return code 1 from org.apache.hadoop.hive.ql.exec.DDLTask. MetaException(message:For direct MetaStore DB connections, we don't support retries at the client level.)
这句话的意思是不支持此操作,并不是SQL写错了。 这个问题的原因是之前我们在hive的lib中添加的mysql-connection-java.jar(使用JDBC操作MySql的包)版本不对,我之前用的mysql-connection-java-5.1.18.jar,后来改为了mysql-connection-java-5.1.47.jar就好了。
如果您的也不对,请及时替换,包连接
案例1(在Hive中创建内部表):
在Linux系统找个位置创建visits.txt和visits.hive文件:
在visits.txt文件里面加入如下内容,中间是以\t 分割的
一明  北京市朝阳区

毒逆天  江苏省苏州市

海面贝贝  上海市闵行区
在visits.hive加入创建数据库命令
create table people_visits

(

user_name string,

phone string,

address string

)

row format delimited

fields terminated by '\t';
在hive里面创建people_visits表
hive -f visits.hive
然后在hive中使用show tables; 就能看到这个表了。 但是数据是空的。接下来使用命令将visits.txt文件数据提交到hdfs再查询就能看到数据了。
hadoop fs -put visits.txt /user/hive/warehouse/people_visits
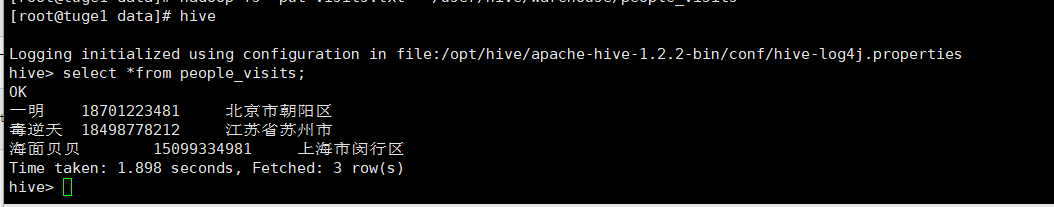
使用web浏览也可以看到上传的文件:

案例2:(在hive中创建外部表)
在Linux本地找个文件夹创建externalHive.txt文件
cd /data/
touch externalHive.txt
编辑文件加入以下内容
vim externalHive.txt
西红柿

桃子
注意:(上面字符使用tab键分割)
在hdfs里面新建一个hivetest文件夹
hadoop fs -mkdir /user/root/hivetest
将文件上传到hdfs
hadoop fs -put externalHive.txt /user
进入Hive创建一个价格外部表
hive
create external table priceVisits

(

name string,

price int

)

row format delimited

fields terminated by '\t'

location '/user/root/hivetest';   --指定表所在路径
将数据上传到priceVisits表里面
hive
load data inpath '/user/externalHive.txt' into table priceVisits;
PS:(上面的命令执行完后,user目录下的externalHive.txt就会移动到创建table时指定的目录下面)
查询priceVisits表就可以看到数据了
select *from priceVisits;
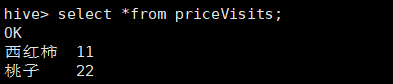
删除priceVisits表:
drop table priceVisits;
可以看到表删除了,但是数据还没删除,这就是外部表的作用
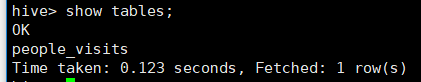

上面的查询并没有用到MapReduce计算,仅仅使用了简单的本地查询,这是因为我们没有写聚合语句,不需要MapReduce。
DDL操作语句参考: https://www.cnblogs.com/shun7man/p/13172313.html
分桶操作参考:https://www.cnblogs.com/shun7man/p/13172437.html
入门大数据---Hive的搭建的更多相关文章
- 入门大数据---Hive计算引擎Tez简介和使用
一.前言 Hive默认计算引擎时MR,为了提高计算速度,我们可以改为Tez引擎.至于为什么提高了计算速度,可以参考下图: 用Hive直接编写MR程序,假设有四个有依赖关系的MR作业,上图中,绿色是Re ...
- 入门大数据---Hive是什么?
这篇文章主要介绍Hive的概念. 简介: Hive中文名叫数据仓库管理系统,之前我们操作MapReduce必须通过编写代码或者通过特殊命令来实现,有了Hive我们通过常用的SQL语句就能操作MapRe ...
- 入门大数据---Hive数据查询详解
一.数据准备 为了演示查询操作,这里需要预先创建三张表,并加载测试数据. 数据文件 emp.txt 和 dept.txt 可以从本仓库的resources 目录下载. 1.1 员工表 -- 建表语句 ...
- 入门大数据---Kafka的搭建与应用
前言 上一章介绍了Kafka是什么,这章就讲讲怎么搭建以及如何使用. 快速开始 Step 1:Download the code Download the 2.4.1 release and un-t ...
- 入门大数据---通过Yarn搭建MapReduce和应用实例
上一篇中我们了解了MapReduce和Yarn的基本概念,接下来带领大家搭建下Mapreduce-HA的框架. 结构图如下: 开始搭建: 一.配置环境 注:可以现在一台计算机上进行配置,然后分发给其它 ...
- 入门大数据---Hive常用DDL操作
一.Database 1.1 查看数据列表 show databases; 1.2 使用数据库 USE database_name; 1.3 新建数据库 语法: CREATE (DATABASE|SC ...
- 入门大数据---Hive分区表和分桶表
一.分区表 1.1 概念 Hive 中的表对应为 HDFS 上的指定目录,在查询数据时候,默认会对全表进行扫描,这样时间和性能的消耗都非常大. 分区为 HDFS 上表目录的子目录,数据按照分区存储在子 ...
- 入门大数据---Hive视图和索引
一.视图 1.1 简介 Hive 中的视图和 RDBMS 中视图的概念一致,都是一组数据的逻辑表示,本质上就是一条 SELECT 语句的结果集.视图是纯粹的逻辑对象,没有关联的存储 (Hive 3.0 ...
- 入门大数据---基于Zookeeper搭建Kafka高可用集群
一.Zookeeper集群搭建 为保证集群高可用,Zookeeper 集群的节点数最好是奇数,最少有三个节点,所以这里搭建一个三个节点的集群. 1.1 下载 & 解压 下载对应版本 Zooke ...
随机推荐
- 小谢第7问:js前端如何实现大文件分片上传、上传进度、终止上传以及删除服务器文件?
文件上传一般有两种方式:文件流上传和base64方式上传,毫无疑问,当进行大文件上传时候,转为base64是不现实的,因此用formData方式结合文件流,直接上传到服务器 本文主要结合vue的来讲解 ...
- 企业级Python开发大佬利用网络爬虫技术实现自动发送天气预告邮件
前天小编带大家利用Python网络爬虫采集了天气网的实时信息,今天小编带大家更进一步,将采集到的天气信息直接发送到邮箱,带大家一起嗨~~拓展来说,这个功能放在企业级角度来看,只要我们拥有客户的邮箱,之 ...
- Java实现 蓝桥杯 算法提高 特等奖学金(暴力)
试题 算法提高 特等奖学金 问题描述 土豪大学每年都会给学生颁发巨额的特等奖学金,当然,获奖的前提是要足够优秀.这所大学有n名学生,他们中的每个人都会在m门必修课的每门课上获得一个百分制的整数成绩(0 ...
- (Java实现) 洛谷 P1106 删数问题
题目描述 键盘输入一个高精度的正整数NN(不超过250250位) ,去掉其中任意kk个数字后剩下的数字按原左右次序将组成一个新的正整数.编程对给定的NN和kk,寻找一种方案使得剩下的数字组成的新数最小 ...
- Java实现 LeetCode 283 移动零
283. 移动零 给定一个数组 nums,编写一个函数将所有 0 移动到数组的末尾,同时保持非零元素的相对顺序. 示例: 输入: [0,1,0,3,12] 输出: [1,3,12,0,0] 说明: 必 ...
- Java实现 LeetCode 87 扰乱字符串
87. 扰乱字符串 给定一个字符串 s1,我们可以把它递归地分割成两个非空子字符串,从而将其表示为二叉树. 下图是字符串 s1 = "great" 的一种可能的表示形式. grea ...
- mac下使用VMVARE安装win10虚拟机的一些坑
最近Mac上安装windows踩到了几个坑: 坑一:启动虚拟机后,提示找不到CD-ROM中找不到对应的ISO文件 硬盘格式请选择 在虚拟机->设置中选择启动磁盘为CD_ROM,然后重新启动. 坑 ...
- apollo与springboot集成实现动态刷新配置
分布式apollo简介 Apollo(阿波罗)是携程框架部门研发的开源配置管理中心,能够集中化管理应用不同环境.不同集群的配置,配置修改后能够实时推送到应用端,并且具备规范的权限.流程治理等特性. 本 ...
- tensorflow2.0学习笔记第二章第二节
2.2复杂度和学习率 指数衰减学习率可以先用较大的学习率,快速得到较优解,然后逐步减少学习率,使得模型在训练后期稳定指数衰减学习率 = 初始学习率 * 学习率衰减率^(当前轮数/多少轮衰减一次) 空间 ...
- .NET开发者省份分布排名
什么叫.NET开发者省份分布排名呢? 顾名思义,这几个词大家都认识,.NET开发者都集中在城市,涵盖一线城市到五线城市.排名的方法非常简单粗暴,就是根据本公众号(dotnet跨平台)的省份订阅读者数量 ...