
scrapy框架爬取国际庄2011-2022的天气情况
目标网站:http://www.tianqihoubao.com/lishi/
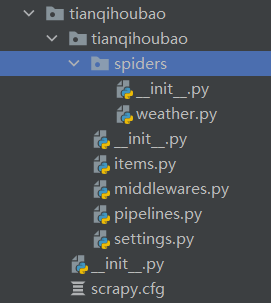
一.创建项目+初始化爬虫文件:
scrapy startpoject tianqihoubao
cd tianqihoubao
scrapy genspider weather www.tianqihoubao.com
二.配置settings.py
USER_AGENT = 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/99.0.4844.51 Safari/537.36 Edg/99.0.1150.30'

ROBOTSTXT_OBEY = False #君子协议 注释掉或者改为false

ITEM_PIPELINES = {

   'tianqihoubao.pipelines.TianqihoubaoPipeline': 300,

   'tianqihoubao.pipelines.MySQLStoreCnblogsPipeline': 300

}

# 连接数据MySQL

# 数据库地址

MYSQL_HOST = 'localhost'

# 数据库用户名:

MYSQL_USER = 'root'

# 数据库密码

MYSQL_PASSWORD = '123456'

# 数据库端口

MYSQL_PORT = 3306

# 数据库名称

MYSQL_DBNAME = 'data'

# 数据库编码

MYSQL_CHARSET = 'utf8'
三.修改items.py
import scrapy

class TianqihoubaoItem(scrapy.Item):

    # define the fields for your item here like:

    # name = scrapy.Field()

    riqi = scrapy.Field()

    tianqi = scrapy.Field()

    qiwen = scrapy.Field()

    wind = scrapy.Field()
四.编写weather.py
scrapy.Request()教程:Scrapy爬虫入门教程十一 Request和Response(请求和响应)
import scrapy

from tianqihoubao.items import TianqihoubaoItem

class WeatherSpider(scrapy.Spider):

    name = 'weather'

    allowed_domains = ['www.tianqihoubao.com']

    start_urls = ['http://www.tianqihoubao.com/lishi/shijiazhuang.html']

    def parse(self, response):

        #for path in self.start_urls:

        data = response.xpath('//div[@id="content"]/table[@class="b"]/tr')

        next_page = response.xpath('//div[@id="content"]/div[@class="box pcity"]/ul/li/a/@href').extract()

        for i in data[1:]:

            item = TianqihoubaoItem()

            item['riqi'] = i.xpath('./td/a/text()').extract()[0].replace('\r\n', '').replace('\n', '').replace(' ', '').strip()

            item['tianqi'] = i.xpath('./td/text()').extract()[2].replace('\r\n', '').replace('\n', '').replace(' ', '').strip()

            item['qiwen'] = i.xpath('./td/text()').extract()[3].replace('\r\n', '').replace('\n', '').replace(' ', '').strip()

            item['wind'] = i.xpath('./td/text()').extract()[4].replace('\r\n', '').replace('\n', '').replace(' ', '').strip()

            #print(item['tianqi'])

            yield item

        print("下一页", next_page)

        if next_page and len(next_page) > 5:

            # 翻页

            for i in next_page:

                yield scrapy.Request(url='http://www.tianqihoubao.com'+i, callback=self.parse)

        else:

            print("没有下一页了" * 10)

        print(data)
五.配置pipelines.py(一个保存为csv,一个保存到mysql上)
import copy

import csv

import time

from pymysql import cursors

from twisted.enterprise import adbapi

class TianqihoubaoPipeline(object):

    # 保存为csv格式

    def __init__(self):

        # 打开文件,指定方式为写,利用第3个参数把csv写数据时产生的空行消除

        self.f = open("weather.csv", "a", newline="", encoding="utf-8")

        # 设置文件第一行的字段名,注意要跟spider传过来的字典key名称相同

        self.fieldnames = ["riqi", "tianqi", "qiwen", "wind"]

        # 指定文件的写入方式为csv字典写入,参数1为指定具体文件,参数2为指定字段名

        self.writer = csv.DictWriter(self.f, fieldnames=self.fieldnames)

        # 写入第一行字段名,因为只要写入一次,所以文件放在__init__里面

        self.writer.writeheader()

    def process_item(self, item, spider):

        # 写入spider传过来的具体数值

        self.writer.writerow(item)

        # 写入完返回

        return item

    def close(self, spider):

        self.f.close()

class MySQLStoreCnblogsPipeline(object):

    # 初始化函数

    def __init__(self, db_pool):

        self.db_pool = db_pool

    # 从settings配置文件中读取参数

    @classmethod

    def from_settings(cls, settings):

        # 用一个db_params接收连接数据库的参数

        db_params = dict(

            host=settings['MYSQL_HOST'],

            user=settings['MYSQL_USER'],

            password=settings['MYSQL_PASSWORD'],

            port=settings['MYSQL_PORT'],

            database=settings['MYSQL_DBNAME'],

            charset=settings['MYSQL_CHARSET'],

            use_unicode=True,

            # 设置游标类型

            cursorclass=cursors.DictCursor

        )

        # 创建连接池

        db_pool = adbapi.ConnectionPool('pymysql', **db_params)

        # 返回一个pipeline对象

        return cls(db_pool)

    # 处理item函数

    def process_item(self, item, spider):

        # 对象拷贝,深拷贝  --- 这里是解决数据重复问题!!!

        asynItem = copy.deepcopy(item)

        # 把要执行的sql放入连接池

        query = self.db_pool.runInteraction(self.insert_into, asynItem)

        # 如果sql执行发送错误,自动回调addErrBack()函数

        query.addErrback(self.handle_error, item, spider)

        # 返回Item

        return item

    # 处理sql函数

    def insert_into(self, cursor, item):

        # 创建sql语句

        sql = "INSERT INTO weather (riqi,tianqi,qiwen,wind) VALUES ('{}','{}','{}','{}')".format(

            item['riqi'], item['tianqi'], item['qiwen'], item['wind'])

        # 执行sql语句

        cursor.execute(sql)

        # 错误函数

    def handle_error(self, failure, item, spider):

        # #输出错误信息

        print("failure", failure)
六.结果
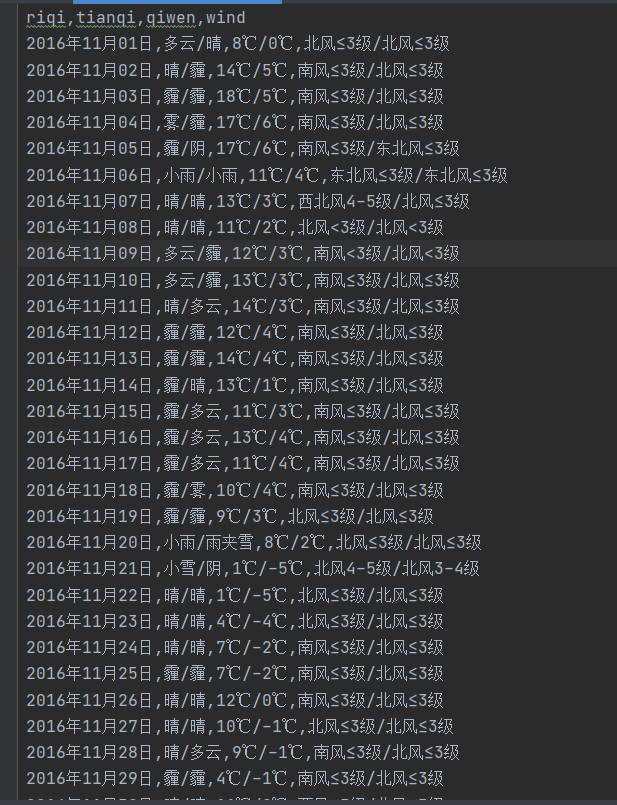

这个在爬取的时候没有按时间顺序来,后续在搞一搞
scrapy框架爬取国际庄2011-2022的天气情况的更多相关文章
- 使用scrapy框架爬取自己的博文(2)
之前写了一篇用scrapy框架爬取自己博文的博客,后来发现对于中文的处理一直有问题- - 显示的时候 [u'python\u4e0b\u722c\u67d0\u4e2a\u7f51\u9875\u76 ...
- scrapy框架爬取笔趣阁完整版
继续上一篇,这一次的爬取了小说内容 pipelines.py import csv class ScrapytestPipeline(object): # 爬虫文件中提取数据的方法每yield一次it ...
- scrapy框架爬取笔趣阁
笔趣阁是很好爬的网站了,这里简单爬取了全部小说链接和每本的全部章节链接,还想爬取章节内容在biquge.py里在加一个爬取循环,在pipelines.py添加保存函数即可 1 创建一个scrapy项目 ...
- Python使用Scrapy框架爬取数据存入CSV文件(Python爬虫实战4)
1. Scrapy框架 Scrapy是python下实现爬虫功能的框架,能够将数据解析.数据处理.数据存储合为一体功能的爬虫框架. 2. Scrapy安装 1. 安装依赖包 yum install g ...
- 爬虫入门(四)——Scrapy框架入门:使用Scrapy框架爬取全书网小说数据
为了入门scrapy框架,昨天写了一个爬取静态小说网站的小程序 下面我们尝试爬取全书网中网游动漫类小说的书籍信息. 一.准备阶段 明确一下爬虫页面分析的思路: 对于书籍列表页:我们需要知道打开单本书籍 ...
- 使用scrapy框架爬取自己的博文(3)
既然如此,何不再抓一抓网页的文字内容呢? 谷歌浏览器有个审查元素的功能,就是按树的结构查看html的组织形式,如图: 这样已经比较明显了,博客的正文内容主要在div 的class = cnblogs_ ...
- 使用scrapy框架爬取自己的博文
scrapy框架是个比较简单易用基于python的爬虫框架,http://scrapy-chs.readthedocs.org/zh_CN/latest/ 这个是不错的中文文档 几个比较重要的部分: ...
- 基于python的scrapy框架爬取豆瓣电影及其可视化
1.Scrapy框架介绍 主要介绍,spiders,engine,scheduler,downloader,Item pipeline scrapy常见命令如下: 对应在scrapy文件中有,自己增加 ...
- scrapy框架爬取豆瓣读书(1)
1.scrapy框架 Scrapy,Python开发的一个快速.高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据.Scrapy用途广泛,可以用于数据挖掘.监测和自动化测试 ...
随机推荐
- [k8s] k8s基于csi使用rbd存储
描述 ceph-csi扩展各种存储类型的卷的管理能力,实现第三方存储ceph的各种操作能力与k8s存储系统的结合.通过 ceph-csi 使用 ceph rbd块设备,它动态地提供rbd以支持 Kub ...
- 5分钟学会 gRPC
介绍 我猜测大部分长期使用 Java 的开发者应该较少会接触 gRPC,毕竟在 Java 圈子里大部分使用的还是 Dubbo/SpringClound 这两类服务框架. 我也是近段时间有机会从零开始重 ...
- MySQL-DB-封装-升级版
<?php class DB { //定义属性 private $host;//主机名 private $port;//端口号 private $name;//用户名 private $pass ...
- 如何在 MWeb 中配置 Hexo 等静态网站
原文链接 参考链接: https://zh.mweb.im/mweb-1.4-add-floder-octpress-support.html https://zhuanlan.zhihu.com/p ...
- MATLAB探索初步问题汇总
MATLAB命令窗口如果显示:尝试将SCRIPT normrnd作为函数执行:C:\User-- 出错sort 这类问题,一般是你的*.m文件的名与内置函数名重名,改一下文件名即可. 2.MATLAB ...
- 【机器学习基础】无监督学习(2)——降维之LLE和TSNE
在上一节介绍了一种最常见的降维方法PCA,本节介绍另一种降维方法LLE,本来打算对于其他降维算法一并进行一个简介,不过既然看到这里了,就对这些算法做一个相对详细的学习吧. 0.流形学习简介 在前面PC ...
- Spring——自动装配的三种实现方式
依赖注入的本质是装配,装配是依赖注入的具体行为 spring会在上下文中自动寻找,并自动给bean装配属性 自动装配的三种方式 (1).在xml中显式的装配 (2).在java中显式的装配 (3).隐 ...
- json.dumps参数之解
宝藏参数,懂的都懂^-^ 说明:编译后print()打印内容,此内容以字符串紧凑输出,且无顺序,中文不可读.. 应用:使用pycharm做接口测试时,print()打印出的接口下行,如下图: ...
- MYSQL5.7详细安装步骤
0.更换yum源 1.打开 mirrors.aliyun.com,选择centos的系统,点击帮助 2.执行命令:yum install wget -y 3.改变某些文件的名称 mv /etc/yum ...
- Rocket Mq 常用API 及简单运维
RocketMQ 常用API 消息 消息消费模式 消息消费模式由消费者来决定,可以由消费者设置MessageModel来决定消息模式. 消息模式默认为集群消费模式 consumer.setMessag ...