
基于python的scrapy框架爬取豆瓣电影及其可视化
1.Scrapy框架介绍
主要介绍,spiders,engine,scheduler,downloader,Item pipeline
scrapy常见命令如下:
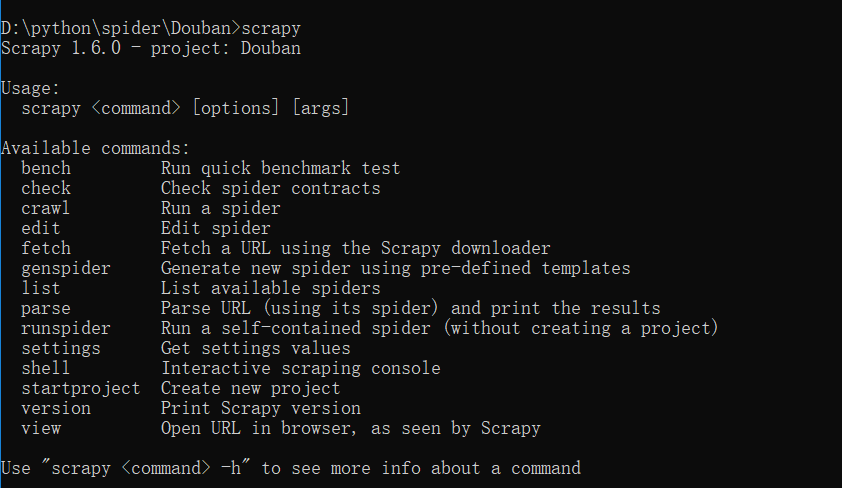
对应在scrapy文件中有,自己增加爬虫文件,系统生成items,pipelines,setting的配置文件就这些。
items写需要爬取的属性名,pipelines写一些数据流操作,写入文件,还是导入数据库中。主要爬虫文件写domain,属性名的xpath,在每页添加属性对应的信息等。
    movieRank = scrapy.Field()

    movieName = scrapy.Field()

    Director = scrapy.Field()

    movieDesc = scrapy.Field()

    movieRate = scrapy.Field()

    peopleCount = scrapy.Field()

    movieDate = scrapy.Field()

    movieCountry = scrapy.Field()

    movieCategory = scrapy.Field()

    moviePost = scrapy.Field()
import json

class DoubanPipeline(object):

    def __init__(self):

        self.f = open("douban.json","w",encoding='utf-8')

    def process_item(self, item, spider):

        content = json.dumps(dict(item),ensure_ascii = False)+"\n"

        self.f.write(content)

        return item

    def close_spider(self,spider):

        self.f.close()
这里xpath使用过程中,安利一个chrome插件xpathHelper。
    allowed_domains = ['douban.com']

    baseURL = "https://movie.douban.com/top250?start="

    offset = 0

    start_urls = [baseURL + str(offset)]

    def parse(self, response):

        node_list = response.xpath("//div[@class='item']")

        for node in node_list:

            item = DoubanItem()

            item['movieName'] = node.xpath("./div[@class='info']/div[1]/a/span/text()").extract()[0]

            item['movieRank'] = node.xpath("./div[@class='pic']/em/text()").extract()[0]

            item['Director'] = node.xpath("./div[@class='info']/div[@class='bd']/p[1]/text()[1]").extract()[0]

            if len(node.xpath("./div[@class='info']/div[@class='bd']/p[@class='quote']/span[@class='inq']/text()")):

                item['movieDesc'] = node.xpath("./div[@class='info']/div[@class='bd']/p[@class='quote']/span[@class='inq']/text()").extract()[0]

            else:

                item['movieDesc'] = ""

            item['movieRate'] = node.xpath("./div[@class='info']/div[@class='bd']/div[@class='star']/span[@class='rating_num']/text()").extract()[0]

            item['peopleCount'] = node.xpath("./div[@class='info']/div[@class='bd']/div[@class='star']/span[4]/text()").extract()[0]

            item['movieDate'] = node.xpath("./div[2]/div[2]/p[1]/text()[2]").extract()[0].lstrip().split('\xa0/\xa0')[0]

            item['movieCountry'] = node.xpath("./div[2]/div[2]/p[1]/text()[2]").extract()[0].lstrip().split('\xa0/\xa0')[1]

            item['movieCategory'] = node.xpath("./div[2]/div[2]/p[1]/text()[2]").extract()[0].lstrip().split('\xa0/\xa0')[2]

            item['moviePost'] = node.xpath("./div[@class='pic']/a/img/@src").extract()[0]

            yield item

        if self.offset <250:

            self.offset += 25

            url = self.baseURL+str(self.offset)

            yield scrapy.Request(url,callback = self.parse)
这里基本可以爬虫,产生需要的json文件。
接下来是可视化过程。
我们先梳理一下,我们掌握的数据情况。
douban = pd.read_json('douban.json',lines=True,encoding='utf-8')

douban.info()
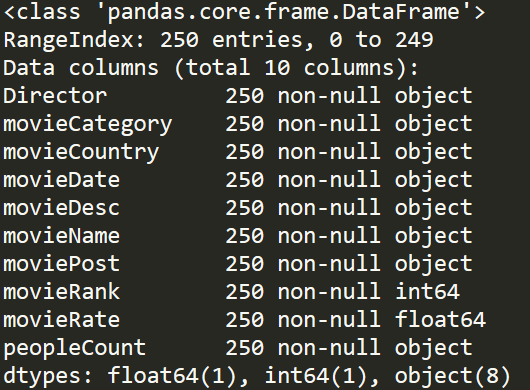
基本我们可以分析,电影国家产地,电影拍摄年份,电影类别以及一些导演在TOP250中影响力。
先做个简单了解,可以使用value_counts()函数。
douban = pd.read_json('douban.json',lines=True,encoding='utf-8')

df_Country = douban['movieCountry'].copy()

for i in range(len(df_Country)):

    item = df_Country.iloc[i].strip()

    df_Country.iloc[i] = item[0]

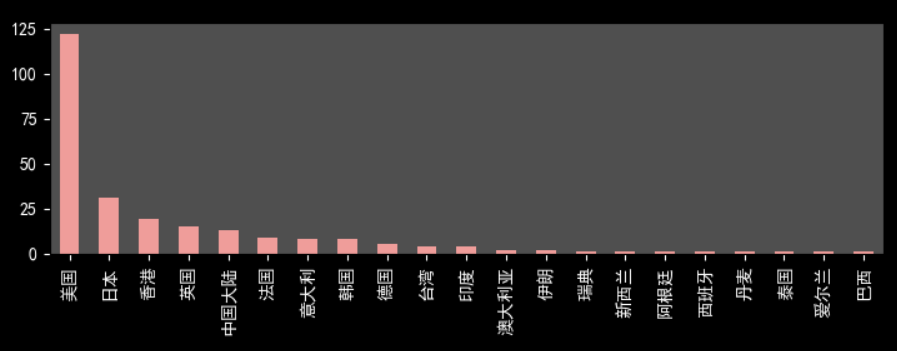
print(df_Country.value_counts())

美国电影占半壁江山,122/250,可以反映好莱坞电影工业之强大。同样,日本电影和香港电影在中国也有着重要地位。令人意外是,中国大陆地区电影数量不是令人满意。豆瓣影迷对于国内电影还是非常挑剔的。
douban = pd.read_json('douban.json',lines=True,encoding='utf-8')

df_Date = douban['movieDate'].copy()

for i in range(len(df_Date)):

    item = df_Date.iloc[i].strip()

    df_Date.iloc[i] = item[2]

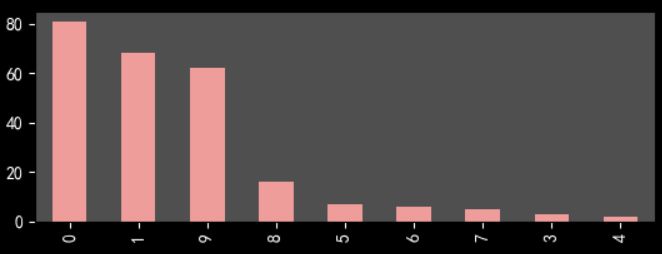
print(df_Date.value_counts())
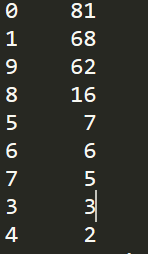
2000年以来电影数目在70%以上,考虑10代才过去9年和打分滞后性,总体来说越新的电影越能得到受众喜爱。这可能和豆瓣top250选取机制有关,必须人数在一定数量以上。
douban = pd.read_json('douban.json',lines=True,encoding='utf-8')

df_Cate = douban['movieCategory'].copy()

for i in range(len(df_Cate)):

    item = df_Cate.iloc[i].strip()

    df_Cate.iloc[i] = item[0]

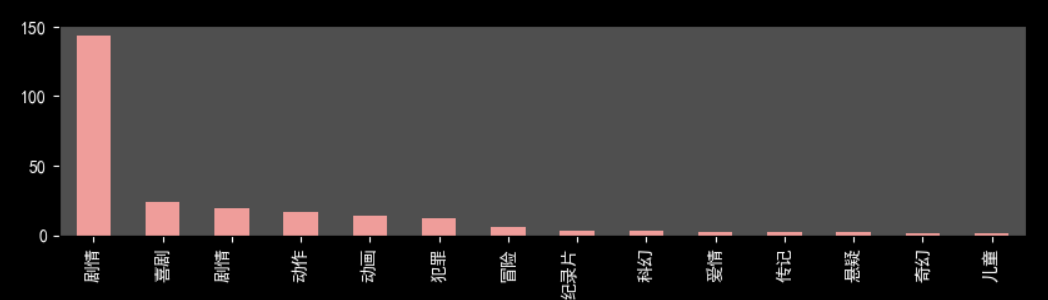
print(df_Cate.value_counts())
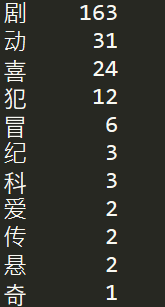
剧情电影情节起伏更容易得到观众认可。
下面展示几张可视化图片
不太会用python进行展示,有些难看。其实,推荐用Echarts等插件,或者用Excel,BI软件来处理图片,比较方便和美观。
第一次做这种爬虫和可视化,多有不足之处,恳请指出。
基于python的scrapy框架爬取豆瓣电影及其可视化的更多相关文章
- Python爬虫入门:爬取豆瓣电影TOP250
一个很简单的爬虫. 从这里学习的,解释的挺好的:https://xlzd.me/2015/12/16/python-crawler-03 分享写这个代码用到了的学习的链接: BeautifulSoup ...
- Python使用Scrapy框架爬取数据存入CSV文件(Python爬虫实战4)
1. Scrapy框架 Scrapy是python下实现爬虫功能的框架,能够将数据解析.数据处理.数据存储合为一体功能的爬虫框架. 2. Scrapy安装 1. 安装依赖包 yum install g ...
- scrapy框架爬取豆瓣读书(1)
1.scrapy框架 Scrapy,Python开发的一个快速.高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据.Scrapy用途广泛,可以用于数据挖掘.监测和自动化测试 ...
- Python的scrapy之爬取豆瓣影评和排名
基于scrapy框架的爬影评 爬虫主程序: import scrapy from ..items import DoubanmovieItem class MoviespiderSpider(scra ...
- python爬虫scrapy框架——爬取伯乐在线网站文章
一.前言 1. scrapy依赖包: 二.创建工程 1. 创建scrapy工程: scrapy staratproject ArticleSpider 2. 开始(创建)新的爬虫: cd Artic ...
- python利用scrapy框架爬取起点
先上自己做完之后回顾细节和思路的东西,之后代码一起上. 1.Mongodb 建立一个叫QiDian的库,然后建立了一个叫Novelclass(小说类别表)Novelclass(可以把一级类别二级类别都 ...
- python scrapy框架爬取豆瓣
刚刚学了一下,还不是很明白.随手记录. 在piplines.py文件中 将爬到的数据 放到json中 class DoubanmoviePipelin2json(object):#打开文件 open_ ...
- 初识python 之 爬虫:爬取豆瓣电影最热评论
主要用到lxml的etree解析网页代码,xpath获取HTML标签. 代码如下: 1 #!/user/bin env python 2 # author:Simple-Sir 3 # time:20 ...
- scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250
scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250 前言 经过上一篇教程我们已经大致了解了Scrapy的基本情况,并写了一个简单的小demo.这次我会以爬取豆瓣电影TOP250为例进一步为大 ...
随机推荐
- 1260. [CQOI2007]涂色【区间DP】
Description 假设你有一条长度为5的木版,初始时没有涂过任何颜色.你希望把它的5个单位长度分别涂上红.绿.蓝.绿.红色,用一个长度为5的字符串表示这个目标:RGBGR. 每次你可以把一段连续 ...
- 【转】 java中Class对象详解和类名.class, class.forName(), getClass()区别
Class对象的生成方式如下: 1.类名.class 说明: JVM将使用类装载器, 将类装入内存(前提是:类还没有装入内存),不做类的初始化工作.返回Class的对象 2.Cla ...
- Hive学习之路 (九)Hive的内置函数
数学函数 Return Type Name (Signature) Description DOUBLE round(DOUBLE a) Returns the rounded BIGINT valu ...
- oracle查询指定月份数据
SELECT * FROM [表名] where to_number(to_char([表中日期字段],'mm')) = [要查找的月份]
- POJ 2251 Dungeon Master(多层地图找最短路 经典bfs,6个方向)
Dungeon Master Time Limit: 1000MS Memory Limit: 65536K Total Submissions: 48380 Accepted: 18252 ...
- Cocos2d-x 3.0新引擎文件夹结构
Cocos2d-x 3.0新引擎文件夹结构 2014年4月29日 Cocos2d-x 3.0学习 作为一个Cocos2d-x的菜鸟,我倒是挺愿意关注不同版本号之间的差别,Cocos2d-x 3.0自 ...
- BUAA_OO第一单元总结性博客作业——表达式求导
一.程序设计思路 在我的三次作业中都采用了类的分层结构,采用逐项匹配,分层求导的思路. (一). 第一次作业中构建了Polynimial(多项式)类,在类的构造器中就完成了对非法空格的判断并对合法表达 ...
- 使用java发送QQ邮件的总结
最近帮朋友做个网站,实现用邮箱订阅功能,所以现在把这个发送邮件的功能放在这里,算是这两天工作的总结吧! 首先,想要实现订阅功能,要把邮箱保存,但是这个做的是个小网站,前后台交互的太少了,所以我就直接保 ...
- HDFS源码文件过大,IDEA打开失败解决方法
问题现象:hadoop 3.1.0源码文件ClientNamenodeProtocolProtos大小4M+,IDEA打开时加载失败,ClientNamenodeProtocolPB报错找不到类. - ...
- 关于Linux的交叉编译环境配置中的问题
Linux的交叉编译arm-linux-gcc搭建时,安装结束却无法查看版本.输入以下命令查看Ubuntu的版本: uname -a 可以看到此Ubuntu为64位16.04.1版本,所以需要下载32 ...