
scrapy框架爬取豆瓣读书(1)
1.scrapy框架
Scrapy,Python开发的一个快速、高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据。Scrapy用途广泛,可以用于数据挖掘、监测和自动化测试。
Scrapy吸引人的地方在于它是一个框架,任何人都可以根据需求方便的修改。它也提供了多种类型爬虫的基类,如BaseSpider、sitemap爬虫等,最新版本又提供了web2.0爬虫的支持。
主要组件:

2.快速开始
scrapy startproject douban
cd到douban根目录下执行 scrapy genspider Douban book.douban.com
原网页结构
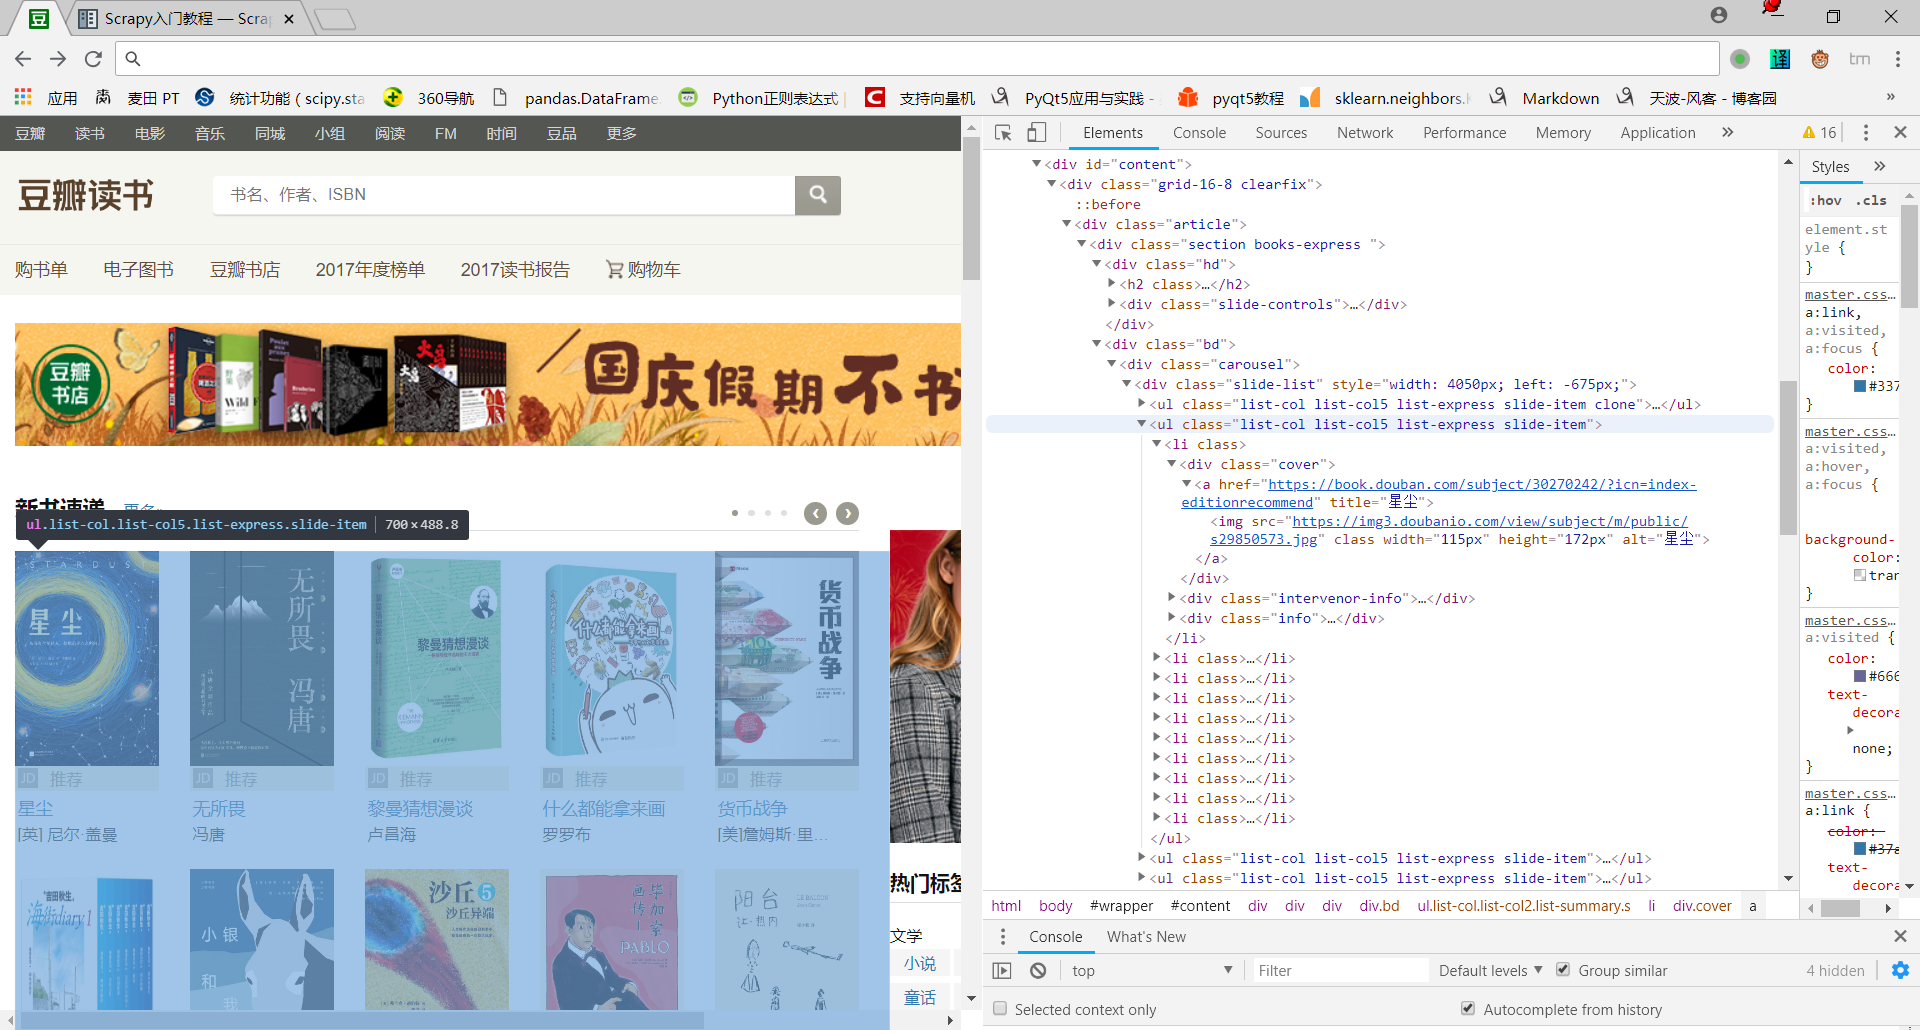
3.xpath提取
xpath是基于XML的树状结构,有不同类型的节点,包括元素节点,属性节点和文本节点,提供在数据结构树中找寻节点的能力。
xpath初探:
提取书籍排行榜图片链接,以备后续保存
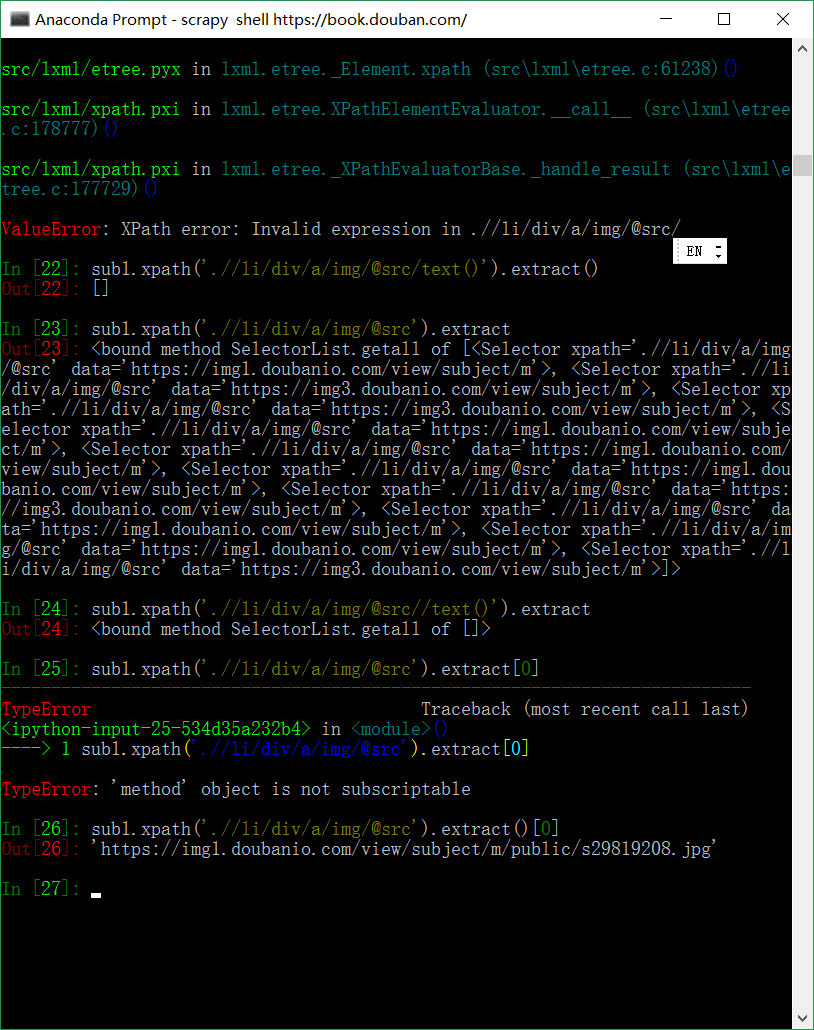
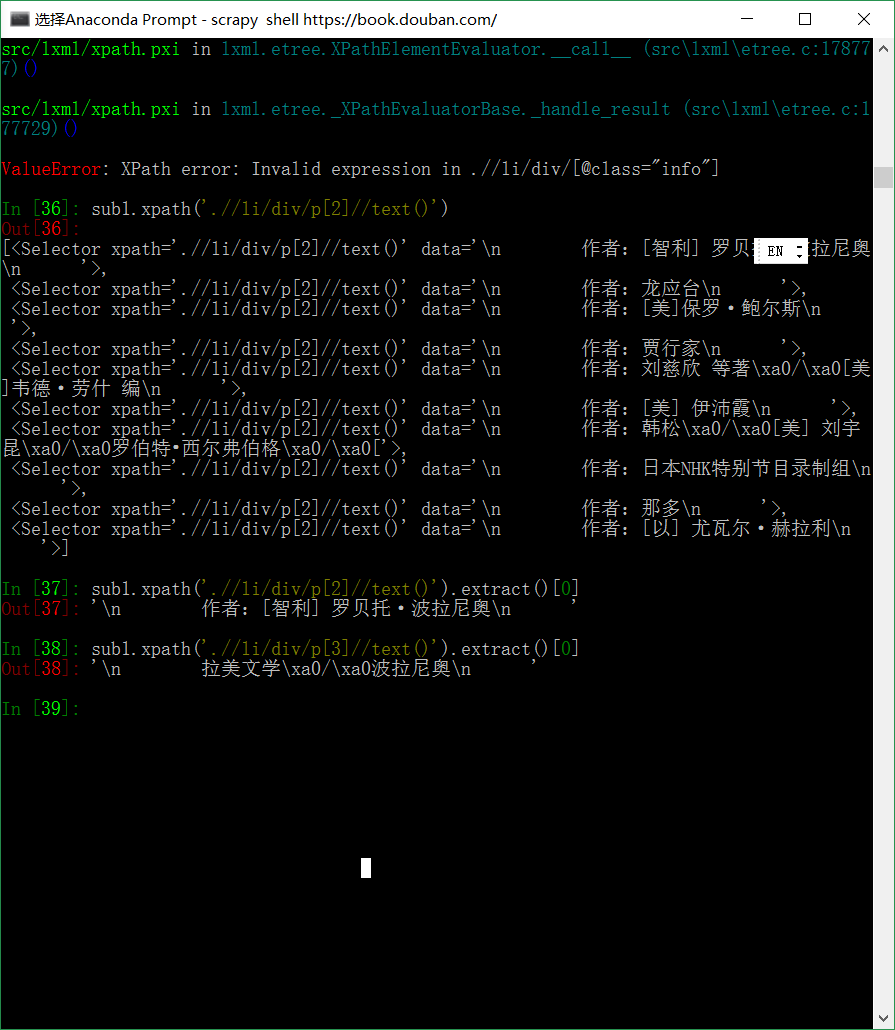
提取作者,所在地区
4.Douban.py代码
import scrapy

from douban.items import DoubanBookItem

class BookSpider(scrapy.Spider):

  name = 'douban-book'

  allowed_domains = ['douban.com']

  start_urls = [

    'https://book.douban.com'

  ]

  def parse(self, response):

    # 请求第一页

    yield scrapy.Request(response.url, callback=self.parse_next)

    #爬取其他页面

    for page in response.xpath('//div[@class="paginator"]/a'):

      link = page.xpath('@href').extract()[0]

      yield scrapy.Request(link, callback=self.parse_next)

  def parse_next(self, response):

    for item in response.xpath('//tr[@class="item"]'):

      book = DoubanBookItem()

      book['name'] = item.xpath('td[2]/div[1]/a/@title').extract()[0]

      book['content'] = item.xpath('td[2]/p/text()').extract()[0]

      book['ratings'] = item.xpath('td[2]/div[2]/span[2]/text()').extract()[0]

      yield book
5.明天继续更新items.py、pipelines(管道数据流)、middlewaares(中间件)编写

scrapy框架爬取豆瓣读书(1)的更多相关文章
- 基于python的scrapy框架爬取豆瓣电影及其可视化
1.Scrapy框架介绍 主要介绍,spiders,engine,scheduler,downloader,Item pipeline scrapy常见命令如下: 对应在scrapy文件中有,自己增加 ...
- python scrapy框架爬取豆瓣
刚刚学了一下,还不是很明白.随手记录. 在piplines.py文件中 将爬到的数据 放到json中 class DoubanmoviePipelin2json(object):#打开文件 open_ ...
- 使用scrapy框架爬取自己的博文(2)
之前写了一篇用scrapy框架爬取自己博文的博客,后来发现对于中文的处理一直有问题- - 显示的时候 [u'python\u4e0b\u722c\u67d0\u4e2a\u7f51\u9875\u76 ...
- python爬虫:利用正则表达式爬取豆瓣读书首页的book
1.问题描述: 爬取豆瓣读书首页的图书的名称.链接.作者.出版日期,并将爬取的数据存储到Excel表格Douban_I.xlsx中 2.思路分析: 发送请求--获取数据--解析数据--存储数据 1.目 ...
- scrapy框架爬取笔趣阁完整版
继续上一篇,这一次的爬取了小说内容 pipelines.py import csv class ScrapytestPipeline(object): # 爬虫文件中提取数据的方法每yield一次it ...
- scrapy框架爬取笔趣阁
笔趣阁是很好爬的网站了,这里简单爬取了全部小说链接和每本的全部章节链接,还想爬取章节内容在biquge.py里在加一个爬取循环,在pipelines.py添加保存函数即可 1 创建一个scrapy项目 ...
- Python使用Scrapy框架爬取数据存入CSV文件(Python爬虫实战4)
1. Scrapy框架 Scrapy是python下实现爬虫功能的框架,能够将数据解析.数据处理.数据存储合为一体功能的爬虫框架. 2. Scrapy安装 1. 安装依赖包 yum install g ...
- 爬虫入门(四)——Scrapy框架入门:使用Scrapy框架爬取全书网小说数据
为了入门scrapy框架,昨天写了一个爬取静态小说网站的小程序 下面我们尝试爬取全书网中网游动漫类小说的书籍信息. 一.准备阶段 明确一下爬虫页面分析的思路: 对于书籍列表页:我们需要知道打开单本书籍 ...
- 使用scrapy框架爬取自己的博文(3)
既然如此,何不再抓一抓网页的文字内容呢? 谷歌浏览器有个审查元素的功能,就是按树的结构查看html的组织形式,如图: 这样已经比较明显了,博客的正文内容主要在div 的class = cnblogs_ ...
随机推荐
- Appium+python自动化3-启动淘宝app【转载】
前言 前面两篇环境已经搭建好了,接下来就是需要启动APP,如何启动app呢?首先要获取包名,然后获取launcherActivity.获取这两个关键东西的方法很多,这里就不一一多说,小伙伴们可以各显神 ...
- [BZOJ1834][ZJOI2010]network 网络扩容 最大流+费用流
1834: [ZJOI2010]network 网络扩容 Time Limit: 3 Sec Memory Limit: 64 MB Submit: 3330 Solved: 1739 [Subm ...
- JDK7集合框架源码阅读(一) ArrayList
基于版本jdk1.7.0_80 java.util.ArrayList 代码如下 /* * Copyright (c) 1997, 2013, Oracle and/or its affiliates ...
- 学习PHP注意事项
1 多阅读手册和源代码 没什么比阅读手册更值得强调的事了–仅仅通过阅读手册你就可以学习到很多东西,特别是很多有关于字符串和数组的函数.就在这些函数里面包括许多有用的功能,如果你仔细阅读手册,你会经常发 ...
- 线段树【SP1043】GSS1 - Can you answer these queries I
Description 给出了序列\(A_1,A_2,-,A_n\). \(a_i \leq 15007,1 \leq n \leq 50000\).查询定义如下: 查询\((x,y)=max{a_i ...
- hiho一下第129周 后缀自动机二·重复旋律6
后缀自动机三·重复旋律6 时间限制:15000ms 单点时限:3000ms 内存限制:512MB 描述 小Hi平时的一大兴趣爱好就是演奏钢琴.我们知道一个音乐旋律被表示为一段数构成的数列. 现在小Hi ...
- HDU 4034 Graph Floyd最短路
原题链接:http://acm.hdu.edu.cn/showproblem.php?pid=4034 题意: 给你一个最短路的表,让你还原整个图,并使得边最少 题解: 这样想..这个表示通过floy ...
- [BZOJ5110]Yazid的新生舞会
题目大意: 给你一个长度为$n(n\leq 5\times 10^5)$的序列$A_{1\sim n}$.求满足区间众数在区间内出现次数严格大于$\lfloor\frac{r-l+1}{2}\rflo ...
- Jackson的高级应用(转)
Jackson 是当前用的比较广泛的,用来序列化和反序列化 JSON 的 Java 的开源框架.Jackson 社 区相对比较活跃,更新速度也比较快, 从 Github 中的统计来看,Jackson ...
- IOS设置UIView的边框为圆角
iOS 系统自带的 View 组件都是正方形的,看起来都太生硬,有时候我需要变成圆角形式,如下图: 具体的实现是使用QuartzCore库,下面我具体的描述一下实现过程: • 首先 ...