
Spark入门之环境搭建
本教程是虚拟机搭建Spark环境和用idea编写脚本
一、前提准备
需要已经有搭建好的虚拟机环境,具体见教程大数据学习之路又之从小白到用sqoop导出数据 - 我试试这个昵称好使不 - 博客园 (cnblogs.com)
需要已经安装了idea或着eclipse(教程以idea为例)
二、环境搭建
1、下载Spark安装包(我下载的 spark-3.0.1-bin-hadoop2.7.tgz)
下载地址Scala 2.12.8 | The Scala Programming Language (scala-lang.org)
2、上传到虚拟机并解压(没备注就是主节点运行)
tar -zxvf spark-3.0.1-bin-hadoop2.7.tgz
3、修改权限
chown -R hadoop /export/server/spark-3.0.1-bin-hadoop2.7

chgrp -R hadoop /export/server/spark-3.0.1-bin-hadoop2.7
4、创建软连接
ln -s /export/server/spark-3.0.1-bin-hadoop2.7 /export/server/spark
5、启动spark交互式窗口
/export/server/spark/bin/spark-shell
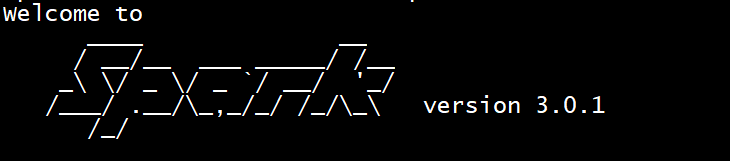
还是很炫酷的哈哈哈,出现这个说明spark环境就搭建好了吗?漏!!!
6、配置Spark集群
cd /export/server/spark/conf

mv slaves.template slaves

vim slaves
添加
node02

node03

node04
7.配置master
cd /export/server/spark/conf

mv spark-env.sh.template spark-env.sh

vim spark-env.sh
增加如下内容:
## 设置JAVA安装目录

JAVA_HOME=/linmob/install/jdk1.8.0_141

## HADOOP软件配置文件目录,读取HDFS上文件和运行Spark在YARN集群时需

要,先提前配上

HADOOP_CONF_DIR=/linmob/install/hadoop-3.1.4/etc/hadoop

YARN_CONF_DIR=/linmob/install/hadoop-3.1.4/etc/hadoop

## 指定spark老大Master的IP和提交任务的通信端口

#SPARK_MASTER_HOST=node01

SPARK_MASTER_PORT=7077

SPARK_MASTER_WEBUI_PORT=8080

SPARK_WORKER_CORES=1

SPARK_WORKER_MEMORY=1g

SPARK_DAEMON_JAVA_OPTS="-Dspark.deploy.recoveryMode=ZOOKEEPER -Dspark.deploy.zookeeper.url=node01:2181,node02:2181,node03:2181,node04:2181 -Dspark.deploy.zookeeper.dir=/spark-ha"

## 配置spark历史日志存储地址

SPARK_HISTORY_OPTS="-Dspark.history.fs.logDirectory=hdfs://node01:8020/sparklog/ -Dspark.history.fs.cleaner.enabled=true"
8、将配置好的将 Spark 安装包分发给集群中其它机器,命令如下:
cd /export/server/

scp -r spark-3.0.1-bin-hadoop2.7 hadoop@node02:$PWD

scp -r spark-3.0.1-bin-hadoop2.7 hadoop@node03:$PWD

scp -r spark-3.0.1-bin-hadoop2.7 hadoop@node04:$PWD
9、创建软连接(每个节点都运行一遍)
ln -s /export/server/spark-3.0.1-bin-hadoop2.7 /export/server/spark
10、配置Yarn历史服务器并关闭资源检查
vim /export/server/hadoop/etc/hadoop/yarn-site.xml
少的部分补上
<configuration>

<!-- 配置yarn主节点的位置 -->

<property>

<name>yarn.resourcemanager.hostname</name>

<value>node01</value>

</property>

<property>

<name>yarn.nodemanager.aux-services</name>

<value>mapreduce_shuffle</value>

</property>

<!-- 设置yarn集群的内存分配方案 -->

<property>

<name>yarn.nodemanager.resource.memory-mb</name>

<value>20480</value>

</property>

<property>

<name>yarn.scheduler.minimum-allocation-mb</name>

<value>2048</value>

</property>

<property>

<name>yarn.nodemanager.vmem-pmem-ratio</name>

<value>2.1</value>

</property>

<!-- 开启日志聚合功能 -->

<property>

<name>yarn.log-aggregation-enable</name>

<value>true</value>

</property>

<!-- 设置聚合日志在hdfs上的保存时间 -->

<property>

<name>yarn.log-aggregation.retain-seconds</name>

<value>604800</value>

</property>

<!-- 设置yarn历史服务器地址 -->

<property>

<name>yarn.log.server.url</name>

<value>http://node1:19888/jobhistory/logs</value>

</property>

<!-- 关闭yarn内存检查 -->

<property>

<name>yarn.nodemanager.pmem-check-enabled</name>

<value>false</value>

</property>

<property>

<name>yarn.nodemanager.vmem-check-enabled</name>

<value>false</value>

</property>

</configuration>
注意:如果之前没有配置,现在配置了需要分发并重启yarn(重启需要每个节点都运行)
cd /export/server/hadoop/etc/hadoop

scp -r yarn-site.xml hadoop@node02:$PWD

scp -r yarn-site.xml hadoop@node03:$PWD


scp -r yarn-site.xml hadoop@node04:$PWD

/export/server/hadoop/sbin/stop-yarn.sh

/export/server/hadoop/sbin/start-yarn.sh
11、配置Spark的历史服务器和Yarn的整合
cd /export/server/spark/conf

mv spark-defaults.conf.template spark-defaults.conf

vim spark-defaults.conf
添加
spark.eventLog.enabled true


spark.eventLog.dir hdfs://node01:8020/sparklog/


spark.eventLog.compress true


spark.yarn.historyServer.address node01:18080
手动创建
hadoop fs -mkdir -p /sparklog
12、修改日志级别
cd /export/server/spark/conf

mv log4j.properties.template log4j.properties

vim log4j.properties
修改
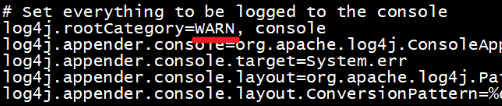
分发-可选,如果只在node1上提交spark任务到yarn,那么不需要分发
cd /export/server/spark/conf

scp -r spark-env.sh hadoop@node02:$PWD

scp -r spark-env.sh hadoop@node03:$PWD

scp -r spark-env.sh hadoop@node04:$PWD

scp -r spark-defaults.conf hadoop@node02:$PWD

scp -r spark-defaults.conf hadoop@node03:$PWD

scp -r spark-defaults.conf hadoop@node04:$PWD

scp -r log4j.properties hadoop@node02:$PWD

scp -r log4j.properties hadoop@node03:$PWD

scp -r log4j.properties hadoop@node04:$PWD
13、配置依赖的Spark的jar包
hadoop fs -mkdir -p /spark/jars/

hadoop fs -put /export/server/spark/jars/* /spark/jars/

vim /export/server/spark/conf/spark-defaults.conf
添加内容
spark.yarn.jars hdfs://node1:8020/spark/jars/*
分发同步-可选
cd /export/server/spark/conf

scp -r spark-defaults.conf hadoop@node02:$PWD

scp -r spark-defaults.conf hadoop@node03:$PWD

scp -r spark-defaults.conf hadoop@node04:$PWD
14、启动服务
- 启动HDFS和YARN服务,在主节点上启动spark集群
/export/server/spark/sbin/start-all.sh
-启动MRHistoryServer服务,在node01执行命令
mr-jobhistory-daemon.sh start historyserver
- 启动Spark HistoryServer服务,,在node01执行命令
/export/server/spark/sbin/start-history-server.sh
15、测试
看下个博客Spark入门之idea编写Scala脚本 - 我试试这个昵称好使不 - 博客园 (cnblogs.com)
三、总结:
在主节点上启动spark集群

/export/server/spark/sbin/start-all.sh

在主节点上停止spark集群

/export/server/spark/sbin/stop-all.sh
spark: 4040 任务运行web-ui界面端口
spark: 8080 spark集群web-ui界面端口
spark: 7077 spark提交任务时的通信端口
hadoop: 50070集群web-ui界面端口
hadoop:8020/9000(老版本) 文件上传下载通信端口
Spark入门之环境搭建的更多相关文章
- Hadoop+Spark:集群环境搭建
环境准备: 在虚拟机下,大家三台Linux ubuntu 14.04 server x64 系统(下载地址:http://releases.ubuntu.com/14.04.2/ubuntu-14.0 ...
- 【个人笔记】003-PHP基础-01-PHP快速入门-03-PHP环境搭建
003-PHP基础-01-PHP快速入门 03-PHP环境搭建 1.客户端(浏览器) IE FireFox CHROME Opera Safari 2.服务器 是运行网站的基本 是放置程序代码的地方 ...
- Android入门之环境搭建
欢迎访问我的新博客:http://www.milkcu.com/blog/ 原文地址:http://www.milkcu.com/blog/archives/1376935560.html 原创:An ...
- spark JAVA 开发环境搭建及远程调试
spark JAVA 开发环境搭建及远程调试 以后要在项目中使用Spark 用户昵称文本做一下聚类分析,找出一些违规的昵称信息.以前折腾过Hadoop,于是看了下Spark官网的文档以及 github ...
- scala 入门Eclipse环境搭建
scala 入门Eclipse环境搭建及第一个入门经典程序HelloWorld IDE选择并下载: scala for eclipse 下载: http://scala-ide.org/downloa ...
- Spark+IDEA单机版环境搭建+IDEA快捷键
1. IDEA中配置Spark运行环境 请参考博文:http://www.cnblogs.com/jackchen-Net/p/6867838.html 3.1.Project Struct查看项目的 ...
- 新手嘛,先学习下 Vue2.0 新手入门 — 从环境搭建到发布
Vue2.0 新手入门 — 从环境搭建到发布 转自:http://www.runoob.com/w3cnote/vue2-start-coding.html 具体文章详细就不搬了,步骤可过去看,我这就 ...
- Spark 集群环境搭建
思路: ①先在主机s0上安装Scala和Spark,然后复制到其它两台主机s1.s2 ②分别配置三台主机环境变量,并使用source命令使之立即生效 主机映射信息如下: 192.168.32.100 ...
- scala 入门Eclipse环境搭建及第一个入门经典程序HelloWorld
scala 入门Eclipse环境搭建及第一个入门经典程序HelloWorld 学习了: http://blog.csdn.net/wangmuming/article/details/3407911 ...
随机推荐
- 二、python数据类型详解
基本概念 迭代(iteration):如果给定一个list或tuple,我们可以通过for循环来遍历,这种遍历我们称为迭代(iteration) 可变:value改变,id不变,可变类型是不可hash ...
- 矩池云 | 利用LSTM框架实时预测比特币价格
温馨提示:本案例只作为学习研究用途,不构成投资建议. 比特币的价格数据是基于时间序列的,因此比特币的价格预测大多采用LSTM模型来实现. 长期短期记忆(LSTM)是一种特别适用于时间序列数据(或具有时 ...
- linux基础篇--复习重点成长之路
linux阶段性复习提纲 1.xshell与shell之间的区别 shell shell是一个由C语言编写的程序,它的主要作用就是在用户和操作系统之间搭起一道桥梁(人机操作界面).直接在命令行执行 ...
- k8s线上某些特殊情况强制删除 StatefulSet 的 Pod 要考虑什么隐患?
k8s线上某些特殊情况强制删除 StatefulSet 的 Pod 要考虑什么隐患? 考点之什么情况下,需要强制删除 StatefulSet 的 Pod? 考点之如果 StatefulSet 操作不当 ...
- laravel7 微信小程序获取openid
l 通过微信公众号获取appid和appsecret l 在小程序页面中编写代码获取code l 在后端编写方法,换取openid l 添加一个按钮,给按钮一个开放能力 open-type=" ...
- think php 路由增删改查(搜索+关键字标红+缩略图)
路由 use think\Route; //展示添加表单 Route::get('create','user/user/create'); //表单提交数据 Route::post('save','u ...
- Source Code Reading for Vue 3: How does `hasChanged` work?
Hey, guys! The next generation of Vue has released already. There are not only the brand new composi ...
- docker基础命令,常用操作
docker基础命令 使用docker镜像 获取镜像 从docker registry获取镜像的命令是docker pull.命令格式是: docker pull [选项][docker regist ...
- python 命令行参数学习(二)
照着例子看看打打,码了就会.写了个命令行参数调用进行运算的脚本. 参考文章链接:http://www.jianshu.com/p/a50aead61319 #-*-coding:utf-8-*- __ ...
- MATLAB奔溃仅左上角显示关闭界面X
一 问题描述 今天在MATLAB调试图像增强程序时,忽然间点了MATLAB向下还原,奇怪的一幕发生了,电脑左上角仅显示关闭图标X.我就搜了MATLAB中文论坛(https://www.ilovema ...