
网络爬虫及openyxl模块
网络爬虫及openyxl模块
一、第三方模块简介
1.第三方模块的用处
python之所以在这么多的编程语言中脱颖而出的优点是有众多的第三方库函数,可以更高效率的实现开发
2.第三方模块的使用
1.第三方模块必须下载才能使用

 格式:pip install 模块名 -i 源地址

        清华大学 :https://pypi.tuna.tsinghua.edu.cn/simple/

        阿里云:http://mirrors.aliyun.com/pypi/simple/

        中国科学技术大学 :http://pypi.mirrors.ustc.edu.cn/simple/

        华中科技大学:http://pypi.hustunique.com/

        豆瓣源:http://pypi.douban.com/simple/

        腾讯源:http://mirrors.cloud.tencent.com/pypi/simple

        华为镜像源:https://repo.huaweicloud.com/repository/pypi/simple/

2.可在终端借助pip工具下载

格式:

    下载第三方模块的句式:pip install 模块名

    下载第三方模块临时切换仓库的句式:pip install 模块名 -i 仓库地址

    下载第三方模块指定版本(不指定默认是最新版):pip install 模块名 == 版本号 -i 仓库地址

注:在下载解释器pip解释器工具的时候,电脑上有多个版本的解释器时一定要注意到底用的是哪一个,在使用或者添加的时候一定要看清楚对应的版本号

3.在pycharm中也可以直接下载
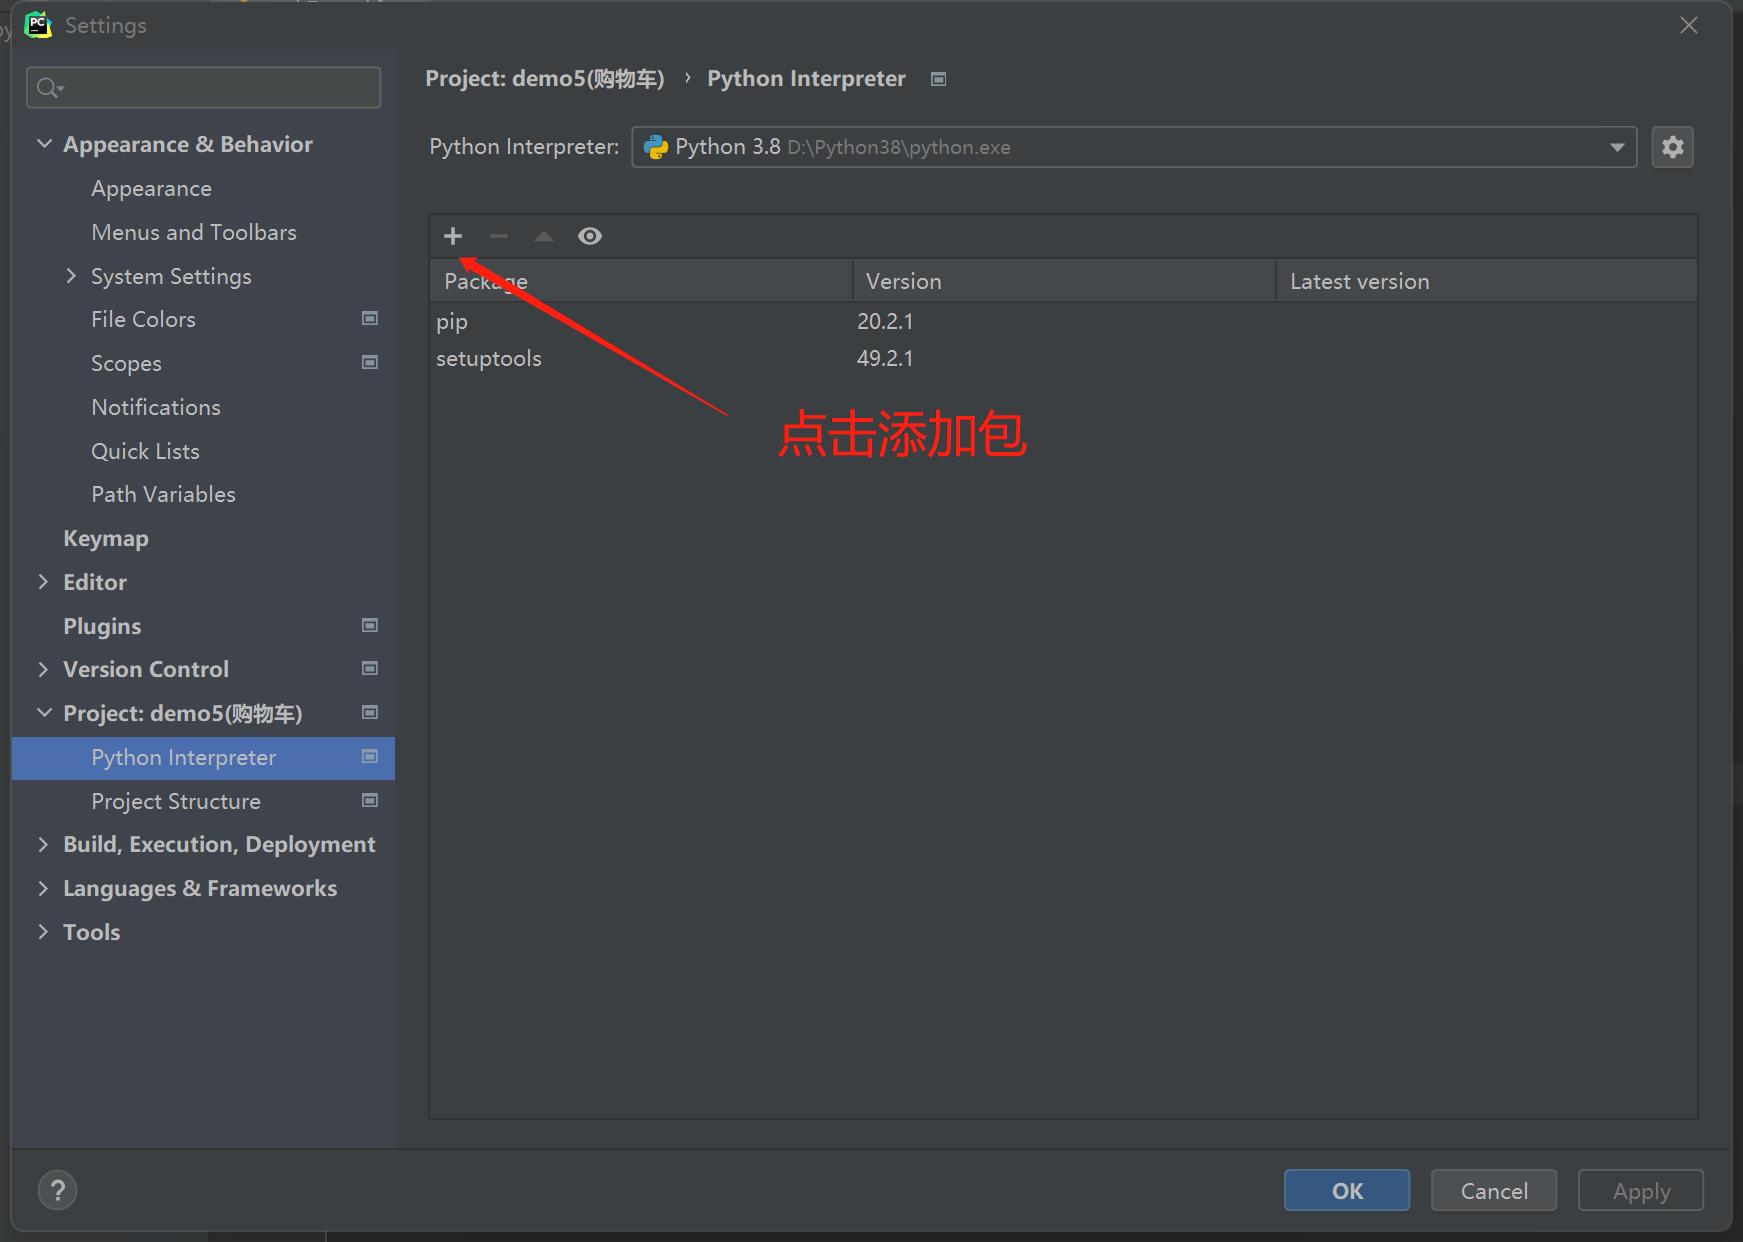
3.下载第三方模块的注意点
1.pip版本过低并有警告信息

 # WARNING: You are using pip version 20.3.1;

 原因是pip版本过低,只需要输入命令行更新模块就好了

 python -m pip install --upgrade pip

2.报错含有Timeout关键字

  说明当前计算机的网络不稳定,只需要换网或者程序执行几次即可

3.报错没有关键字

  将关键字复制到百度进行搜索,然后进行解决

4.下载速度很慢

  		pip默认下载的仓库地址是国外的 python.org

		我们可以切换下载的地址

		pip install 模块名 -i 仓库地址

		pip的仓库地址有很多 百度查询即可
二、网络爬虫基础实战
import requests

import re

headers = {

    'user-agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/103.0.0.0 Safari/537.36'

}

res = requests.get('http://www.redbull.com.cn/about/branch', headers=headers)

data = res.text

res.encoding = 'utf-8'  # 可以直接用utf-8对数据进行转码

with open(r'hn.html', 'wb') as f:

    f.write(res.content)

# 1.获取所有的分公司名称

company_name_list = re.findall('<h2>(.*?)</h2>', data)

# 2.获取所有的分公司地址

company_addr_list = re.findall("<p class='mapIco'>(.*?)</p>", data)

# 3.获取所有的分公司邮箱

company_email_list = re.findall("<p class='mailIco'>(.*?)</p>", data)

# 4.获取所有的分公司电话

company_phone_list = re.findall("<p class='telIco'>(.*?)</p>", data)

# 5.将上述四个列表中的数据按照位置整合

res = zip(company_name_list, company_addr_list, company_email_list, company_phone_list)

# 6.处理数据(展示 保存 excel)

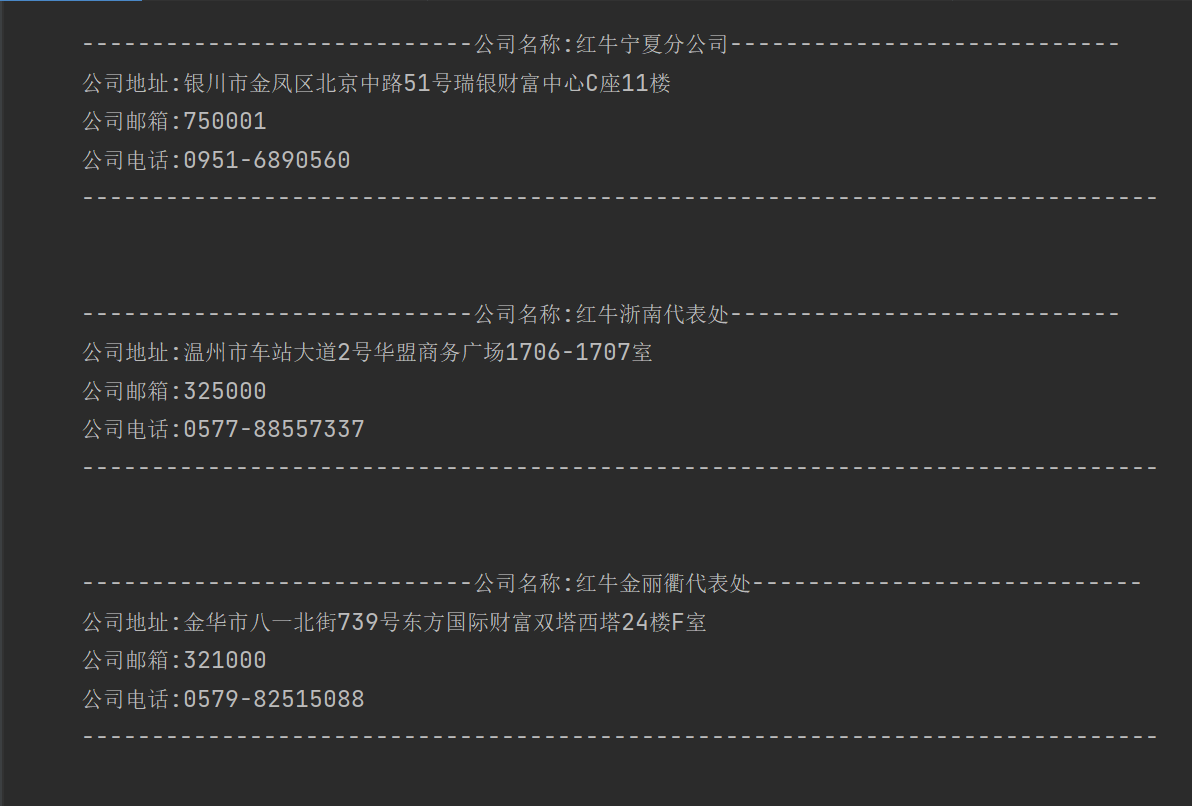
for i in res:

    print("""

    ----------------------------公司名称:%s----------------------------

    公司地址:%s

    公司邮箱:%s

    公司电话:%s

    -----------------------------------------------------------------------------

    """ % i)
三、openpyxl模块
1.openpyxl模块的作用

  主要用于操作excel表格,实现自动化办公

2.Excel文件的后缀名的问题

   03版本之前 ---->>> .xls

   03版本之后 ---->>> .xlsx

3.操作excel表格的第三方模块

  xlwt往表格写入数据、wlrd从表格读取数据

    兼容性强

  openpyxl最近几年比较火热的操作excel表格的模块

    03版本之前的兼容性较差
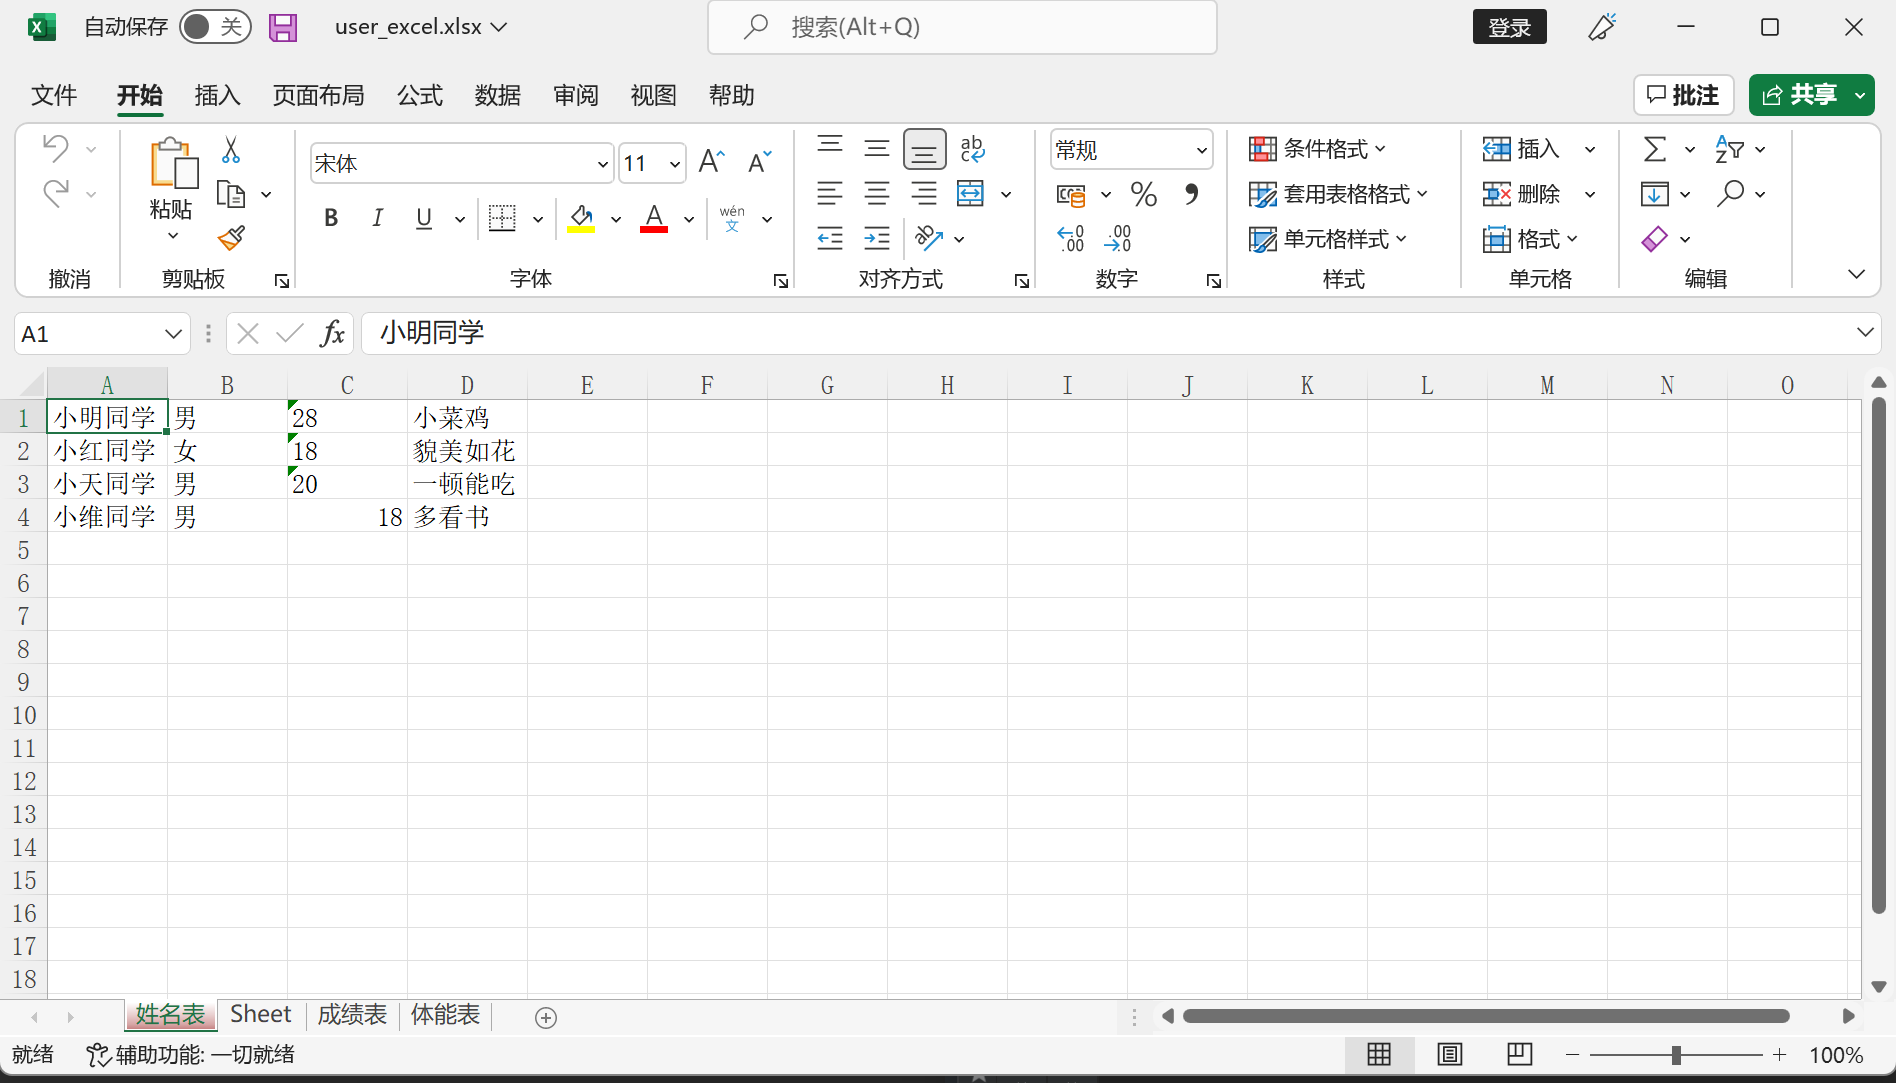
实战:

from openpyxl import Workbook

user_excel = Workbook()  # 创建excel

grades = user_excel.create_sheet('成绩表')  #成绩表

physique = user_excel.create_sheet('体质表')  #体质表

name = user_excel.create_sheet('姓名表',0)  #姓名表

physique.title = '体能表'

name.sheet_properties.tabColor = '8B0000' #修改姓名表的颜色

# 第一种写入方式

name['A1'] = '小明同学'

name['B1'] = '男'

# 第二种写入方式

name.cell(row=1, column=3, value='28')

name.cell(row=1, column=4, value='小菜鸡')

# 第三种写入方式(批量写入)

name.append(['小红同学', '女', '18', '貌美如花'])

name.append(['小天同学','男', '20', '一顿能吃'])

name.append(['小维同学', '男', 18, '多看书'])

user_excel.save(r'user_excel.xlsx')  # 保存文件
网络爬虫及openyxl模块的更多相关文章
- 04.Python网络爬虫之requests模块(1)
引入 Requests 唯一的一个非转基因的 Python HTTP 库,人类可以安全享用. 警告:非专业使用其他 HTTP 库会导致危险的副作用,包括:安全缺陷症.冗余代码症.重新发明轮子症.啃文档 ...
- Python网络爬虫之requests模块(1)
引入 Requests 唯一的一个非转基因的 Python HTTP 库,人类可以安全享用. 警告:非专业使用其他 HTTP 库会导致危险的副作用,包括:安全缺陷症.冗余代码症.重新发明轮子症.啃文档 ...
- 04,Python网络爬虫之requests模块(1)
引入 Requests 唯一的一个非转基因的 Python HTTP 库,人类可以安全享用. 警告:非专业使用其他 HTTP 库会导致危险的副作用,包括:安全缺陷症.冗余代码症.重新发明轮子症.啃文档 ...
- 06.Python网络爬虫之requests模块(2)
今日内容 session处理cookie proxies参数设置请求代理ip 基于线程池的数据爬取 知识点回顾 xpath的解析流程 bs4的解析流程 常用xpath表达式 常用bs4解析方法 引入 ...
- Python网络爬虫之requests模块(2)
session处理cookie proxies参数设置请求代理ip 基于线程池的数据爬取 xpath的解析流程 bs4的解析流程 常用xpath表达式 常用bs4解析方法 引入 有些时候,我们在使用爬 ...
- Python网络爬虫之requests模块
今日内容 session处理cookie proxies参数设置请求代理ip 基于线程池的数据爬取 知识点回顾 xpath的解析流程 bs4的解析流程 常用xpath表达式 常用bs4解析方法 引入 ...
- Python网络爬虫之BeautifulSoup模块
一.介绍: Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式.Beautiful Soup会帮 ...
- 网络爬虫之Selenium模块和Xpath表达式+Lxml解析库的使用
实际生产环境下,我们一般使用lxml的xpath来解析出我们想要的数据,本篇博客将重点整理Selenium和Xpath表达式,关于CSS选择器,将另外再整理一篇! 一.介绍: selenium最初是一 ...
- 网络爬虫之requests模块的使用+Github自动登入认证
本篇博客将带领大家梳理爬虫中的requests模块,并结合Github的自动登入验证具体讲解requests模块的参数. 一.引入: 我们先来看如下的例子,初步体验下requests模块的使用: ...
- 【网络爬虫入门03】爬虫解析利器beautifulSoup模块的基本应用
[网络爬虫入门03]爬虫解析利器beautifulSoup模块的基本应用 1.引言 网络爬虫最终的目的就是过滤选取网络信息,因此最重要的就是解析器了,其性能的优劣直接决定这网络爬虫的速度和效率.B ...
随机推荐
- Java集合精选常见面试题
前言 博主只是这篇文章的搬运工,为了加强记忆自己梳理了一遍并扩展了部分内容. 集合拓展链接:集合概述&集合之Collection接口 - 至安 - 博客园 (cnblogs.com) Java ...
- EXCEL_BASIC
公式类 比较大小 A1单元格的值大于B1单元格时为"A",小于时为"a",等于时为"e" =IF(A1>B1,"A" ...
- C#11之原始字符串
最近.NET7.0和C#11相继发布,笔者也是第一时间就用上了C#11,其中C#11的有一个更新能解决困扰我多年的问题,也就是文章的标题原始字符串. 在使用C#11的原始字符串时,发现的一些有意思的东 ...
- 初探Java安全之JavaAgent
About Java Agent Java Agent的出现 在JDK1.5版本开始,Java增加了Instrumentation(Java Agent API)和JVMTI(JVM Tool Int ...
- vscode配置remote ssh
前言 简单用vscode配置 remote ssh可以实现,通过ssh 在线使用vscode编辑文件,很方便,也遇到一些坑. 安装插件 设置界面 右键最左边tab栏: 勾选 远程资源管理器 添加远程服 ...
- ORCL 时间
一.计算时间差 两个Date类型字段:START_DATE,END_DATE,计算这两个日期的时间差(分别以天,小时,分钟,秒,毫秒): 天: ROUND(TO_NUMBER(END_DATE - S ...
- Asp.Net Core&Jaeger实现链路追踪
前言 随着应用愈发复杂,请求的链路也愈发复杂,微服务化下,更是使得不同的服务分布在不同的机器,地域,语言也不尽相同.因此需要借助工具帮助分析,跟踪,定位请求中出现的若干问题,以此来保障服务治理,链路追 ...
- 【数据结构与算法】希尔排序 python和c++实现
算法思路 每一次:固定间隔把数据分组,每一组进行排序 每次比上次选取更小的间隔分组,再每组排序,直到间隔为1 代码 c++:(越看越不明白了,后看) int gap = length;//length ...
- ORM执行sql语句 双下划线 外键字段创建 ORM跨表查询
目录 模型层之ORM执行SQL语句 方式1一 方式二 方式三 神奇的双下划线查询 ORM外键字段的创建 1.创建基础表 2.确定外键关系 3.表的查看 数据的录入 外键字段相关操作 针对一对多 ''' ...
- 周结之json补充、正则re模块、hashlib模块、logging模块
周结 目录 周结 json补充 正则表达式 re模块 第三方模块的下载 request模块 办公自动化openpyxl模块 hashlib加密模块 subprocess模块 logging日志模块 j ...