
python爬虫:利用正则表达式爬取豆瓣读书首页的book
1、问题描述:
爬取豆瓣读书首页的图书的名称、链接、作者、出版日期,并将爬取的数据存储到Excel表格Douban_I.xlsx中
2、思路分析:
发送请求--获取数据--解析数据--存储数据
1、目标网址:https://book.douban.com/
2、利用requests.get()方法向豆瓣读书首页发送请求,获取首页的HTML源代码
#目标网址

targetUrl = "https://book.douban.com/"

#发送请求,获取响应

response = requests.get(targetUrl).text
3、利用正则re.findall()解析出想要的信息: Name Url Author Date
#编译成正则表达式对象,便于复用该匹配模式

pattern = re.compile('<li.*?title="(.*?)".*?href="(.*?)".*?more-meta.*?author">(.*?)</span>.*?year">(.*?)</span>.*?</li>', re.S)

results = re.findall(pattern, response)
4、将数据存储到Excel表格中
workBook = xlwt.Workbook(encoding='utf-8') #创建Excel表,并确定编码方式

sheet = workBook.add_sheet("Douban_I")

headData = ["书名", "链接", "作者", "出版日期"]  #表头信息

for colNum in range(len(headData)):

    sheet.write(0, colNum, headData[colNum])

raw = 1

for book in results: #书籍信息:名称、链接、作者、出版日期

    # name, url, author, date = book

    for column in range(len(book)):

        sheet.write(raw, column, book[column].strip())

    raw += 1

workBook.save(".\Douban_I.xlsx")
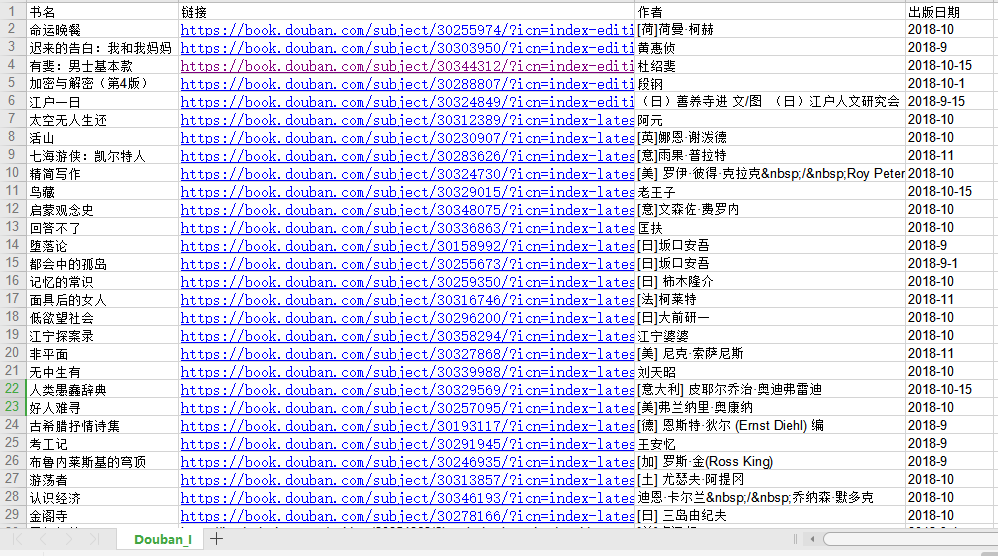
3、效果展示
4、完整代码:
# -* coding: utf-8 *-

# author: wangshx6

# date: 2018-11-04

# description: 爬取豆瓣读书首页的图书的名称、链接、作者、出版日期,并将爬取的数据存储到Excel表格Douban_I.xlsx中

import requests

import re

import xlwt

#目标网址

targetUrl = "https://book.douban.com/"

#发送请求,获取响应

response = requests.get(targetUrl).text

''' 利用正则表达式解析出关键内容: Name Url Author Date  '''

#re.compile()是将正则字符串编译成正则表达式对象,便于复用该匹配模式

#re.S 多行匹配(换行)

pattern = re.compile('<li.*?title="(.*?)".*?href="(.*?)".*?more-meta.*?author">(.*?)</span>.*?year">(.*?)</span>.*?</li>', re.S)

results = re.findall(pattern, response)

#将数据列表存储到Excel表格Douban_I.xlsx中

workBook = xlwt.Workbook(encoding='utf-8')

sheet = workBook.add_sheet("Douban_I")

headData = ["书名", "链接", "作者", "出版日期"]  #表头

for colNum in range(len(headData)):

    sheet.write(0, colNum, headData[colNum])

raw = 1

for book in results:

    # name, url, author, date = book

    for column in range(len(book)):

        sheet.write(raw, column, book[column].strip())

    raw += 1

workBook.save(".\Douban_I.xlsx")
python爬虫:利用正则表达式爬取豆瓣读书首页的book的更多相关文章
- Python爬虫实例:爬取豆瓣Top250
入门第一个爬虫一般都是爬这个,实在是太简单.用了 requests 和 bs4 库. 1.检查网页元素,提取所需要的信息并保存.这个用 bs4 就可以,前面的文章中已经有详细的用法阐述. 2.找到下一 ...
- Python爬虫入门:爬取豆瓣电影TOP250
一个很简单的爬虫. 从这里学习的,解释的挺好的:https://xlzd.me/2015/12/16/python-crawler-03 分享写这个代码用到了的学习的链接: BeautifulSoup ...
- python实例:自动爬取豆瓣读书短评,分析短评内容
思路: 1.打开书本“更多”短评,复制链接 2.脚本分析链接,通过获取短评数,计算出页码数 3.通过页码数,循环爬取当页短评 4.短评写入到txt文本 5.读取txt文本,处理文本,输出出现频率最高的 ...
- python爬虫——利用BeautifulSoup4爬取糗事百科的段子
import requests from bs4 import BeautifulSoup as bs #获取单个页面的源代码网页 def gethtml(pagenum): url = 'http: ...
- Python爬虫实例:爬取猫眼电影——破解字体反爬
字体反爬 字体反爬也就是自定义字体反爬,通过调用自定义的字体文件来渲染网页中的文字,而网页中的文字不再是文字,而是相应的字体编码,通过复制或者简单的采集是无法采集到编码后的文字内容的. 现在貌似不少网 ...
- Python爬虫实例:爬取B站《工作细胞》短评——异步加载信息的爬取
很多网页的信息都是通过异步加载的,本文就举例讨论下此类网页的抓取. <工作细胞>最近比较火,bilibili 上目前的短评已经有17000多条. 先看分析下页面 右边 li 标签中的就是短 ...
- Python爬虫教程-17-ajax爬取实例(豆瓣电影)
Python爬虫教程-17-ajax爬取实例(豆瓣电影) ajax: 简单的说,就是一段js代码,通过这段代码,可以让页面发送异步的请求,或者向服务器发送一个东西,即和服务器进行交互 对于ajax: ...
- 爬虫——正则表达式爬取豆瓣电影TOP前250的中英文名
正则表达式爬取豆瓣电影TOP前250的中英文名 1.首先要实现网页的数据的爬取.新建test.py文件 test.py 1 import requests 2 3 def get_Html_text( ...
- 【转载】教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神
原文:教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神 本博文将带领你从入门到精通爬虫框架Scrapy,最终具备爬取任何网页的数据的能力.本文以校花网为例进行爬取,校花网:http:/ ...
随机推荐
- MySQL的btree索引和hash索引
Hash 索引结构的特殊性,其检索效率非常高,索引的检索可以一次定位,不像B-Tree 索引需要从根节点到枝节点,最后才能访问到页节点这样多次的IO访问,所以 Hash 索引的查询效率要远高于 B-T ...
- 设计模式在Spring
设计模式在spring中的使用1.工厂模式,这个很明显,在各种BeanFactory以及ApplicationContext创建中都用到了:2.模版模式,这个也很明显,在各种BeanFactory以及 ...
- centos6 hadoop2.7.3分布式搭建
一.hadoop下载 apache所有的project都有自己的域名,可以通过apache官网下的project list去找,也可以直接定位project.apache.org,比如hadoop直接 ...
- 一些实用的浏览器meta
标签: 兼容性 meta 通用 <!--声明文档使用的字符编码--> <meta charset='utf-8′> <!--viewport定义--> <me ...
- css3 走马灯效果
纯css3实现了一个正六边形的走马灯效果,记录一下css3动画的学习情况,效果如下: 主要用到的css3技术有:keyframes.perspective.perspective-origin.tra ...
- Window10 Bug记录
1.两台新电脑刚安装: 妹子的电脑JDK配置后,重启后环境变量配置丢失,cmd里能输出,但eclipse启动不了,重新配置后正常. 我的电脑JDK配置,重启后环境变量在,但好像没加载,cmd输出与ec ...
- eclipse svn 环境搭建
subversion 1.8.14(r1692801) eclipse 安装插件 1.10.x版本
- 《ArcGIS Runtime SDK for Android开发笔记》——(2)、Android Studio基本配置与使用
1.前言 在上一篇文章<Android Studio下载与安装>里我们已经介绍了Android Studio的下载与安装步骤,这一篇我们将针对Android Studio的基本常见使用做一 ...
- rrdtool
参考 http://oss.oetiker.ch/rrdtool/doc https://calomel.org/rrdtool.html http://www.cnblogs.com/lightid ...
- [转]Windows 下常用盗版软件的替代免费软件列表
当您看完这篇文章,我相信您完全可以把您 Windows 系统里安装的盗版软件清理干净而不影响您的任何工作.如果您仍然希望并且喜欢.享受做一个盗版软件用户的话,那也没有办法,但是请您记住,非常非常重要的 ...