
MySQL之谓词下推
MySQL之谓词下推
什么是谓词
在SQL中,谓词就是返回boolean值即true或者false的函数,或是隐式转换为boolean的函数。SQL中的谓词主要有 LKIE、BETWEEN、IS NULL、IS NOT NULL、IN、EXISTS
谓词下推的基本思想即:
将过滤表达式尽可能移动至靠近数据源的位置,以使真正执行时能直接跳过无关的数据。
传统数据库中的谓词下推:
在传统数据库的查询系统中谓词下推作为优化手段很早就出现了,谓词下推的目的就是通过将一些过滤条件尽可能的在最底层执行可以减少每一层交互的数据量,从而提升性能。例如下面这个例子:
select count(1) from A Join B on A.id = B.id where A.a > 10 and B.b < 100;
在处理Join操作之前需要首先对A和B执行TableScan操作,然后再进行Join,再执行过滤,最后计算聚合函数返回,但是如果把过滤条件A.a > 10和B.b < 100分别移到A表的TableScan和B表的TableScan的时候执行,可以大大降低Join操作的输入数据。优化后的语句如下:
select count(1) from (select * from A where a>10)A1 Join (select * from B where b<100)B1 on A1.id = B1.id;
无论是行式存储还是列式存储,都可以在将过滤条件在读取一条记录之后执行以判断该记录是否需要返回给调用者,在Parquet做了更进一步的优化,优化的方法时对每一个Row Group的每一个Column Chunk在存储的时候都计算对应的统计信息,包括该Column Chunk的最大值、最小值和空值个数。通过这些统计值和该列的过滤条件可以判断该Row Group是否需要扫描。另外Parquet未来还会增加诸如Bloom Filter和Index等优化数据,更加有效的完成谓词下推。
在使用Parquet的时候可以通过如下两种策略提升查询性能:
1、类似于关系数据库的主键,对需要频繁过滤的列设置为有序的,这样在导入数据的时候会根据该列的顺序存储数据,这样可以最大化的利用最大值、最小值实现谓词下推。
2、减小行组大小和页大小,这样增加跳过整个行组的可能性,但是此时需要权衡由于压缩和编码效率下降带来的I/O负载。
列式存储中的谓词下推思想
RF算法中,用了谓词下推思想。大小表进行broadcast hash join时,用小表的join列数据构建BloomFilter,广播到大表的所有partition,使用该BloomFilter对大表join列数据进行过滤。最后将大表过滤后得到的数据与小表数据进行hashJoin。
这个过程如下图:
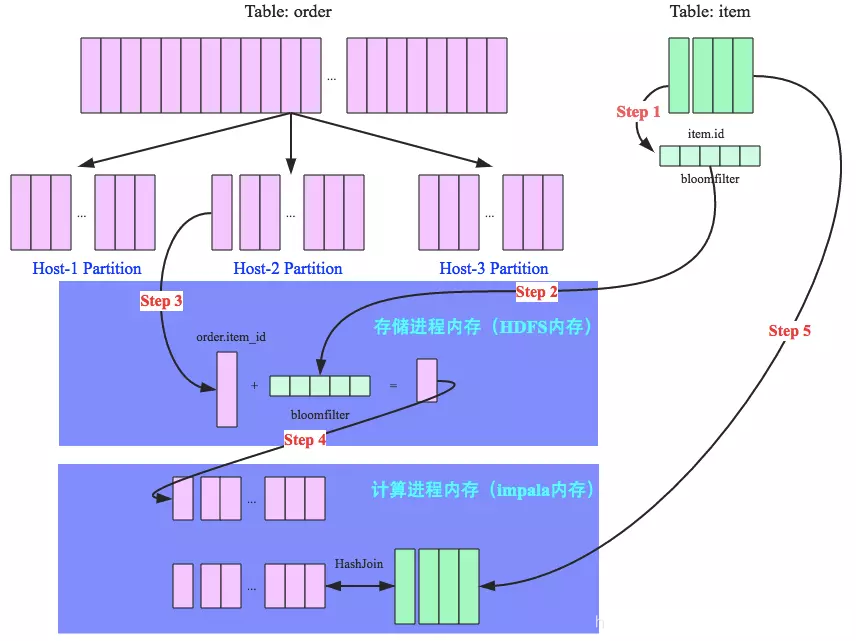
这样的好处是:
- 在存储层即过滤了大量大表无效数据,减少扫描无效数据列的同行其他列数据IO
- 减少存储进程到计算进程传输的数据
- 减少hashjoin开销
如这个SQL:
select item.name, order.* from order , item where order.item_id = item.id and item.category = ‘book’
使用谓词下推,会将表达式 item.category = ‘book’下推到join条件order.item_id = item.id之前。再往高大上的方面说,就是将过滤表达式下推到存储层直接过滤数据,减少传输到计算层的数据量。
HIVE中的谓词下推(下推规则同样适用于SparkSQL)
Hive中的Predicate Pushdown简称谓词下推,简而言之,就是在不影响结果的情况下,尽量将过滤条件提前执行。谓词下推后,过滤条件在map端执行,减少了map端的输出,降低了数据在集群上传输的量,节约了集群的资源,也提升了任务的性能。
具体配置项是hive.optimize.ppd,默认为true,即开启谓词下推
PPD规则:
规则的逻辑描述如下:
- During Join predicates cannot be pushed past Preserved Row tables.
join条件过滤不能下推到保留行表中。
比如以下选择,left join中左表s1为保留行表,所以on条件(join过滤条件)不能下推到s1中
select s1.key, s2.key from src s1 left join src s2 on s1.key > '2';
而s2表不是保留行,所以s2.key>2条件可以下推到s2表中:
select s1.key, s2.key from src s1 left join src s2 on s2.key > '2';
- After Join predicates cannot be pushed past Null Supplying tables.
where条件过滤不能下推到NULL补充表。
比如以下选择left join的右表s2为NULL补充表所以,s1.key>2 where条件可以下推到s1:
select s1.key, s2.key from src s1 left join src s2 where s1.key > '2';
而以下选择由于s2未NULL补充表所以s2.key>2过滤条件不能下推
select s1.key, s2.key from src s1 left join src s2 where s2.key > '2';
关于join和where采用ppd的规则如下:
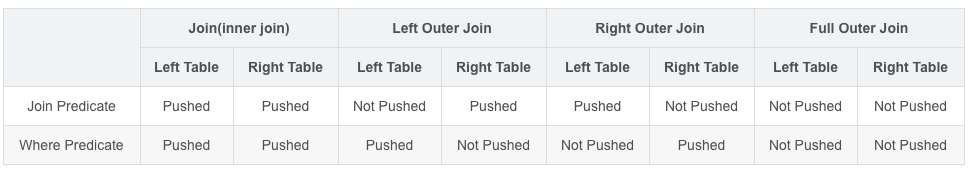
1、对于Join(Inner Join)、Full outer Join,条件写在on后面,还是where后面,性能上面没有区别;
2、对于Left outer Join ,右侧的表写在on后面、左侧的表写在where后面,性能上有提高;
3、对于Right outer Join,左侧的表写在on后面、右侧的表写在where后面,性能上有提高;
4、所谓下推,即谓词过滤在map端执行;所谓不下推,即谓词过滤在reduce端执行
注意:如果在表达式中含有不确定函数,整个表达式的谓词将不会被pushed,例如
select a.* from a join b on a.id = b.idwhere a.ds = '2019-10-09' and a.create_time = unix_timestamp();
因为unix_timestamp是不确定函数,在编译的时候无法得知,所以,整个表达式不会被pushed,即ds='2019-10-09'也不会被提前过滤。类似的不确定函数还有rand()等。
MySQL之谓词下推的更多相关文章
- Spark之谓词下推
谓词下推就是指将各个条件先应用到对应的数据上,而不是根据写入的顺序执行,这样就可以先过滤掉部分数据,降低join等一系列操作的数据量级,提高运算速度,如下图:
- BigData – Join中竟然也有谓词下推!?
本文由 网易云发布. 在之前的文章中简要介绍了Join在大数据领域中的使用背景以及常用的几种算法-broadcast hash join .shuffle hash join以及 sort merg ...
- Hive优化之谓词下推
Hive优化之谓词下推 解释 Hive谓词下推(Predicate pushdown) 关系型数据库借鉴而来,关系型数据中谓词下推到外部数据库用以减少数据传输 基本思想:尽可能早的处理表达式 属于逻辑 ...
- 【大数据】SparkSql 连接查询中的谓词下推处理 (二)
本文首发于 vivo互联网技术 微信公众号 https://mp.weixin.qq.com/s/II48YxGfoursKVvdAXYbVg作者:李勇 目录:1.左表 join 后条件下推2.左表j ...
- 【大数据】SparkSql 连接查询中的谓词下推处理 (一)
本文首发于 vivo互联网技术 微信公众号 https://mp.weixin.qq.com/s/YPN85WBNcnhk8xKjTPTa2g 作者:李勇 目录: 1.SparkSql 2.连接查询和 ...
- 大数据SQL中的Join谓词下推,真的那么难懂?
听到谓词下推这个词,是不是觉得很高大上,找点资料看了半天才能搞懂概念和思想,借这个机会好好学习一下吧. 引用范欣欣大佬的博客中写道,以前经常满大街听到谓词下推,然而对谓词下推却总感觉懵懵懂懂,并不明白 ...
- Mysql中谓词使用date_format的优化
优化前: SELECT a.* FROM t1 a, (SELECT obj_id,MAX(PRE_DETAIL_INST_ID) PRE_DETAIL_INST_ID FROM t1 WHERE D ...
- spark教程(19)-sparkSQL 性能优化之谓词下推
在 sql 语言中,where 表示的是过滤,这部分语句被 sql 层解析后,在数据库内部以谓词的形式出现: 在 sparkSQL 中,如果出现 where,它会现在数据库层面进行过滤,一般数据库会有 ...
- MySQL调优之索引优化
一.索引基本知识 1.索引的优点 1.减少了服务器需要扫描的数据量 2.帮助服务器避免排序和临时表 例子: select * from emp orde by sal desc; 那么执行顺序: 所以 ...
随机推荐
- Excel-RANK函数排名与拓展
问题场景 需求不同根据总分出排名(从大到小100分.100分.99分.98分.97分),排名需求: 第一种排名:第1名,第2名,第3名,第4名,第5名: 第二种排名:第1名,第1名,第3名,第4名,第 ...
- HBase内存配置及JVM优化
前言 本文从HBase的内存布局说起,先充分了解HBase的内存区的使用与分配,随后给出了不同业务场景下的读写内存分配规划,并指导如何分析业务的内存使用情况,以及在使用当中写内存Memstore及读内 ...
- 当layui与分页相遇--bootstrap何去何从
用了一段时间,感觉layui比bootstrap 方便了很多.在js操作上比bootstrap减少了许多的代码量. 今天遇到需要前台分页.当然,不是表格,如果是表格的话.使用yalui table和b ...
- Java学习日报8.5
package student;import java.util.*;public class student { Scanner sc=new Scanner(System.in); private ...
- 重入锁ReentrantLock
- jit编译原理
jit用以把程序全部或部分翻译成本地机器码,当需要装载某个类[通常是创建第一个对象时],编译器会先找到其.class文件,然后将该类的字节码装入内存. hotspot采用惰性评估法: 如果一段代码频繁 ...
- Spring Boot的自动配置
Spring Boot的自动配置 --摘自https://www.hollischuang.com/archives/1791 随着Ruby.Groovy等动态语言的流行,相比较之下Java的开发显得 ...
- Liunx运维(八)-LIunx磁盘与文件系统管理命令
文档目录: 一.fdisk:磁盘分区工具 二.partprobe:更新内核的硬盘分区表信息 三.tune2fs:调整ext2/ext3/ext4文件系统参数 四.parted:磁盘分区工具 五.mkf ...
- [简单-剑指 Offer 53 - II. 0~n-1中缺失的数字]
[简单-剑指 Offer 53 - II. 0-n-1中缺失的数字] 一个长度为n-1的递增排序数组中的所有数字都是唯一的,并且每个数字都在范围0-n-1之内.在范围0-n-1内的n个数字中有且只有一 ...
- 【递归】P5461赦免战俘
题目相关 原题链接:P5461 赦免战俘 - 洛谷 | 计算机科学教育新生态 (luogu.com.cn) 题目背景 借助反作弊系统,一些在月赛有抄袭作弊行为的选手被抓出来了! 题目描述 现有 \(2 ...