
爬虫实例学习——爬取酷狗TOP500数据
酷狗网址:https://www.kugou.com/yy/rank/home/1-8888.html?from=rank
环境:eclipse+pydev
 import requests

 from bs4 import BeautifulSoup

 import time

 headers ={

     'User-Agent':'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/69.0.3497.100 Safari/537.36 QIHU 360EE'

           }    #加入请求头,伪装成浏览器,以便更好抓取数据

 def get_info(url):           #定义获取信息的函数

     wb_data = requests.get(url,headers = headers)

     soup = BeautifulSoup(wb_data.text,'lxml')

     ranks = soup.select('span.pc_temp_num')                     #selet()方法见下面图示

     titles = soup.select('#rankWrap > div.pc_temp_songlist > ul > li > a')

     times = soup.select('span.pc_temp_tips_r > span')

     for rank,title,time in zip(ranks,titles,times):

         data = {

             'rank':rank.get_text().strip(),                #歌曲序号

             'singer':title.get_text().split('-')[0],       #歌手名称

             'song':title.get_text().split('-')[1],         #歌曲名称

             'time':time.get_text().strip()                 #歌曲时长

         }

         print (data)

 if __name__ == '__main__':                #程序主入口

     urls = ['https://www.kugou.com/yy/rank/home/{}-8888.html?from=rank'.format(str(i)) for i in range(1,24)]            #构建多页url,500条结果需23组,每页网页22条

     for url in urls:

         get_info(url)

         time.sleep(1)            #暂停程序,避免因提交网页请求频率过快而导致程序异常终止
请求头获取方式:打开chrome浏览器,输入chrome://version,添加时加上‘User-Agent’:即可(获得信息应置于' '中)。
select()使用方法:该方法类似于中国>广东省>惠州市,从大到小,提取信息,可通过chrome复制得到,如图示:


注意:将li:nth-of-child(1)改为li
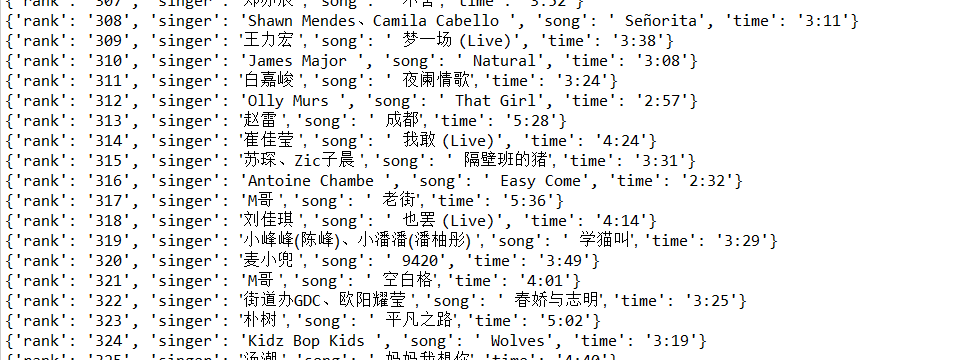
运行结果:
爬虫实例学习——爬取酷狗TOP500数据的更多相关文章
- 【Python】【爬虫】爬取酷狗TOP500
好啦好啦,那我们来拉开我们的爬虫之旅吧~~~ 这一只小爬虫是爬取酷狗TOP500的,使用的爬取手法简单粗暴,目的是帮大家初步窥探爬虫长啥样,后期会慢慢变得健壮起来的. 环境配置 在此之前需要下载一个谷 ...
- 使用Xpath爬取酷狗TOP500的歌曲信息
使用xpath爬取酷狗TOP500的歌曲信息, 将排名.歌手名.歌曲名.歌曲时长,提取的结果以文件形式保存下来.参考网址:http://www.kugou.com/yy/rank/home/1-888 ...
- 【Python】【爬虫】爬取酷狗音乐网络红歌榜
原理:我的上篇博客 import requests import time from bs4 import BeautifulSoup def get_html(url): ''' 获得 HTML ' ...
- Java爬虫系列之实战:爬取酷狗音乐网 TOP500 的歌曲(附源码)
在前面分享的两篇随笔中分别介绍了HttpClient和Jsoup以及简单的代码案例: Java爬虫系列二:使用HttpClient抓取页面HTML Java爬虫系列三:使用Jsoup解析HTML 今天 ...
- python使用beautifulsoup4爬取酷狗音乐
声明:本文仅为技术交流,请勿用于它处. 小编经常在网上听一些音乐但是有一些网站好多音乐都是付费下载的正好我会点爬虫技术,空闲时间写了一份,截止4月底没有问题的,会下载到当前目录,只要按照bs4库就好, ...
- Python爬取酷狗飙升榜前十首(100)首,写入CSV文件
酷狗飙升榜,写入CSV文件 爬取酷狗音乐飙升榜的前十首歌名.歌手.时间,是一个很好的爬取网页内容的例子,对爬虫不熟悉的读者可以根据这个例子熟悉爬虫是如何爬取网页内容的. 需要用到的库:requests ...
- python爬取酷狗音乐排行榜
本文为大家分享了python爬取酷狗音乐排行榜的具体代码,供大家参考,具体内容如下
- python爬虫项目-爬取雪球网金融数据(关注、持续更新)
(一)python金融数据爬虫项目 爬取目标:雪球网(起始url:https://xueqiu.com/hq#exchange=CN&firstName=1&secondName=1_ ...
- 初识python 之 爬虫:爬取中国天气网数据
用到模块: 获取网页并解析:import requests,html5lib from bs4 import BeautifulSoup 使用pyecharts的Bar可视化工具"绘制图表& ...
随机推荐
- Jmeter -- 对并发认识的误区
1. 误区 如下图所示,并发数设置为1000,启动时间设置1s,就是每秒发起1000个请求(错误) 上述的设置,表示在1s内启动1000个线程,之后,jmeter便以最大限度的1000个并发进行压测, ...
- [题解] [SCOI2010] 生成字符串
题面 题解 考虑到直接求合法方案不好求, 我们转化为用总方案减去不合法方案 总方案就是\(\binom{n+m}{m}\), 即在\(n+m\)个位置中放\(n\)个数 我们将初始的空序列看做\((0 ...
- java判断一个字符串是否为数字型
摘自:https://blog.csdn.net/qq_42133100/article/details/92158507 方法一:用JAVA自带的函数(只能判断正整数 ) 2 public stat ...
- Android jni/ndk编程四:jni引用类型
一.JNI引用类型 JNI支持三种类型的 opaque reference:local references, global references,和weak global references,下面 ...
- is幻梦 Linux命令之文件和目录操作命令(二)——查看文件内容cat、more、less、tail、head
一.cat命令 用法:cat [选项][文件] 1.主要用来查看文件内容 2.-n 在文件内容的每一行上加上行号 3.再不加任何选项和文件名的时候,将标准输入的内容复制到标准输出 这个时候一般用于重定 ...
- 配置Log4j 详解
Log4J的配置文件(Configuration File)就是用来设置记录器的级别.存放器和布局的,它可接key=value格式的设置或xml格式的设置信息.通过配置,可以创建出Log4J的运行环境 ...
- Windows下Java JDK环境变量的配置
注意:前提是你已经在电脑上安装了JDK 1.打开控制面板—系统和安全—系统,选择高级系统设置 2.选择环境变量 3. 然后看看用户变量中有没有JAVA_HOME和CLASSPATH变量 4.新建JAV ...
- flutter 打包
iOS打包 iOS打包需要注意一下一些设置 info.plist 设置ATS.白名单.字符串等等 Assets.xcassets 替换icon,替换LaunchImage中内容 注意LaunchIma ...
- springboot子模块 @Autowired无法找到其他模块的接口和类的解决方法
在main的启动类上添加 @SpringBootApplication(scanBasePackages = {"com.shangsheng"})或者@ComponentScan ...
- cpu切换线程上下文会耗费多少时间
cpu切换线程上下文会耗费多少时间,有人在linux下面使用不同的cpu测试过,需要1000ns以上的时间 https://blog.tsunanet.net/2010/11/how-long-doe ...