
【Python】【爬虫】爬取酷狗音乐网络红歌榜
原理:我的上篇博客
import requests

import time

from bs4 import BeautifulSoup

def get_html(url):

    '''

    获得 HTML

    '''

    headers = {

        'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/53\

        7.36 (KHTML, like Gecko) Chrome/75.0.3770.142 Safari/537.36'

    }

    response = requests.get(url, headers=headers)

    if response.status_code == 200:

        return response.text

    else:

        return

def get_infos(html):

    '''

    提取数据

    '''

    html = BeautifulSoup(html)

    # 排名#

    ranks = html.select('#rankWrap > div.pc_temp_songlist > ul > li > span.pc_temp_num')

    # 歌手 + 歌名

    names = html.select('#rankWrap > div.pc_temp_songlist > ul > li > a')

    # 播放时间

    times = html.select('#rankWrap > div.pc_temp_songlist > ul > li > span.pc_temp_tips_r > span')

    # 打印信息

    for r,n,t in zip(ranks,names,times):

        r = r.get_text().replace('\n','').replace('\t','').replace('\r','')

        n = n.get_text()

        t = t.get_text().replace('\n','').replace('\t','').replace('\r','')

        data = {

            '排名': r,

            '歌名-歌手': n,

            '播放时间': t

        }

        print(data)

def main():

    '''

    主接口

    '''

    urls = ['https://www.kugou.com/yy/rank/home/{}-23784.html?from=rank'

                .format(str(i)) for i in range(1, 6)]

    for url in urls:

        html = get_html(url)

        get_infos(html)

        time.sleep(1)

if __name__ == '__main__':

    main()
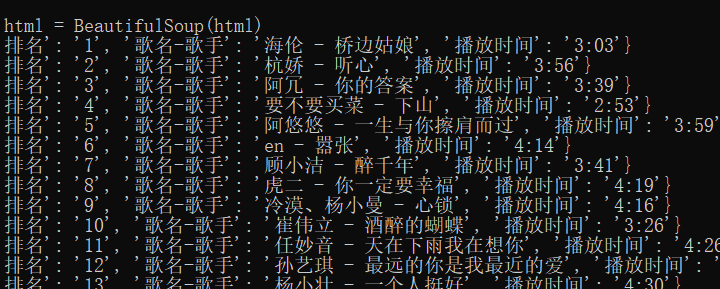
结果:
【Python】【爬虫】爬取酷狗音乐网络红歌榜的更多相关文章
- Java爬虫系列之实战:爬取酷狗音乐网 TOP500 的歌曲(附源码)
在前面分享的两篇随笔中分别介绍了HttpClient和Jsoup以及简单的代码案例: Java爬虫系列二:使用HttpClient抓取页面HTML Java爬虫系列三:使用Jsoup解析HTML 今天 ...
- python爬取酷狗音乐排行榜
本文为大家分享了python爬取酷狗音乐排行榜的具体代码,供大家参考,具体内容如下
- python使用beautifulsoup4爬取酷狗音乐
声明:本文仅为技术交流,请勿用于它处. 小编经常在网上听一些音乐但是有一些网站好多音乐都是付费下载的正好我会点爬虫技术,空闲时间写了一份,截止4月底没有问题的,会下载到当前目录,只要按照bs4库就好, ...
- python爬取酷狗音乐
url:https://www.kugou.com/yy/html/rank.html 我们随便访问一个歌曲可以看到url有个hash https://www.kugou.com/song/#hash ...
- 使用scrapy 爬取酷狗音乐歌手及歌曲名并存入mongodb中
备注还没来得及写,共爬取八千多的歌手,每名歌手平均三十首歌曲算,大概二十多万首歌曲 run.py #!/usr/bin/env python # -*- coding: utf-8 -*- __aut ...
- Python实例---爬去酷狗音乐
项目一:获取酷狗TOP 100 http://www.kugou.com/yy/rank/home/1-8888.html 排名 文件&&歌手 时长 效果: 附源码: import t ...
- python爬虫---爬取网易云音乐
代码: import requests from lxml import etree text = requests.get("https://music.163.com/discover/ ...
- 【Python】【爬虫】爬取酷狗TOP500
好啦好啦,那我们来拉开我们的爬虫之旅吧~~~ 这一只小爬虫是爬取酷狗TOP500的,使用的爬取手法简单粗暴,目的是帮大家初步窥探爬虫长啥样,后期会慢慢变得健壮起来的. 环境配置 在此之前需要下载一个谷 ...
- Python爬取酷狗飙升榜前十首(100)首,写入CSV文件
酷狗飙升榜,写入CSV文件 爬取酷狗音乐飙升榜的前十首歌名.歌手.时间,是一个很好的爬取网页内容的例子,对爬虫不熟悉的读者可以根据这个例子熟悉爬虫是如何爬取网页内容的. 需要用到的库:requests ...
随机推荐
- win10配置jdk环境变量
备注:这里以jdk-10.0.2_windows-x64_bin为例 1.jdk安装目录如下 2.右键“此电脑”-点击“属性”-点击“高级系统设置”-点击“环境变量”-选中“Path”-点击“编辑” ...
- PAT (Advanced Level) Practice 1011 World Cup Betting (20 分) (找最值)
With the 2010 FIFA World Cup running, football fans the world over were becoming increasingly excite ...
- 树hash/树哈希 刷题记录
不同hash姿势: 树的括号序列最小表示法 s[i] 如果i为叶子节点:() 如果i的子节点为j1~jn:(s[j1]...s[jn]),注意s[j]要按照字典序排列
- C# 索引器的理解和使用
概述 此部分内容引用自MSDN文档 使用索引器可以用类似于数组的方式为对象建立索引. get 取值函数返回值. set 取值函数分配值. this 关键字用于定义索引器. value 关键字用于定义 ...
- int long的数据范围
java 整数型 byte 1字节 -128~127 -2^7~2^7-1 short 2字节 -32768~32767 int 4个字节 -2147483648~2147483647 -2 ...
- yii2 生成随机字符串
uuid uuid use Faker\Provider\Uuid; Uuid::uuid(); yii自带 生成32位字符串 Yii::$app->getSecurity()->gene ...
- Chrome浏览器控制台报Refused to get unsafe header "XXX"的错误
最近在调试后端下载的接口时在浏览器的控制台中发现了红色的错误信息,例如Refused to get unsafe header "XXX":前端是采用XMLHttpRequest对 ...
- Educational Codeforces Round 81 (Rated for Div. 2) 题解
过了n天补的题解:D AB就不用说了 C. Obtain The String 思路挺简单的,就是贪心,但是直接贪心的复杂度是O(|s|*|t|),会超时,所以需要用到序列自动机 虽然名字很高端但是就 ...
- linux中Jenkins启动/重启/停止命令
简要记录一下Linux 中Jenkins启动/重启/停止命令 启动service jenkins start1重启service jenkins restart1停止service jenkins s ...
- JS高级---案例:验证用户输入的是不是邮箱
案例:验证用户输入的是不是邮箱 <!DOCTYPE html> <html lang="en"> <head> <meta charset ...