
爬了招聘网站之后,总结Python学习的几点建议
来源商业新知网,原标题::爬了招聘网站之后,给你几点学习Python的建议
Python语言相关的岗位非常多,有运维,有自动化测试,有后端开发,有机器学习,如果想要快速上手,并且有不错的就业,那就推荐数据分析。
用Python爬取了 深圳不同行业数据分析师的招聘需求 ,金融、电子商务、移动互联网这些热门行业对数据分析师的需求仍然很大。

从薪资来看,数据分析师确实是高薪职位,基本上是10k起步,能开30k的公司也不少 ,从数据本身来看,高层管理职位需求也是很多的,数据的价值越来越受到企业高层的重视,这个岗位真香!

从薪资分布区域来看 , 各区平均工资基本在15k-22k之间,市场行情也比较统一,平均工资差距都不会太大。

*箱形图的五条线的含义分别是最大值、最小值、中位数和两个四分位数,可以很方便地读出数据的分散情况
从技能角度来说, 学会了Python即便不专门做数据分析师,对于平时工作也是有非常大的帮助。
用几行代码就能快速整理数据并出图:

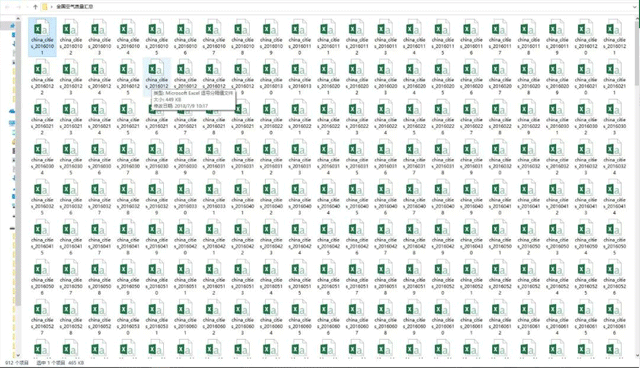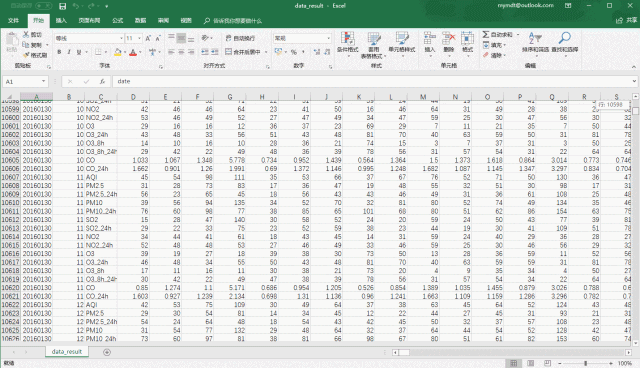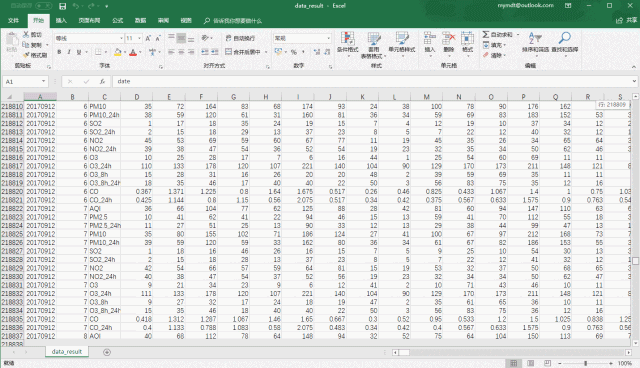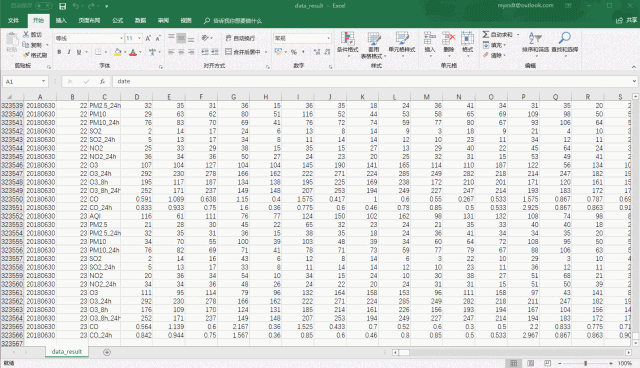
甚至可以编写合成多个Excel表格的Python脚本,一键跳过复制粘贴:
如果想要学习Python,今天给大家送个福利,现在你可以免费加入网易Python数据分析学习交流群,每天免费观看名师2小时的直播! 加入社群后,行业从业疑问,学习遇到的bug,从零开始学Python不知道的坑,都有名师为你解读。同时你将获得以下福利:
29场Python数据分析免费直播课,干货大放送
《数据分析师(Python)》免费体验课
6G Python数据分析免费资料包(含实视频、pdf文档,入门必备文件安装包,练手数据等)
案例代码资料
爬了招聘网站之后,总结Python学习的几点建议的更多相关文章
- Python爬取招聘网站数据,给学习、求职一点参考
1.项目背景 随着科技的飞速发展,数据呈现爆发式的增长,任何人都摆脱不了与数据打交道,社会对于“数据”方面的人才需求也在不断增大.因此了解当下企业究竟需要招聘什么样的人才?需要什么样的技能?不管是对于 ...
- Python爬虫学习之使用beautifulsoup爬取招聘网站信息
菜鸟一只,也是在尝试并学习和摸索爬虫相关知识. 1.首先分析要爬取页面结构.可以看到一列搜索的结果,现在需要得到每一个链接,然后才能爬取对应页面. 关键代码思路如下: html = getHtml(& ...
- python爬取招聘网站数据
# -*- coding: utf-8 -*- # 爬虫分析 from bs4 import BeautifulSoup from lxml import etree from selenium im ...
- scrapy爬虫框架爬取招聘网站
目录结构 BossFace.py文件中代码: # -*- coding: utf-8 -*-import scrapyfrom ..items import BossfaceItemimport js ...
- scrapy爬取招聘网站,items转换成dict遇到的问题
pipelines代码 1 import json 2 3 class TencentJsonPipeline(object): 4 def __init__(self): 5 self.file = ...
- 利用python实现爬虫爬取某招聘网站,北京地区岗位名称包含某关键字的所有岗位平均月薪
#通过输入的关键字,爬取北京地区某岗位的平均月薪 # -*- coding: utf-8 -*- import re import requests import time import lxml.h ...
- Python爬虫某招聘网站的岗位信息
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者:阿尔法游戏 PS:如有需要Python学习资料的小伙伴可以加点击下方链 ...
- Python学习路线【对标大厂Python工程师的招聘要求,并推荐优质免费资源】打卡学习不迷茫
您好,我是码农飞哥,感谢您阅读本文,欢迎一键三连哦. 本文要点:从Python爬虫工程师的招聘要求出发制定学习路线,同时还推荐免费优质的学习资源. 打卡学习不迷茫. 干货满满,建议收藏,需要用到时常看 ...
- python爬虫--爬取某网站电影信息并写入mysql数据库
书接上文,前文最后提到将爬取的电影信息写入数据库,以方便查看,今天就具体实现. 首先还是上代码: # -*- coding:utf-8 -*- import requests import re im ...
随机推荐
- 用anaconda安装tensorflow
conda create -n tensorflow python=2.7 conda activate tensorflow / source activate tensorflow anacond ...
- BT.656
转自http://www.cnblogs.com/s_agapo/archive/2012/04/08/2437775.html 凡是做模拟信号采集的,很少不涉及BT.656标准的,因为常见的模拟视频 ...
- linux kernel mini2440 start.S head-common.S 部分注释
内核版本:2.6.32.2(mini2440光盘源码) github地址:https://github.com/guanglun/mini2440_uboot_linux (for_len分支 htt ...
- xxl-job源码分析
1 调度中心API服务 1.任务结果回调服务: 2.执行器注册服务: 3.执行器注册摘除服务: 4.触发任务单次执行服务,支持任务根据业务事件触发: API暴露代码:com.xxl.job.admin ...
- 去中心化存储项目终极指南 | Filecoin, Storj 和 PPIO 项目异同
Filecoin,Storj 以及 PPIO 这三个存储公链的设计思路是不一样的,没有优劣之分,写这篇文章也并不是为了争论各项目的好坏对错.去中心化存储是一个长期商业赛道,不同团队在同一个赛道上往不同 ...
- Thinkpad 小红点飘移的不完美解决办法
环境:T420 BIOS1.49 windows7 x64 对硬盘执行写入操作,比如说建立一个空白记事本,每次飘移的时候,就alt+tab切到记事本,随便输入一个字符,ctrl+s保存,搞定.
- 记录1-更换mac pro内存,硬盘及恢复系统
我的mac pro是2012年初买的,4G/500G HDD在服役了六年多后速度堪比老牛,以前装的虚拟机压根不敢打开.这几天把内存更换为8G,硬盘升级为samsung的1T SSD,感觉像起死回生一样 ...
- 排错技能:任务管理器中追踪某w3wp.exe是哪个IIS站点的application pool
如果Windows的任务管理器中发现某个w3wp.exe占用了100%CPU,那我们就要揪出这是那个网站的application pool在作怪, 首先,每个站点一定要单独使用各自的applicati ...
- 记录Redis使用中遇到的两个问题(原子性及数据完整性)
1.使用Redis作为分布式锁的原子性问题 原方案: ① SETNX $LOCK_BUSI_KEY $REQ_ID ② EXPIRE $LOCK_BUSI_KEY $LOCK_TIME 问题: 使用S ...
- html弹出div
<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w3.org/ ...