
scrapy爬虫框架爬取招聘网站
目录结构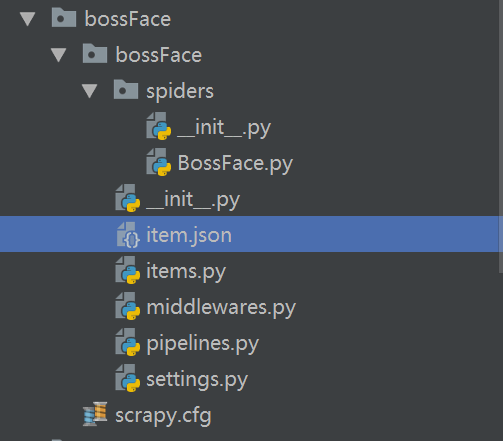
BossFace.py文件中代码:
# -*- coding: utf-8 -*-
import scrapy
from ..items import BossfaceItem
import json
class BossfaceSpider(scrapy.Spider):
    name = 'BossFace'
    allowed_domains = ['www.zhipin.com/c101010100-p100109/?page=2']
    start_urls = ['https://fe-api.zhaopin.com/c/i/sou?start=90&pageSize=90&cityId=天津&salary=0,0&workExperience=-1&education=-1&companyType=-1&employmentType=-1&jobWelfareTag=-1&kw=Python&kt=3&=0&at=081a4411244a4e9c80d393212650f005&rt=6cc8df0863c944a88cbc303fa5d7dd40&_v=0.56963230&userCode=1041847897&x-zp-page-request-id=1dba50fde35b475b99fc09aa009dbee1-1568818384291-188677&x-zp-client-id=412ece5e-7595-4148-8838-3b957ac4202a']
    def parse(self, response):

        item = BossfaceItem()
        rs =  json.loads(response.text)['data']
        res = dict(rs)
        lis = res['results']

        for i in range(0,len(lis)):
            item['workName'] = lis[i]['jobName']
            item['workPay'] = lis[i]['salary']
            item['workPosition'] = lis[i]['city']['display']
            item['degree'] = lis[i]['eduLevel']['name']
            item['Company'] = lis[i]['company']['name']
            yield item

items.py中的代码:
# -*- coding: utf-8 -*-

# Define here the models for your scraped items
#
# See documentation in:
# https://docs.scrapy.org/en/latest/topics/items.html

import scrapy

class BossfaceItem(scrapy.Item):
    # define the fields for your item here like:
    # name = scrapy.Field()
    workName = scrapy.Field()
    workPay = scrapy.Field()
    workPosition = scrapy.Field()
    degree = scrapy.Field()
    Company = scrapy.Field()
    workDetail = scrapy.Field()
    pass
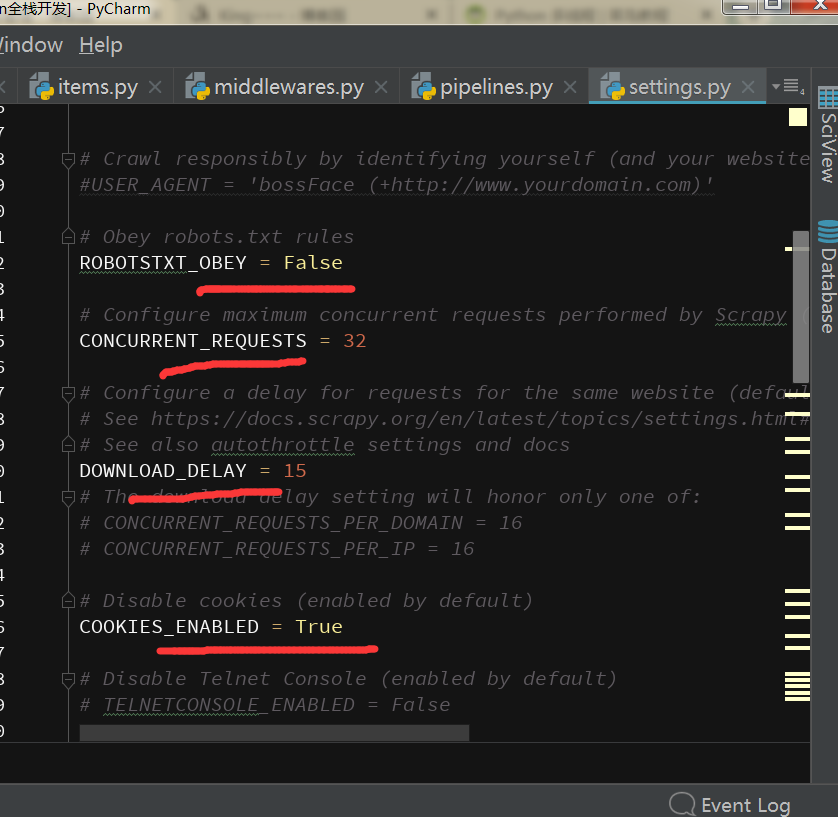
将这些开启,建立延迟,防止服务器封掉ip
在命令行创建的命令依次是:
1.scrapy startproject bossFace
2.scrapy genspider BossFace www.zhipin.com #进入spider中执行
3.scrapy crawl BossFace #进入第二级别的bossFace中执行
4.scrapy crawl BossFace -o item.json #执行目录与3相同
scrapy爬虫框架爬取招聘网站的更多相关文章
- 手把手教大家如何用scrapy爬虫框架爬取王者荣耀官网英雄资料
之前被两个关系很好的朋友拉入了王者荣耀的大坑,奈何技术太差,就想着做一个英雄的随查手册,这样就可以边打边查了.菜归菜,至少得说明咱打王者的态度是没得说的,对吧?大神不喜勿喷!!!感谢!!废话不多说,开 ...
- 初次尝试python爬虫,爬取小说网站的小说。
本次是小阿鹏,第一次通过python爬虫去爬一个小说网站的小说. 下面直接上菜. 1.首先我需要导入相应的包,这里我采用了第三方模块的架包,requests.requests是python实现的简单易 ...
- 初识python 之 爬虫:爬取某网站的壁纸图片
用到的主要知识点:requests.get 获取网页HTMLetree.HTML 使用lxml解析器解析网页xpath 使用xpath获取网页标签信息.图片地址request.urlretrieve ...
- python-scrapy爬虫框架爬取拉勾网招聘信息
本文实例为爬取拉勾网上的python相关的职位信息, 这些信息在职位详情页上, 如职位名, 薪资, 公司名等等. 分析思路 分析查询结果页 在拉勾网搜索框中搜索'python'关键字, 在浏览器地址栏 ...
- Python爬虫学习之使用beautifulsoup爬取招聘网站信息
菜鸟一只,也是在尝试并学习和摸索爬虫相关知识. 1.首先分析要爬取页面结构.可以看到一列搜索的结果,现在需要得到每一个链接,然后才能爬取对应页面. 关键代码思路如下: html = getHtml(& ...
- scrapy入门实战-爬取代理网站
入门scrapy. 学习了有这几点 1.如何使用scrapy框架对网站进行爬虫: 2.如何对网页源代码使用xpath进行解析: 3.如何书写spider爬虫文件,对源代码进行解析: 4.学会使用scr ...
- Scrapy爬虫笔记 - 爬取知乎
cookie是一种本地存储机制,cookie是存储在本地的 session其实就是将用户信息用户名.密码等)加密成一串字符串,返回给浏览器,以后浏览器每次请求都带着这个sessionId 状态码一般是 ...
- 【网络爬虫】【python】网络爬虫(五):scrapy爬虫初探——爬取网页及选择器
在上一篇文章的末尾,我们创建了一个scrapy框架的爬虫项目test,现在来运行下一个简单的爬虫,看看scrapy爬取的过程是怎样的. 一.爬虫类编写(spider.py) from scrapy.s ...
- Scrapy爬虫实战-爬取体彩排列5历史数据
网站地址:http://www.17500.cn/p5/all.php 1.新建爬虫项目 scrapy startproject pfive 2.在spiders目录下新建爬虫 scrapy gens ...
随机推荐
- TStringGrid 实现下拉框
TStringGrid 实现下拉框比较常见的思路是在TSringGrid中嵌入一个TComboBox ,思路虽然简单,但开发起来却很麻烦,而且有时会出现不愿看到的效果.还有一种更巧的方法,是Delph ...
- SCP-bzoj-1000
项目编号:bzoj-1000 项目等级:Keter 项目描述: 鉴于该项目的奇特性质,任何拥有Administrator以下权限者均不予查看项目描述.如有违反,将导致AwD成功突破Site bzoj收 ...
- NOIp2018集训test-9-16(联考二day2)
T1旋转子段 一开始脑袋抽了花了近一个小时写了个跟这题毫无关系的莫名其妙的代码,一急代码就各种bug,最后t1就花了一个半小时多,然后后面时间不太够了,考得稀烂. 因为每个数存在唯一的中心使得绕这个中 ...
- NX二次开发-创建直线UF_CURVE_create_line与NXOpen->CreateLine
NX11+VS2013 #include <uf.h> #include <uf_curve.h> #include <NXOpen/CurveCollection.hx ...
- C/Python/Java环境变量配置
链接 全图预览: Java: 只需添加下面三个环境变量即可使用Java.对照这我的添加就行. CLASSPATH的内容: .;%JAVA_HOME%\lib\dt.jar;%JAVA_HOME%\li ...
- C++之静态(static)
一.静态数据成员与静态成员函数 二.从内存角度看静态数据成员 三.从this指针谈静态成员函数 四.注意事项 五.补充说明 1.<静态>课程评论: 静态成员是类的成员,不是对象的成员: 静 ...
- linux在不关机情况下新增硬盘的方法
开机状态插入硬盘 不关机执行命令 echo "- - -" > /sys/class/scsi_host/host0/scan 注意 echo "- - -&quo ...
- Openstack nova-scheduler 源码分析 — Filters/Weighting
目录 目录 前言 调度器 FilterScheduler调度器的工作流程 Filters 过滤器 Filters 类型 Weighting 权重 源码实现 关键文件及其意义 阶段一nova-sched ...
- JVM内核-原理、诊断与优化学习笔记(三):常用JVM配置参数
文章目录 Trace跟踪参数 -verbose:gc (打开gc的跟踪情况) -XX:+printGC(打开gc的log开关,如果在运行的过程中出现了gc,就会打印出相关的信息.) -XX:+Prin ...
- C不同变量类型存储大小引发的BUG
#include"stdio.h" typedef signed char int8; typedef unsigned char uint8; typedef signed sh ...