
hive学习笔记之八:Sqoop
欢迎访问我的GitHub
https://github.com/zq2599/blog_demos
内容:所有原创文章分类汇总及配套源码,涉及Java、Docker、Kubernetes、DevOPS等;
关于Sqoop
Sqoop是Apache开源项目,用于在Hadoop和关系型数据库之间高效传输大量数据,本文将与您一起实践以下内容:
- 部署Sqoop
- 用Sqoop将hive表数据导出至MySQL
- 用Sqoop将MySQL数据导入到hive表
部署
- 在hadoop账号的家目录下载Sqoop的1.4.7版本:
wget https://mirror.bit.edu.cn/apache/sqoop/1.4.7/sqoop-1.4.7.bin__hadoop-2.6.0.tar.gz
- 解压:
tar -zxvf sqoop-1.4.7.bin__hadoop-2.6.0.tar.gz
- 解压后得到文件夹sqoop-1.4.7.bin__hadoop-2.6.0,将mysql-connector-java-5.1.47.jar复制到sqoop-1.4.7.bin__hadoop-2.6.0/lib目录下
- 进入目录sqoop-1.4.7.bin__hadoop-2.6.0/conf,将sqoop-env-template.sh改名为sqoop-env.sh:
mv sqoop-env-template.sh sqoop-env.sh
- 用编辑器打开sqoop-env.sh,增加下面三个配置,HADOOP_COMMON_HOME和HADOOP_MAPRED_HOME是完整的hadoop路径,HIVE_HOME是完整的hive路径:
export HADOOP_COMMON_HOME=/home/hadoop/hadoop-2.7.7

export HADOOP_MAPRED_HOME=/home/hadoop/hadoop-2.7.7

export HIVE_HOME=/home/hadoop/apache-hive-1.2.2-bin
- 安装和配置完成了,进入sqoop-1.4.7.bin__hadoop-2.6.0/bin,执行./sqoop version查看sqoop版本,如下所示,可见是1.4.7版本(有些环境变量没配置会输出告警,在此先忽略):
[hadoop@node0 bin]$ ./sqoop version

Warning: /home/hadoop/sqoop-1.4.7.bin__hadoop-2.6.0/bin/../../hbase does not exist! HBase imports will fail.

Please set $HBASE_HOME to the root of your HBase installation.

Warning: /home/hadoop/sqoop-1.4.7.bin__hadoop-2.6.0/bin/../../hcatalog does not exist! HCatalog jobs will fail.

Please set $HCAT_HOME to the root of your HCatalog installation.

Warning: /home/hadoop/sqoop-1.4.7.bin__hadoop-2.6.0/bin/../../accumulo does not exist! Accumulo imports will fail.

Please set $ACCUMULO_HOME to the root of your Accumulo installation.

Warning: /home/hadoop/sqoop-1.4.7.bin__hadoop-2.6.0/bin/../../zookeeper does not exist! Accumulo imports will fail.

Please set $ZOOKEEPER_HOME to the root of your Zookeeper installation.

20/11/02 12:02:58 INFO sqoop.Sqoop: Running Sqoop version: 1.4.7

Sqoop 1.4.7

git commit id 2328971411f57f0cb683dfb79d19d4d19d185dd8

Compiled by maugli on Thu Dec 21 15:59:58 STD 2017
- sqoop装好之后,接下来体验其功能
MySQL准备
为了接下来的实战,需要把MySQL准备好,这里给出的MySQL的配置供您参考:
- MySQL版本:5.7.29
- MySQL服务器IP:192.168.50.43
- MySQL服务端口:3306
- 账号:root
- 密码:123456
- 数据库名:sqoop
关于MySQL部署,我这为了省事儿,是用docker部署的,参考《群晖DS218+部署mysql》
从hive导入MySQL(export)
- 执行以下命令,将hive的数据导入到MySQL:
./sqoop export \

--connect jdbc:mysql://192.168.50.43:3306/sqoop \

--table address \

--username root \

--password 123456 \

--export-dir '/user/hive/warehouse/address' \

--fields-terminated-by ','
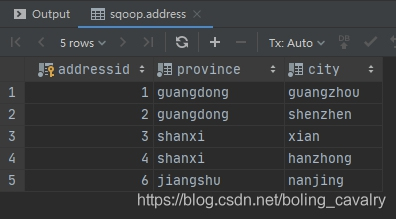
- 查看address表,数据已经导入:
从MySQL导入hive(import)
- 在hive的命令行模式执行以下语句,新建名为address2的表结构和address一模一样:
create table address2 (addressid int, province string, city string)

row format delimited

fields terminated by ',';
- 执行以下命令,将MySQL的address表的数据导入到hive的address2表,-m 2表示启动2个map任务:
./sqoop import \

--connect jdbc:mysql://192.168.50.43:3306/sqoop \

--table address \

--username root \

--password 123456 \

--target-dir '/user/hive/warehouse/address2' \

-m 2
- 执行完毕后,控制台输入类似以下内容:
		Virtual memory (bytes) snapshot=4169867264

		Total committed heap usage (bytes)=121765888

	File Input Format Counters

		Bytes Read=0

	File Output Format Counters

		Bytes Written=94

20/11/02 16:09:22 INFO mapreduce.ImportJobBase: Transferred 94 bytes in 16.8683 seconds (5.5726 bytes/sec)

20/11/02 16:09:22 INFO mapreduce.ImportJobBase: Retrieved 5 records.
- 去查看hive的address2表,可见数据已经成功导入:
hive> select * from address2;

OK

1	guangdong	guangzhou

2	guangdong	shenzhen

3	shanxi	xian

4	shanxi	hanzhong

6	jiangshu	nanjing

Time taken: 0.049 seconds, Fetched: 5 row(s)
- 至此,Sqoop工具的部署和基本操作已经体验完成,希望您在执行数据导入导出操作时,此文能给您一些参考;
你不孤单,欣宸原创一路相伴
欢迎关注公众号:程序员欣宸
微信搜索「程序员欣宸」,我是欣宸,期待与您一同畅游Java世界...
https://github.com/zq2599/blog_demos
hive学习笔记之八:Sqoop的更多相关文章
- hive学习笔记之一:基本数据类型
欢迎访问我的GitHub https://github.com/zq2599/blog_demos 内容:所有原创文章分类汇总及配套源码,涉及Java.Docker.Kubernetes.DevOPS ...
- hive学习笔记之三:内部表和外部表
欢迎访问我的GitHub https://github.com/zq2599/blog_demos 内容:所有原创文章分类汇总及配套源码,涉及Java.Docker.Kubernetes.DevOPS ...
- hive学习笔记之四:分区表
欢迎访问我的GitHub https://github.com/zq2599/blog_demos 内容:所有原创文章分类汇总及配套源码,涉及Java.Docker.Kubernetes.DevOPS ...
- hive学习笔记之五:分桶
欢迎访问我的GitHub https://github.com/zq2599/blog_demos 内容:所有原创文章分类汇总及配套源码,涉及Java.Docker.Kubernetes.DevOPS ...
- hive学习笔记之六:HiveQL基础
欢迎访问我的GitHub https://github.com/zq2599/blog_demos 内容:所有原创文章分类汇总及配套源码,涉及Java.Docker.Kubernetes.DevOPS ...
- hive学习笔记之七:内置函数
欢迎访问我的GitHub https://github.com/zq2599/blog_demos 内容:所有原创文章分类汇总及配套源码,涉及Java.Docker.Kubernetes.DevOPS ...
- hive学习笔记之九:基础UDF
欢迎访问我的GitHub https://github.com/zq2599/blog_demos 内容:所有原创文章分类汇总及配套源码,涉及Java.Docker.Kubernetes.DevOPS ...
- hive学习笔记之十:用户自定义聚合函数(UDAF)
欢迎访问我的GitHub 这里分类和汇总了欣宸的全部原创(含配套源码):https://github.com/zq2599/blog_demos 本篇概览 本文是<hive学习笔记>的第十 ...
- hive学习笔记之十一:UDTF
欢迎访问我的GitHub https://github.com/zq2599/blog_demos 内容:所有原创文章分类汇总及配套源码,涉及Java.Docker.Kubernetes.DevOPS ...
随机推荐
- $(cd "$(dirname "$0")",pwd) 解析
xx.sh 文件内容如下: #!/bin/bash BIN_FOLDER=$(cd "$(dirname "$0")";pwd) echo $BIN_FOLDE ...
- numpy tile()函数
tile(A,B)即在B的方向上,重复A 直接举栗子: A=[1,2] tile(A,2) 此时B=(2) ,B的方向仅包含列方向,将A在列方向上重复一次,得出结果如图1所示 图1-将A在列方向重 ...
- 文件包含之包含了Linux文件描述符
0x00 原理 文件描述符是内核为了高效管理已被打开的文件所创建的索引,用于指向被打开的文件,所有执行I/O操作的系统调用都通过文件描述符. 翻译成人话- 可以认为是指向文件的一个指针,如果有文件 ...
- kylin优化的思想
kylin的核心优势在于使用额外的空间存储预计算的结果,以换取查询时间的缩减. 所以我们要对额外的空间进行优化,并且在空间优化之后,cuboid无法完全命中时,对查询时间进行优化. 空间优化的思路就是 ...
- Springboot2.x入门——helloWorld
Springboot2.x入门--helloWorld 一.简介 1.1 Springboot简介 Spring Boot是由Pivotal团队提供的全新框架,其设计目的是用来简化新Spring应用的 ...
- 如何正确地使用RecyclerView.ListAdapter
默认是在一个fragment中实现RecyclerView. private inner class CrimeAdapter() : ListAdapter<Crime, CrimeHolde ...
- 西门子S7200/300/400以太网通讯处理器选型分类
北京华科远创科技有限研发的远创智控转以太网模块适用于西门子S7-200/S7-300/S7-400.SMART S7-200.西门子数控840D.840DSL.合信.亿维PLC的PPI/MPI/PRO ...
- Java并发之AQS原理剖析
概述: AbstractQueuedSynchronizer,可以称为抽象队列同步器. AQS有独占模式和共享模式两种: 独占模式: 公平锁: 非公平锁: 共享模式: 数据结构: 基本属性: /** ...
- Pandas之:Pandas简洁教程
Pandas之:Pandas简洁教程 目录 简介 对象创建 查看数据 选择数据 loc和iloc 布尔索引 处理缺失数据 合并 分组 简介 pandas是建立在Python编程语言之上的一种快速,强大 ...
- Docker删除某个容器时失败解决方案
删除某个容器时,报错 ocker rm 容器id image is being used by stopped container e11efb30362a 该报错的原因是要删除的该镜像,被某 ...