
pycharm爬取网页数据
1 python环境的配置
1.1 安装python文件包,放到可以找到的位置
1.2 右键计算机->属性->高级环境设置->系统变量->Path->编辑->复制python路径位置
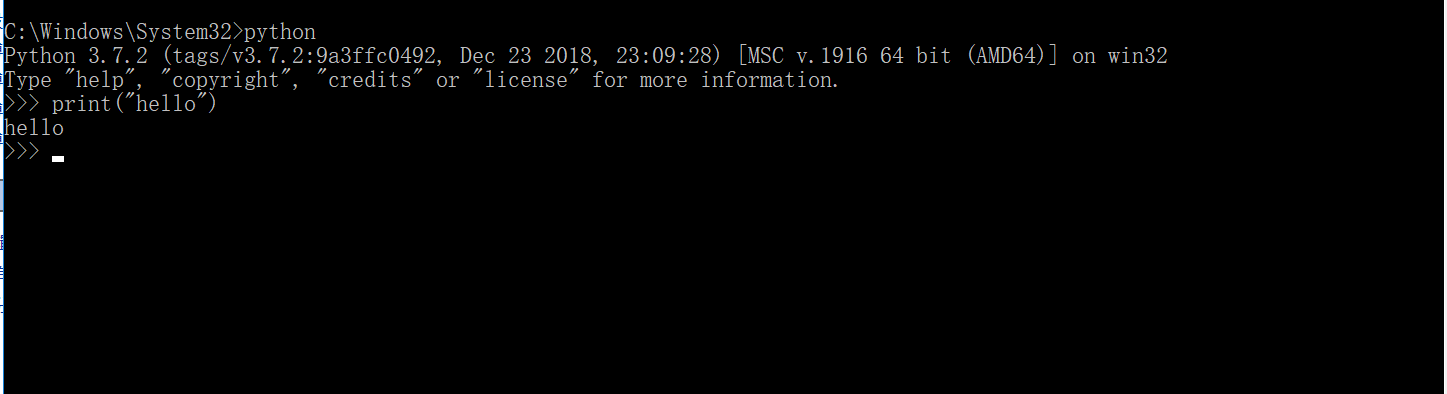
1.3 管理员身份打开cmd,输入python,测试环境是否安装成功
2 安装pycharm
2.1 安装pycharm文件包,放到可以找到的位置
2.2 新建文件夹,需要设置环境
2.3 File->Setting->project ...->add->找到python.exe
2.4 爬虫需要的安装包
2.4.1 打开cmd(管理员身份)
2.4.2 python -m pip install requests
2.4.3 python -m pip install lxml
2.4.4 python -m pip install bs4
2.5爬取数据
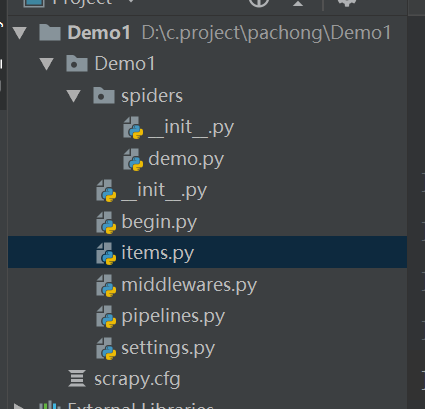
2.5.1 打开cmd 输入scrapy startproject Demo(可以先进入存放文件的目录)
2.5.2 打开pycharm打开文件Demo,新建python文件
2.5.3 新建python文件begin.py输入以下命令,运行begin可以实现爬取数据
from scrapy import cmdline
cmdline.execute("scrapy crawl uestc".split())
2.5.4 打开settings.py设置输出文件格式和文件位置以及User_agent
FEED_URI = u'file:///C:/scrapy/test.csv'//输出目录
FEED_FORMAT='CSV'
FEED_EXPORT_ENCODING="gb18030"
3 以下为部分图片
pycharm爬取网页数据的更多相关文章
- 使用webdriver+urllib爬取网页数据(模拟登陆,过验证码)
urilib是python的标准库,当我们使用Python爬取网页数据时,往往用的是urllib模块,通过调用urllib模块的urlopen(url)方法返回网页对象,并使用read()方法获得ur ...
- python之爬取网页数据总结(一)
今天尝试使用python,爬取网页数据.因为python是新安装好的,所以要正常运行爬取数据的代码需要提前安装插件.分别为requests Beautifulsoup4 lxml 三个插件 ...
- python爬虫——爬取网页数据和解析数据
1.网络爬虫的基本概念 网络爬虫(又称网络蜘蛛,机器人),就是模拟客户端发送网络请求,接收请求响应,一种按照一定的规则,自动地抓取互联网信息的程序.只要浏览器能够做的事情,原则上,爬虫都能够做到. 2 ...
- 使用XPath爬取网页数据
我们以我的博客为例,来爬取我所有写过的博客的标题. 首先,打开我的博客页面,右键“检查”开始进行网页分析.我们选中博客标题,再次右键“检查”即可找到标题相应的位置,我们继续点击右键,选择Copy,再点 ...
- 使用 Python 爬取网页数据
1. 使用 urllib.request 获取网页 urllib 是 Python 內建的 HTTP 库, 使用 urllib 可以只需要很简单的步骤就能高效采集数据; 配合 Beautiful 等 ...
- 03:requests与BeautifulSoup结合爬取网页数据应用
1.1 爬虫相关模块命令回顾 1.requests模块 1. pip install requests 2. response = requests.get('http://www.baidu.com ...
- Selenium+Tesseract-OCR智能识别验证码爬取网页数据
1.项目需求描述 通过订单号获取某系统内订单的详细数据,不需要账号密码的登录验证,但有图片验证码的动态识别,将获取到的数据存到数据库. 2.整体思路 1.通过Selenium技术,无窗口模式打开浏览器 ...
- 使用puppeteer爬取网页数据实践小结
简单介绍Puppeteer Puppeteer是一个Node库,它通过DevTools协议提供高级API来控制Chrome或Chromium.Puppeteer默认以无头方式运行,但可以配置为有头方式 ...
- 【推荐】oc解析HTML数据的类库(爬取网页数据)
TFhpple是一个用于解析html数据的第三方库,本人感觉功能还算可以,只不过在使用前必须配置项目. 配置 1.导入libxml2.tbd 2.设置编译路径 使用 这里使用一个例子来说明 http: ...
随机推荐
- 微信小程序组件化开发框架WePY
wepy-CLI 安装 npm install -g wepy-cli wepy init standard my-project https://github.com/Tencent/wepy 特性 ...
- Android入门教程(八)
关注我,每天都有优质技术文章推送,工作,学习累了的时候放松一下自己. 本篇文章同步微信公众号 欢迎大家关注我的微信公众号:「醉翁猫咪」 今天讲讲安卓入门(八),讲讲Android的简介,如何搭建An ...
- 利用Xilinx ROM仿真时注意包括.mif文件
利用Xilinx ROM仿真时,注意包括.mif文件.一般是将.v文件和.mif文件放在同一个目录下,以便.v文件读取.mif数据.如不注意,就不会读出有效数据.
- 原创:搜索排序算法之自定义性能优良的PriorityQueue(与Python的heap比较)
前几天写了一篇关于"史上对BM25模型最全面最深刻解读以及lucene排序深入解读"的博客,lucene最后排序用到的思想是"从海量数据中寻找topK"的时间空 ...
- Centos 7 更换为 阿里云 yum 源
地址: https://opsx.alibaba.com/ 操作步骤: 1.备份 mv /etc/yum.repos.d/CentOS-Base.repo /etc/yum.repos.d/CentO ...
- 第12组 Alpha冲刺(5/6)
Header 队名:To Be Done 组长博客 作业博客 团队项目进行情况 燃尽图(组内共享) 展示Git当日代码/文档签入记录(组内共享) 注: 由于GitHub的免费范围内对多人开发存在较多限 ...
- 隐藏一个button的方法(2种) 写出一个button的按钮(2种)
display:none;visibility:hidden: <input type = button><button>这是一个按钮 </button>
- vue-admin-template 切换回中文
使用vue-admin-template开发项目,使用的是element-ui的控件,但这个框架走的是国际化,是英文版,好吧!快速切换为中文版: 找到main.js 第七行: 替换为: import ...
- Jmeter之测试计划
一.打开jmeter时会有一个测试计划默认显示,界面如下: 二.测试计划各个配置项说明 1.名称:即整个测试计划的名称,已实际项目命名为好: 2.注释:即添加一些备注信息,以便后期回顾时查看: 3.用 ...
- tqdm学习-一个快速,可扩展的Python和CLI进度条
参考:https://pypi.org/project/tqdm/ 1.安装: (base) userdeMacBook-Pro:~ user$ conda activate deeplearning ...