
第三百六十六节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的bool组合查询
第三百六十六节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的bool组合查询
bool查询说明
filter:[],字段的过滤,不参与打分
must:[],如果有多个查询,都必须满足【并且】
should:[],如果有多个查询,满足一个或者多个都匹配【或者】
must_not:[],相反查询词一个都不满足的就匹配【取反,非】
# bool查询

# 老版本的filtered已经被bool替换

#用 bool 包括 must should must_not filter 来完成

#格式如下:

#bool:{

#     "filter":[],      字段的过滤,不参与打分

#     "must":[],        如果有多个查询,都必须满足【并且】

#     "should":[],      如果有多个查询,满足一个或者多个都匹配【或者】

#     "must_not":[],    相反查询词一个都不满足的就匹配【取反,非】

#}
建立测试数据
#建立测试数据

POST jobbole/job/_bulk

{"index":{"_id":1}}

{"salary":10,"title":"python"}

{"index":{"_id":2}}

{"salary":20,"title":"Scrapy"}

{"index":{"_id":3}}

{"salary":30,"title":"Django"}

{"index":{"_id":4}}

{"salary":40,"title":"Elasticsearch"}
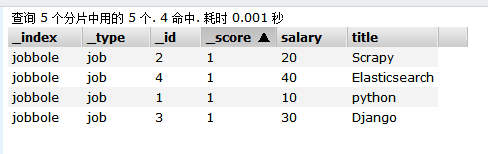
bool组合查询——最简单的filter过滤查询之term查询,相当于等于
过滤查询到salary字段等于20的数据
可以看出执行两个两个步骤,先查到所有数据,然后在查到的所有数据过滤查询到salary字段等于20的数据
# bool查询

# 老版本的filtered已经被bool替换

#用 bool 包括 must should must_not filter 来完成

#格式如下:

#bool:{

#     "filter":[],      字段的过滤,不参与打分

#     "must":[],        如果有多个查询,都必须满足

#     "should":[],      如果有多个查询,满足一个或者多个都匹配

#     "must_not":[],    相反查询词一个都不满足的就匹配

#}

#简单过滤查询

#最简单的filter过滤查询

#如果我们要查salary字段等于20的数据

GET jobbole/job/_search

{

  "query": {

    "bool": {                   #bool组合查询

      "must":{                  #如果有多个查询词,都必须满足

        "match_all":{}          #查询所有字段

      },

      "filter": {               #filter过滤

        "term": {               #term查询,不会将我们的搜索词进行分词,将搜索词完全匹配的查询

          "salary": 20          #查询salary字段值为20

        }

      }

    }

  }

}

#简单过滤查询

#最简单的filter过滤查询

#如果我们要查salary字段等于20的数据

GET jobbole/job/_search

{

  "query": {

    "bool": {

      "must":{

        "match_all":{}

      },

      "filter": {

        "term": {

          "salary": 20

        }

      }

    }

  }

}
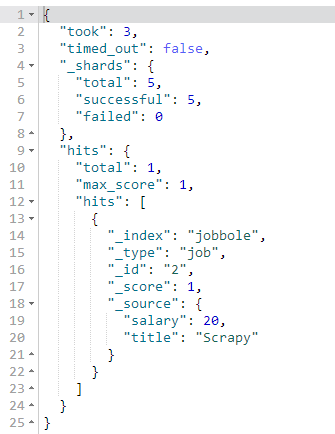
bool组合查询——最简单的filter过滤查询之terms查询,相当于或
过滤查询到salary字段等于10或20的数据
# bool查询

# 老版本的filtered已经被bool替换

#用 bool 包括 must should must_not filter 来完成

#格式如下:

#bool:{

#     "filter":[],      字段的过滤,不参与打分

#     "must":[],        如果有多个查询,都必须满足

#     "should":[],      如果有多个查询,满足一个或者多个都匹配

#     "must_not":[],    相反查询词一个都不满足的就匹配

#}

#简单过滤查询

#最简单的filter过滤查询

#如果我们要查salary字段等于20的数据

#过滤salary字段值为10或者20的数据

GET jobbole/job/_search

{

  "query": {

    "bool": {

      "must":{

        "match_all":{}

      },

      "filter": {

        "terms": {

          "salary":[10,20]

        }

      }

    }

  }

}
注意:filter过滤里也可以用其他基本查询的
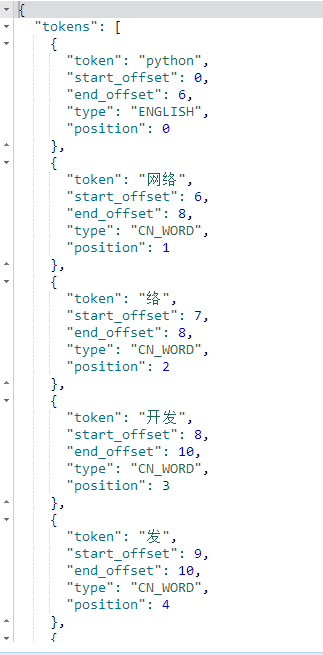
_analyze测试查看分词器解析的结果
analyzer设置分词器类型ik_max_word精细化分词,ik_smart非精细化分词
text设置词
#_analyze测试查看分词器解析的结果

#analyzer设置分词器类型ik_max_word精细化分词,ik_smart非精细化分词

#text设置词

GET _analyze

{

  "analyzer": "ik_max_word",

  "text": "Python网络开发工程师"

}

GET _analyze

{

  "analyzer": "ik_smart",

  "text": "Python网络开发工程师"

}
bool组合查询——组合复杂查询1
查询salary字段等于20或者title字段等于python、salary字段不等于30、并且salary字段不等于10的数据
# bool查询

# 老版本的filtered已经被bool替换

#用 bool 包括 must should must_not filter 来完成

#格式如下:

#bool:{

#     "filter":[],      字段的过滤,不参与打分

#     "must":[],        如果有多个查询,都必须满足【并且】

#     "should":[],      如果有多个查询,满足一个或者多个都匹配【或者】

#     "must_not":[],    相反查询词一个都不满足的就匹配【取反,非】

#}

# 查询salary字段等于20或者title字段等于python、salary字段不等于30、并且salary字段不等于10的数据

GET jobbole/job/_search

{

  "query": {

    "bool": {

      "should": [

        {"term":{"salary":20}},

        {"term":{"title":"python"}}

      ],

      "must_not": [

        {"term": {"salary":30}},

        {"term": {"salary":10}}]

    }

  }

}
bool组合查询——组合复杂查询2
查询salary字段等于20或者title字段等于python、salary字段不等于30、并且salary字段不等于10的数据
# bool查询

# 老版本的filtered已经被bool替换

#用 bool 包括 must should must_not filter 来完成

#格式如下:

#bool:{

#     "filter":[],      字段的过滤,不参与打分

#     "must":[],        如果有多个查询,都必须满足【并且】

#     "should":[],      如果有多个查询,满足一个或者多个都匹配【或者】

#     "must_not":[],    相反查询词一个都不满足的就匹配【取反,非】

#}

# 查询title字段等于python、或者、(title字段等于elasticsearch并且salary等于30)的数据

GET jobbole/job/_search

{

  "query": {

    "bool": {

      "should":[

        {"term":{"title":"python"}},

        {"bool": {

          "must": [

            {"term": {"title":"elasticsearch"}},

            {"term":{"salary":30}}

          ]

        }}

      ]

    }

  }

}
bool组合查询——过滤空和非空
#建立数据

POST bbole/jo/_bulk

{"index":{"_id":""}}

{"tags":["search"]}

{"index":{"_id":""}}

{"tags":["search","python"]}

{"index":{"_id":""}}

{"other_field":["some data"]}

{"index":{"_id":""}}

{"tags":null}

{"index":{"_id":""}}

{"tags":["search",null]}
处理null空值的方法
获取tags字段,值不为空并且值不为null的数据
# bool查询

# 老版本的filtered已经被bool替换

#用 bool 包括 must should must_not filter 来完成

#格式如下:

#bool:{

#     "filter":[],      字段的过滤,不参与打分

#     "must":[],        如果有多个查询,都必须满足【并且】

#     "should":[],      如果有多个查询,满足一个或者多个都匹配【或者】

#     "must_not":[],    相反查询词一个都不满足的就匹配【取反,非】

#}

#处理null空值的方法

#获取tags字段,值不为空并且值不为null的数据

GET bbole/jo/_search

{

  "query": {

    "bool": {

      "filter": {

        "exists": {

          "field": "tags"

        }

      }

    }

  }

}
获取tags字段值为空或者为null的数据,如果数据没有tags字段也会获取
# bool查询

# 老版本的filtered已经被bool替换

#用 bool 包括 must should must_not filter 来完成

#格式如下:

#bool:{

#     "filter":[],      字段的过滤,不参与打分

#     "must":[],        如果有多个查询,都必须满足【并且】

#     "should":[],      如果有多个查询,满足一个或者多个都匹配【或者】

#     "must_not":[],    相反查询词一个都不满足的就匹配【取反,非】

#}

#获取tags字段值为空或者为null的数据,如果数据没有tags字段也会获取

GET bbole/jo/_search

{

  "query": {

    "bool": {

      "must_not": {

        "exists": {

          "field": "tags"

        }

      }

    }

  }

}
第三百六十六节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的bool组合查询的更多相关文章
- 第三百五十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—将bloomfilter(布隆过滤器)集成到scrapy-redis中
第三百五十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—将bloomfilter(布隆过滤器)集成到scrapy-redis中,判断URL是否重复 布隆过滤器(Bloom Filter)详 ...
- 第三百五十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy的暂停与重启
第三百五十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy的暂停与重启 scrapy的每一个爬虫,暂停时可以记录暂停状态以及爬取了哪些url,重启时可以从暂停状态开始爬取过的UR ...
- 第三百六十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索功能
第三百六十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索功能 Django实现搜索功能 1.在Django配置搜索结果页的路由映 ...
- 第三百六十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本查询
第三百六十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本查询 1.elasticsearch(搜索引擎)的查询 elasticsearch是功能 ...
- 第三百六十四节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mapping映射管理
第三百六十四节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mapping映射管理 1.映射(mapping)介绍 映射:创建索引的时候,可以预先定义字 ...
- 第三百六十节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本概念
第三百六十节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本概念 elasticsearch的基本概念 1.集群:一个或者多个节点组织在一起 2.节点 ...
- 第三百六十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索的自动补全功能
第三百六十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—用Django实现搜索的自动补全功能 elasticsearch(搜索引擎)提供了自动补全接口 官方说明:https://www.e ...
- 第三百六十七节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)scrapy写入数据到elasticsearch中
第三百六十七节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)scrapy写入数据到elasticsearch中 前面我们讲到的elasticsearch( ...
- 第三百六十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mget和bulk批量操作
第三百六十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mget和bulk批量操作 注意:前面讲到的各种操作都是一次http请求操作一条数据,如果想 ...
随机推荐
- 菜鸟教程之工具使用(三)——Maven自动部署到Tomcat
书接上回,上一篇博客介绍了如何用Maven将项目打包,这篇文章就说一下如何用Maven将打完的war包部署到Tomcat,而不是手动的copy过去. 目前比较流行的方式有两种:一种是利用Tomcat官 ...
- EF事务处理封装公用
/// <summary> /// EF事务封装 公用类 /// </summary> public class TransactionCommon { DbContextTr ...
- .NET MVC5+ Dapper+扩展+微软Unity依赖注入实例
1.dapper和dapper扩展需要在线安装或者引用DLL即可 使用nuget为项目增加Unity相关的包 2.model类 public class UserInfo { public int I ...
- Solr实现 并集式、多值、复杂 过滤查询的权限【转】
公司开发使用的搜索引擎核心是Solr,但是应为业务原因,需要相对复杂权限机制. 1)通过Solr的filterQuery可以实现field过滤,实现过滤项的效果.索引A{filter1:a,field ...
- 使用ViewPager和Fragment实现滑动导航
ViewPage是android-support-v4.jar包提供的用于页面滑动的库,android-support-v4.jar是google推荐使用的一个类库,在项目中使用之前,你必须其添加到项 ...
- 【转】MySQL中information_schema是什么
大家在安装或使用MYSQL时,会发现除了自己安装的数据库以外,还有一个information_schema数据库. information_schema数据库是做什么用的呢,使用WordPress博客 ...
- 九章面试题:Find first K frequency numbers 解题报告
Find first K frequency numbers /* * Input: int[] A = {1, 1, 2, 3, 4, 5, 2}; k = 3 * return the highe ...
- RedHat中代理设置
YUM代理设置 编辑/etc/yum.conf,在最后加入 # Proxy proxy=http://username:password@proxy_ip:port/ 也可以使用proxy_usern ...
- ubuntu下上传本地代码到github
在github上有两种方法上传代码,一种是通过https,一种是通过SSH,这篇主要分享的是通过https的方法上传 首先,将你项目的所有代码放在一个文件夹中,然后在github上创建一个新的仓库 然 ...
- Inner Functions - What Are They Good For?
Referece: https://realpython.com/blog/python/inner-functions-what-are-they-good-for/ Let’s look at t ...