
第三百六十四节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mapping映射管理
第三百六十四节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mapping映射管理
1、映射(mapping)介绍
映射:创建索引的时候,可以预先定义字段的类型以及相关属性
elasticsearch会根据json源数据的基础类型猜测你想要的字段映射,将输入的数据转换成可搜索的索引项,mapping就是我们自己定义的字段数据类型,同时告诉elasticsearch如何索引数据以及是否可以被搜索
作用:会让索引建立的更加细致和完善
类型:静态映射和动态映射
2、内置映射类型(也就是数据类型)
string类型:text,keyword两种
text类型:会进行分词,抽取词干,建立倒排索引
keyword类型:就是一个普通字符串,只能完全匹配才能搜索到
数字类型:long,integer,short,byte,double,float
日期类型:date
bool(布尔)类型:boolean
binary(二进制)类型:binary
复杂类型:object,nested
geo(地区)类型:geo-point,geo-shape
专业类型:ip,competion
3、属性介绍
store属性
index属性
null_value属性
analyzer属性
include_in_all属性
format属性
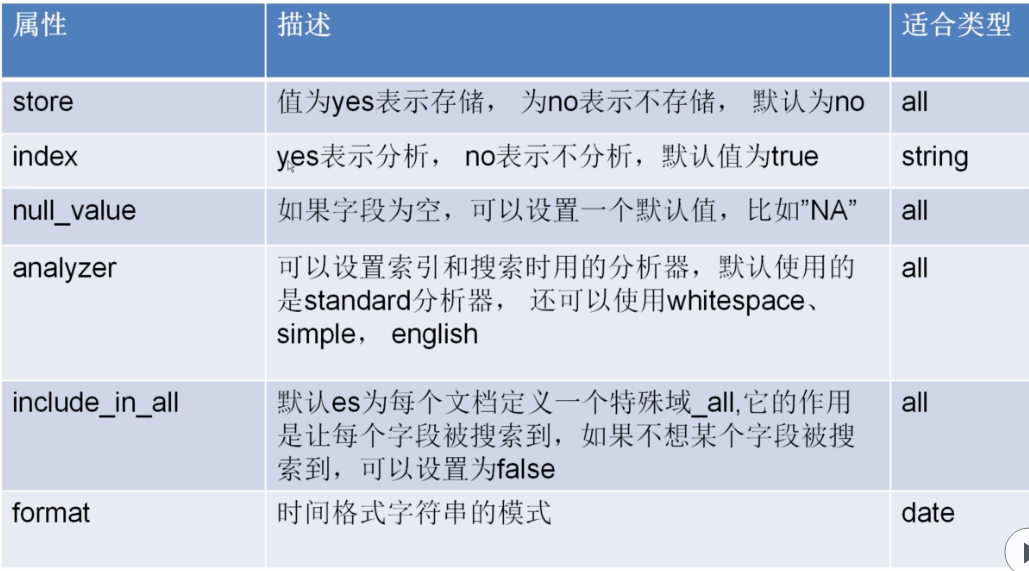
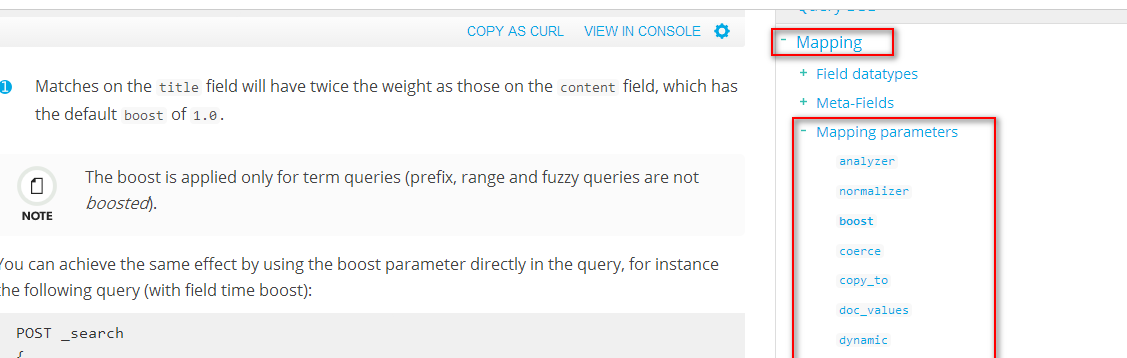
更多属性:https://www.elastic.co/guide/en/elasticsearch/reference/current/mapping-boost.html
4、创建索引(相当于创建数据库)、创建表、创建字段-设置字段类型,添加数据
说明:
#创建索引(设置字段类型)

PUT jobbole                         #创建索引设置索引名称

{

  "mappings": {                     #设置mappings映射字段类型

    "job": {                        #表名称

      "properties": {               #设置字段类型

        "title":{                   #title字段

          "type": "text"            #text类型,text类型可以分词,建立倒排索引

        },

        "salary_min":{              #salary_min字段

          "type": "integer"         #integer数字类型

        },

        "city":{                    #city字段

          "type": "keyword"         #keyword普通字符串类型

        },

        "company":{                 #company字段,是嵌套字段

          "properties":{            #设置嵌套字段类型

            "name":{                #name字段

              "type":"text"         #text类型

            },

            "company_addr":{        #company_addr字段

              "type":"text"         #text类型

            },

            "employee_count":{      #employee_count字段

              "type":"integer"      #integer数字类型

            }

          }

        },

        "publish_date":{            #publish_date字段

          "type": "date",           #date时间类型

          "format":"yyyy-MM-dd"     #yyyy-MM-dd格式化时间样式

        },

        "comments":{                #comments字段

          "type": "integer"         #integer数字类型

        }

      }

    }

  }

}

#保存文档(相当于数据库的写入数据)

PUT jobbole/job/1                       #索引名称/表/id

{

  "title":"python分布式爬虫开发",       #字段名称:字段值

  "salary_min":15000,                   #字段名称:字段值

  "city":"北京",                        #字段名称:字段值

  "company":{                           #嵌套字段

    "name":"百度",                      #字段名称:字段值

    "company_addr":"北京市软件园",      #字段名称:字段值

    "employee_count":50                 #字段名称:字段值

  },

  "publish_date":"2017-4-16",           #字段名称:字段值

  "comments":15                         #字段名称:字段值

}
代码:
#创建索引(设置字段类型)

PUT jobbole

{

  "mappings": {

    "job": {

      "properties": {

        "title":{

          "type": "text"

        },

        "salary_min":{

          "type": "integer"

        },

        "city":{

          "type": "keyword"

        },

        "company":{

          "properties":{

            "name":{

              "type":"text"

            },

            "company_addr":{

              "type":"text"

            },

            "employee_count":{

              "type":"integer"

            }

          }

        },

        "publish_date":{

          "type": "date",

          "format":"yyyy-MM-dd"

        },

        "comments":{

          "type": "integer"

        }

      }

    }

  }

}

#保存文档(相当于数据库的写入数据)

PUT jobbole/job/1

{

  "title":"python分布式爬虫开发",

  "salary_min":15000,

  "city":"北京",

  "company":{

    "name":"百度",

    "company_addr":"北京市软件园",

    "employee_count":50

  },

  "publish_date":"2017-4-16",

  "comments":15

}
5、获取索引下的mappings映射字段类型
#获取一个索引下的所有表的mappings映射字段类型

GET jobbole/_mapping

#获取一个索引下的指定表的mappings映射字段类型

GET jobbole/_mapping/job
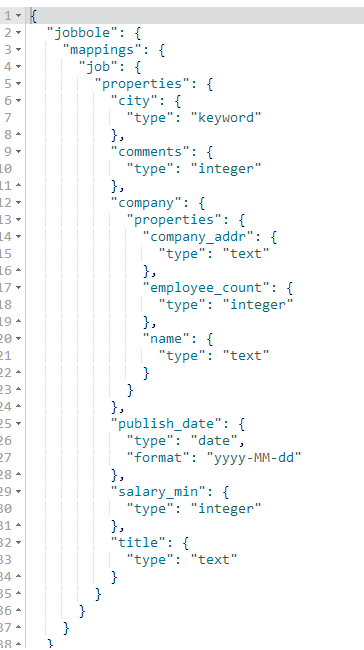
【重点】在创建索引时一旦给字段设置了类型后就不可修改了,如果必须要修改就的重新创建索引,所以在创建索引时就必须确定好字段类型
第三百六十四节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mapping映射管理的更多相关文章
- 第三百六十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索的自动补全功能
第三百六十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—用Django实现搜索的自动补全功能 elasticsearch(搜索引擎)提供了自动补全接口 官方说明:https://www.e ...
- 第三百六十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mget和bulk批量操作
第三百六十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mget和bulk批量操作 注意:前面讲到的各种操作都是一次http请求操作一条数据,如果想 ...
- 第三百五十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—将bloomfilter(布隆过滤器)集成到scrapy-redis中
第三百五十八节,Python分布式爬虫打造搜索引擎Scrapy精讲—将bloomfilter(布隆过滤器)集成到scrapy-redis中,判断URL是否重复 布隆过滤器(Bloom Filter)详 ...
- 第三百五十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy的暂停与重启
第三百五十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy的暂停与重启 scrapy的每一个爬虫,暂停时可以记录暂停状态以及爬取了哪些url,重启时可以从暂停状态开始爬取过的UR ...
- 第三百六十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索功能
第三百六十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索功能 Django实现搜索功能 1.在Django配置搜索结果页的路由映 ...
- 第三百六十六节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的bool组合查询
第三百六十六节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的bool组合查询 bool查询说明 filter:[],字段的过滤,不参与打分must:[] ...
- 第三百六十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本查询
第三百六十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本查询 1.elasticsearch(搜索引擎)的查询 elasticsearch是功能 ...
- 第三百六十节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本概念
第三百六十节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本概念 elasticsearch的基本概念 1.集群:一个或者多个节点组织在一起 2.节点 ...
- 第三百六十七节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)scrapy写入数据到elasticsearch中
第三百六十七节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)scrapy写入数据到elasticsearch中 前面我们讲到的elasticsearch( ...
随机推荐
- ES performance
http://easyice.cn/ https://m.aliyun.com/yunqi/articles/60474 https://www.jianshu.com/c/d5c542376948 ...
- python(45)内置函数:os.system() 和 os.popen()
os.system() 和 os.popen() 概述 os.popen() 方法用于从一个命令打开一个管道. 在Unix,Windows中有效 语法 popen()方法语法格式如下: os.pope ...
- (原)ubuntu下cadvisor+influxdb+grafana+supervisord监控主机和docker的containers
ubuntu下cadvisor+influxdb+grafana+supervisord监控主机和docker的containers(运行在主机上) 适用于类ubuntu系统.amd64. 1. in ...
- (原)docker安装
2018直接看这里: https://docs.docker.com/cs-engine/1.12/#install-on-ubuntu-1404-lts-or-1604-lts 以下为原文: 网上的 ...
- MOTIONEVENT的GETX()和GETRAWX()和VIEW的GETLEFT()3个方法的区别
- js实现类似qq表情(插入图片以及获取光标的效果)
<!doctype html><html style="height:100%"><head><meta charset="ut ...
- 在windows下nginx+django+flup python3
1.安装python 下载最新的python版本,在本文撰写时为 python 3.4, 下载地址:https://www.python.org/ftp/python/3.4.0/python-3.4 ...
- SQLite 入门教程一 基本控制台(终端)命令
一.基本简介 SQLite 是一个自持的(self-contained).无服务器的.零配置的.事务型的关系型数据库引擎.因为他很小,所以也可以作为嵌入式数据库内建在你的应用程序中.SQLite 被应 ...
- <[长期赢利:股票价值投资方法]>读书笔记
书在这里 风险是因为不够专业 在股市里,要不断拓宽自己的眼界 投资如长跑,贵在坚持 长线为主,短线为辅:重视选股,减少盲目:耐心等待,春天回来 除了要与银行利息比以外,还要了解当时股票的平均市盈率,再 ...
- 新浪微博 oauth2.0 redirect_uri_mismatch
新浪微博开放平台出来很久了,现在才开始研究,貌似有点晚了.... 第一次折腾,总是出现这样那样的问题,即使照着别人成功的例子也是一样,这不,开始运行的时候,运行下面的例子,总是报error:redir ...