
kafka安装以及入门
一、安装
下载最新版kafka,Apache Kafka,然后上传到Linux,我这里有三台机器,192.168.127.129,130,131 。
进入上传目录,解压到/usr/local目录下
tar -zxvf kafka_2.-0.11.0.0.tgz -C /usr/local/
进入/usr/local目录
cd /usr/local
然后改一下名字(这一步可有可无)
mv kafka_2.-0.11.0.0/ kafka
进入kafka目录,编辑配置文件
cd kafka/

vi config/server.properties
配置文件:有的地方三台机器不一样哦,不一样的你都能看出来
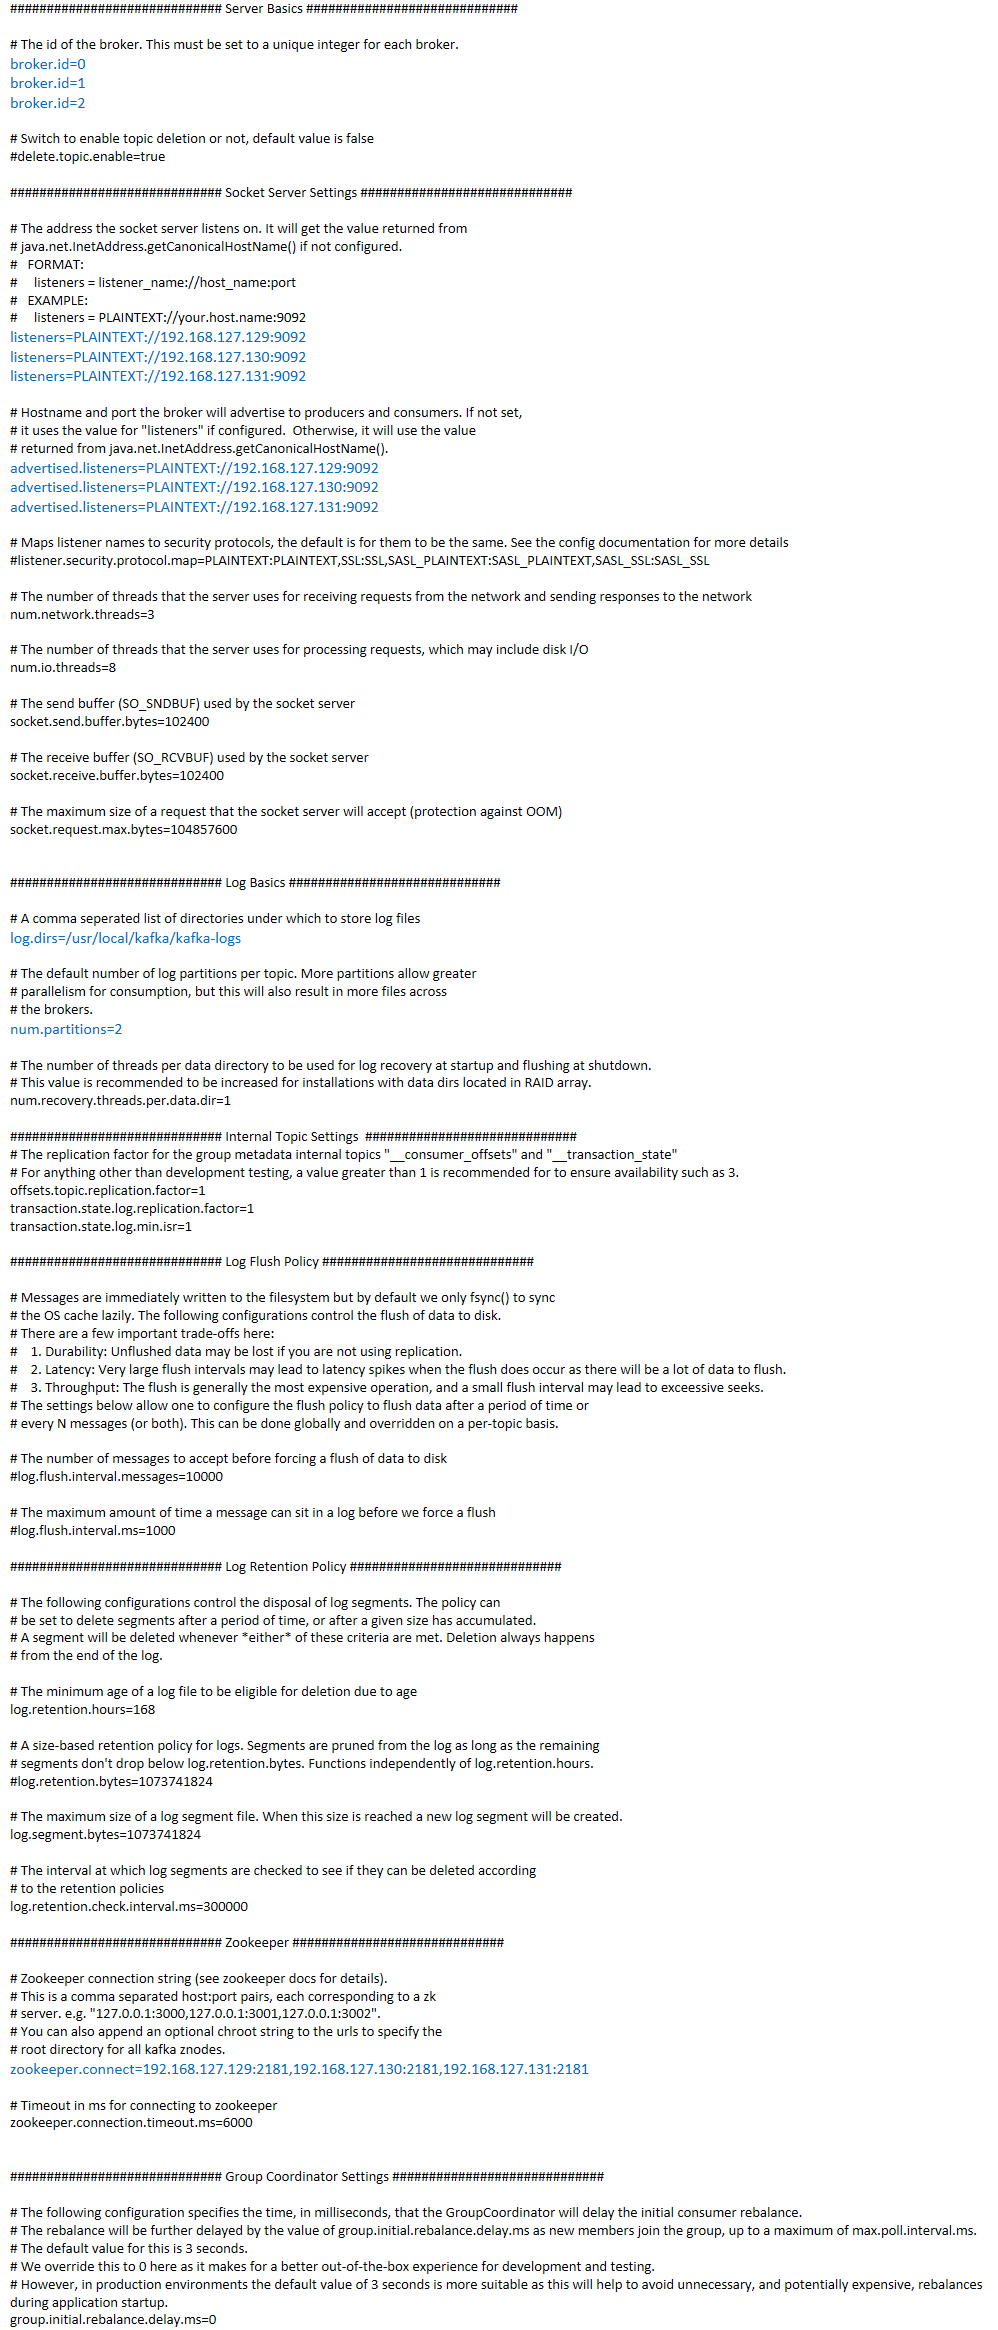
编辑好之后,进入kafka目录并且建立日志目录
mkdir kafka-logs
开启kafka的通信端口9092
firewall-cmd --zone=public --add-port=/tcp --permanent

systemctl restart firewalld
启动Zookeeper,如果你不知道Zookeeper安装的话,就找我的文章,有一篇是关于Zookeeper安装的。
然后启动kafka
cd /usr/local/kafka/bin/

./kafka-server-start.sh /usr/local/kafka/config/server.properties &
最后出现
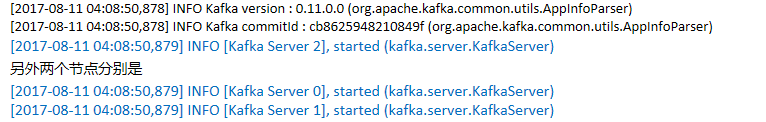
就是成功了,进入Zookeeper客户端

除了activemq,zookeeper,dubbo,root,都是kafka相关的
二、入门
依赖jar包,请找到kafka的libs目录
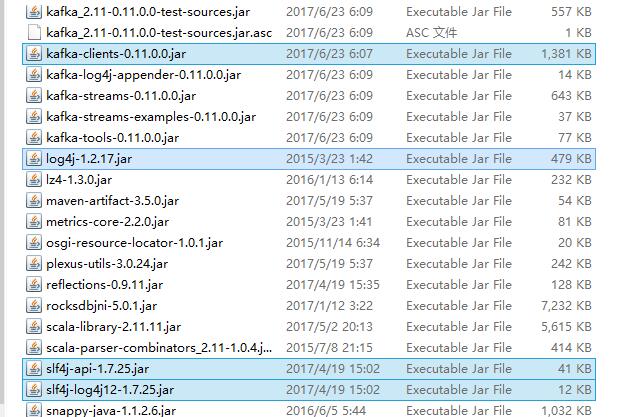
生产者:

import java.util.Properties;

import org.apache.kafka.clients.producer.KafkaProducer;

import org.apache.kafka.clients.producer.Producer;

import org.apache.kafka.clients.producer.ProducerRecord;

public class SimpleProducer {

    public static void main(String[] args) throws InterruptedException {

        Properties props = new Properties();

        props.put("bootstrap.servers", "192.168.127.129:9092,192.168.127.130:9092,192.168.127.131:9092");

        props.put("acks", "all");

        props.put("retries", 0);

        props.put("batch.size", 16384);

        props.put("linger.ms", 1);

        props.put("buffer.memory", 33554432);

        props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer");

        props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer");

        Producer<String, String> producer = new KafkaProducer<>(props);

        for (int i = 0; i < 10; i++){

            //ProducerRecord<String, String>(String topic, String key, String value)

            producer.send(new ProducerRecord<String, String>("my-topic", "fruit" + i, "banana" + i));

            Thread.sleep(1000);

        }

        producer.close();

    }

}
消费者:

import java.util.Arrays;

import java.util.Properties;

import org.apache.kafka.clients.consumer.ConsumerRecord;

import org.apache.kafka.clients.consumer.ConsumerRecords;

import org.apache.kafka.clients.consumer.KafkaConsumer;

public class SimpleConsumer {

    public static void main(String[] args) {

        Properties props = new Properties();

        props.put("bootstrap.servers", "192.168.127.129:9092,192.168.127.130:9092,192.168.127.131:9092");

        props.put("group.id", "testGroup");

        props.put("enable.auto.commit", "true");

        props.put("auto.commit.interval.ms", "1000");

        props.put("key.deserializer", "org.apache.kafka.common.serialization.StringDeserializer");

        props.put("value.deserializer", "org.apache.kafka.common.serialization.StringDeserializer");

        KafkaConsumer<String, String> consumer = new KafkaConsumer<>(props);

        //订阅的topic,多个用逗号隔开

        consumer.subscribe(Arrays.asList("my-topic"));

        while (true) {

            ConsumerRecords<String, String> records = consumer.poll(100);

            for (ConsumerRecord<String, String> record : records)

                System.out.printf("offset = %d, key = %s, value = %s%n", record.offset(), record.key(), record.value());

        }

        //consumer.close();

    }

}
先启动消费者,再启动生产者
你会发现消费者每隔1秒输出一行数据。
kafka安装以及入门的更多相关文章
- Kafka 安装及入门
什么是Kafka? Kafka是由Apache软件基金会开发的一个开源流处理平台,由Scala和Java编写.Kafka是一种高吞吐量的分布式发布订阅消息系统,它可以处理消费者规模的网站中的所有动作流 ...
- .net windows Kafka 安装与使用入门(入门笔记)
完整解决方案请参考: Setting Up and Running Apache Kafka on Windows OS 在环境搭建过程中遇到两个问题,在这里先列出来,以方便查询: 1. \Jav ...
- kafka安装和使用
kafka安装和启动 kafka的背景知识已经讲了很多了,让我们现在开始实践吧,假设你现在没有Kafka和ZooKeeper环境. Step 1: 下载代码 下载0.10.0.0版本并且解压它. &g ...
- 【3】Kafka安装及部署
一.环境准备 Linux操作系统 Java运行环境(1.6或以上) zookeeper 集群环境,可参照Zookeeper集群部署 . 服务器列表: 配置主机名映射. vi /etc/hosts ## ...
- Apache Hadoop2.x 边安装边入门
完整PDF版本:<Apache Hadoop2.x边安装边入门> 目录 第一部分:Linux环境安装 第一步.配置Vmware NAT网络 一. Vmware网络模式介绍 二. NAT模式 ...
- hadoop 之 kafka 安装与 flume -> kafka 整合
62-kafka 安装 : flume 整合 kafka 一.kafka 安装 1.下载 http://kafka.apache.org/downloads.html 2. 解压 tar -zxvf ...
- bower安装使用入门详情
bower安装使用入门详情 bower自定义安装:安装bower需要先安装node,npm,git全局安装bower,命令:npm install -g bower进入项目目录下,新建文件1.tx ...
- Kafka安装及部署
安装及部署 一.环境配置 操作系统:Cent OS 7 Kafka版本:0.9.0.0 Kafka官网下载:请点击 JDK版本:1.7.0_51 SSH Secure Shell版本:XShell 5 ...
- [Python爬虫] scrapy爬虫系列 <一>.安装及入门介绍
前面介绍了很多Selenium基于自动测试的Python爬虫程序,主要利用它的xpath语句,通过分析网页DOM树结构进行爬取内容,同时可以结合Phantomjs模拟浏览器进行鼠标或键盘操作.但是,更 ...
随机推荐
- Python_每日习题_0001_数字组合
# Topic: There are four digits: 1, 2, 3 and 4. # How many different three digits can be formed witho ...
- 《Linux内核设计与实现》第三章学习笔记
第三章 进程管理 姓名:王玮怡 学号:20135116 一.进程 1.进程的含义 进程是处于执行期的程序以及相关资源的总称,程序本身并不是进程,实际上就是正在执行的代码的实时结果.Linux内核通 ...
- Linux内核设计与实现 第四章
1. 什么是调度 现在的操作系统都是多任务的,为了能让更多的任务能同时在系统上更好的运行,需要一个管理程序来管理计算机上同时运行的各个任务(也就是进程). 这个管理程序就是调度程序,功能: 决定哪些进 ...
- 小学四则运算APP 第二次冲刺 第四天
团队成员:陈淑筠.杨家安.陈曦 团队选题:小学四则运算APP 第二次冲刺阶段时间:11.29~12.09 本次发布的是合并后的选择题功能界面的设置: ChoiceSet.java: package c ...
- 【软件工程Ⅱ】作业二 |分布式版本控制系统Git的安装与使用
本次作业的要去来自于:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/2097 远程库地址:https://github.com/Mol ...
- 软件工程(GZSD2015)学生博客列表
2015年贵州师范大学软件工程课程学生博客列表 陈小丽 郑倩 唐洁 周娟 李利思 肖俊 罗文豪 周静 徐明艳 毛涛 邓洪虹 岳庆 李盼 安坤 何亚 涂江凤 张义平 杨明颢 杨家堂 胡贵玲 寿克霞 吴明 ...
- Docker(二十)-Docker容器CPU、memory资源限制
背景 在使用 docker 运行容器时,默认的情况下,docker没有对容器进行硬件资源的限制,当一台主机上运行几百个容器,这些容器虽然互相隔离,但是底层却使用着相同的 CPU.内存和磁盘资源.如果不 ...
- pandas获取当前时间
datetime.now()用于获取当前的日期和时间 print pd.datetime.now() #encoding:utf8 import pandas as pd print("(p ...
- python排序
排序算法概览 归并排序的 空间复杂度为O(n) 插入排序 基本思想是每次讲一个待排序的记录,按其关键字大小插入到前面已拍好的子序列中,直到全部完成. 直接插入排序 讲元素L(i)插入到有序序列L[1, ...
- MySQL分区管理
以下是我看MySQL官方文档的时候整理的笔记,仅作参考保留. RANGE,LIST分区管理 1:为未分区表创建分区 ; 2:删除某个分区的数据 ALTER TABLE tr DROP PARTITIO ...