
关于大数据领域各个组件打包部署到集群运行的总结(含手动和maven)(博主推荐)
对于这里的打包,总结:
(1) 最简单的,也是为了适应公司里,还是要用maven,当然spark那边sbt,maven都可以。但是maven居多。
Eclipse/MyEclipse下如何Maven管理多个Mapreduce程序?(企业级水平)
IDEA里如何多种方式打jar包,然后上传到集群
Spark编程环境搭建(基于Intellij IDEA的Ultimate版本)(包含Java和Scala版的WordCount)(博主强烈推荐)
(2) 将整个项目打jar包进去,只需指定想要的类即可。比如你直接打成一个总的jar包,如guangdiang.jar。
[hadoop@master jar]$ hadoop jar ./guangdian.jar zhouls.bigdata.enterpriseMyHadoop.tv.AnalyzeCountChannelRating /tv-out-ECN/part-r-00000 /tv-out-ECAARN/part-r-00000 /tv-out-ACCR
[hadoop@master jar]$ hadoop jar ./guangdian.jar zhouls.bigdata.enterpriseMyHadoop.tv.AnalyzeCountProgramRating /tv-out-ECN/part-r-00000 /tv-out-EPAARN/part-r-00000 /tv-out-ACPR
(3) 直接将你想要的类打成jar包即可,比如guangdiangACCR.jar。

[hadoop@master jar]$ hadoop jar ./guangdianACCR.jar zhouls.bigdata.enterpriseMyHadoop.tv.AnalyzeCountChannelRating /tv-out-ECN/part-r-00000 /tv-out-ECAARN/part-r-00000 /tv-out-ACCR

或

[hadoop@master jar]$ hadoop jar ./guangdianACCR.jar zhouls.bigdata.enterpriseMyHadoop.tv.AnalyzeCountChannelRating /tv-out-ECN/part-r-00000 /tv-out-ECAARN/part-r-00000 /tv-out-ACCR
比如guangdiangACPR.jar。
[hadoop@master jar]$ hadoop jar ./guangdianACPR.jar zhouls.bigdata.enterpriseMyHadoop.tv.AnalyzeCountProgramRating /tv-out-ECN/part-r-00000 /tv-out-EPAARN/part-r-00000 /tv-out-ACPR

或

[hadoop@master jar]$ hadoop jar ./guangdianACPR.jar zhouls.bigdata.enterpriseMyHadoop.tv.AnalyzeCountProgramRating hdfs://master:9000/tv-out-ECN/part-r-00000 hdfs://master:9000/tv-out-EPAARN/part-r-00000 hdfs://master:9000/tv-out-ACPR
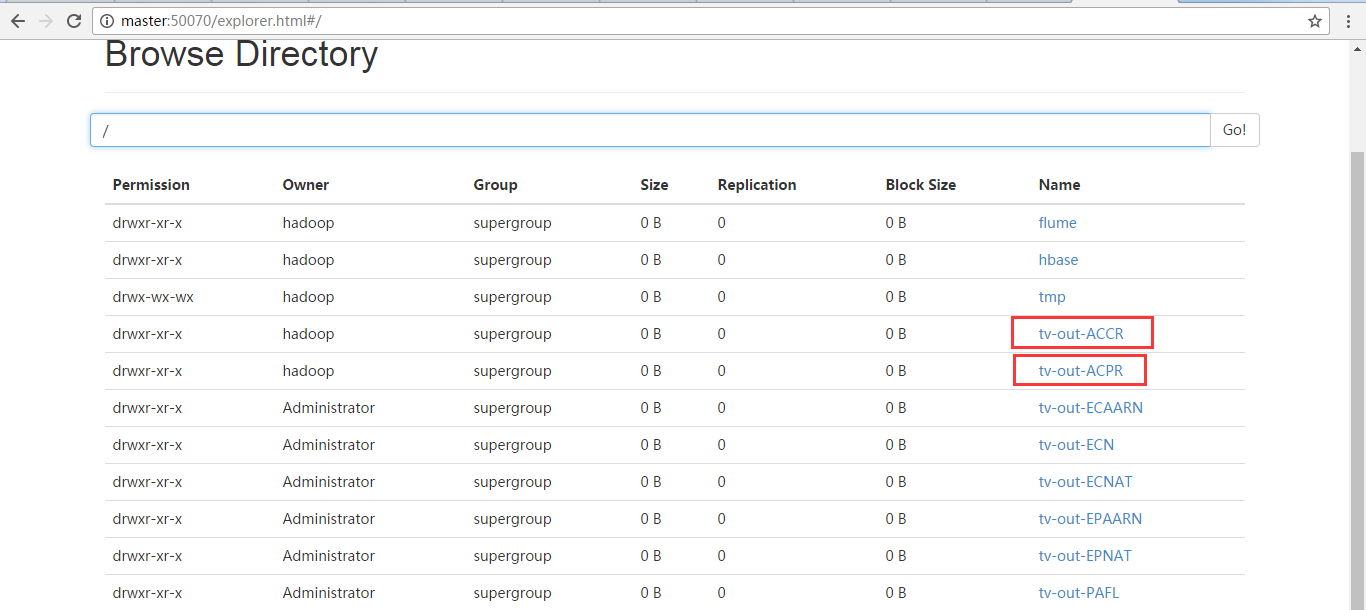

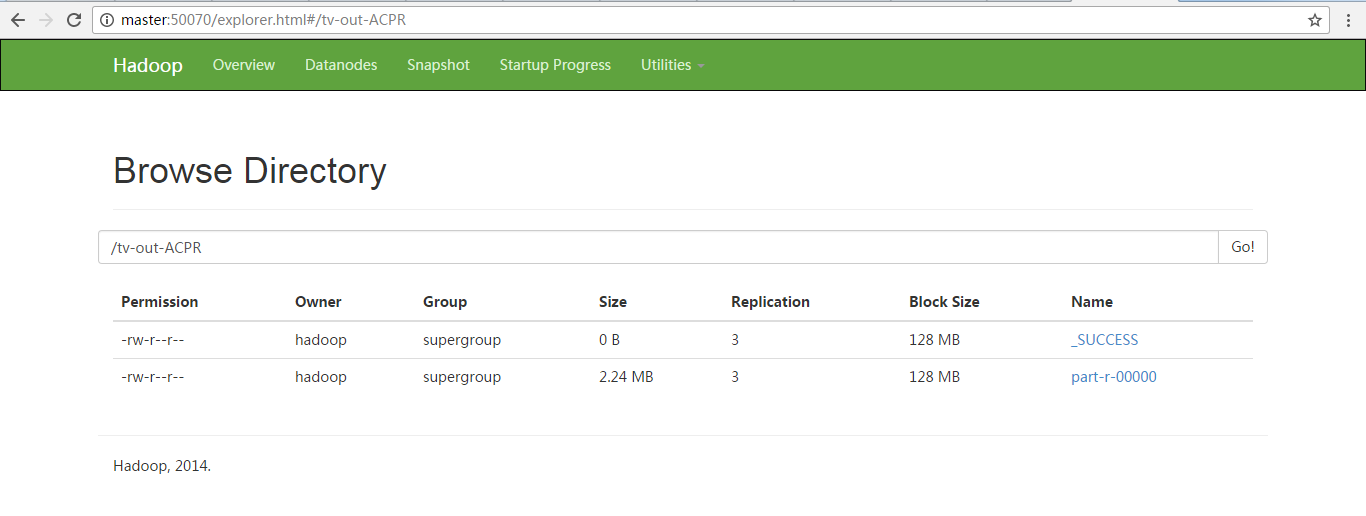

成功!
关于大数据领域各个组件打包部署到集群运行的总结(含手动和maven)(博主推荐)的更多相关文章
- 【大数据之数据仓库】安装部署GreenPlum集群
本篇将向大家介绍如何快捷的安装部署GreenPlum测试集群,大家可以跟着我一块儿实践一把^_^ 1.主机资源 申请2台网易云主机,操作系统必须是RedHat或者CentOS,配置尽量高一点.如果是s ...
- Spark学习笔记3(IDEA编写scala代码并打包上传集群运行)
Spark学习笔记3 IDEA编写scala代码并打包上传集群运行 我们在IDEA上的maven项目已经搭建完成了,现在可以写一个简单的spark代码并且打成jar包 上传至集群,来检验一下我们的sp ...
- CentOS6安装各种大数据软件 第五章:Kafka集群的配置
相关文章链接 CentOS6安装各种大数据软件 第一章:各个软件版本介绍 CentOS6安装各种大数据软件 第二章:Linux各个软件启动命令 CentOS6安装各种大数据软件 第三章:Linux基础 ...
- 大数据Hadoop的HA高可用架构集群部署
1 概述 在Hadoop 2.0.0之前,一个Hadoop集群只有一个NameNode,那么NameNode就会存在单点故障的问题,幸运的是Hadoop 2.0.0之后解决了这个问题,即支持N ...
- 大数据基础知识:分布式计算、服务器集群[zz]
大数据中的数据量非常巨大,达到了PB级别.而且这庞大的数据之中,不仅仅包括结构化数据(如数字.符号等数据),还包括非结构化数据(如文本.图像.声音.视频等数据).这使得大数据的存储,管理和处理很难利用 ...
- 大数据平台搭建 - cdh5.11.1 - hadoop集群安装
一.前言 由于线下测试的需要,需要在公司线下(测试)环境搭建大数据集群. 那么CDH是什么? hadoop是一个开源项目,所以很多公司再这个基础上进行商业化,不收费的hadoop版本主要有三个,分别是 ...
- 流式大数据计算实践(2)----Hadoop集群和Zookeeper
一.前言 1.上一文搭建好了Hadoop单机模式,这一文继续搭建Hadoop集群 二.搭建Hadoop集群 1.根据上文的流程得到两台单机模式的机器,并保证两台单机模式正常启动,记得第二台机器core ...
- 大数据平台搭建 - cdh5.11.1 - hbase集群搭建
一.简介 HBase是一种构建在HDFS之上的分布式.面向列的存储系统.在需要实时读写.随机访问超大规模数据集时,可以使用HBase. 尽管已经有许多数据存储和访问的策略和实现方法,但事实上大多数解决 ...
- 大数据学习系列(7)-- hadoop集群搭建
1.配置ssh免登陆 #进入到我的home目录 cd ~/.ssh ssh-keygen -t rsa 执行完这个命令后,会生成两个文件id_rsa(私钥).id_rsa.pub(公钥) 将公钥拷贝到 ...
随机推荐
- 更改自己iCloud的地区
百度一大堆都是过时的,而且没有用,通过google后发现google+里有一个文章https://plus.google.com/+%E5%90%B4%E5%BF%97%E5%8B%8776/post ...
- 解决:xampp中Apache, MySql, Filezilla端口占用问题
读 静觅 的python博客,学到requests库的用法,看到“”如果想请求JSON文件,可以利用 json() 方法解析 ”这里迷惑了: 我写了a.json文件放在本地,却不能被python调用, ...
- shell获取ip地址
Mac: $ ifconfig en0|awk -F"[ ]+" '/inet/{print $2}' fe80::a211:9bff:fe15:%en0 192.168.0.10 ...
- 网络基础之网络协议篇---CS架构--网络通信--osi 协议---套接字socket--粘包
1 C\S 客户端/服务器架构: .硬件 C/S架构 (打印机) .软件 C/S 架构 互联网中处处是C/S架构 如黄色网站是服务端,你的浏览器是客户端(B/S架构也是C/S架构的一种) 腾讯作为服务 ...
- 机器学习敲门砖:任何人都能看懂的TensorFlow介绍
机器学习敲门砖:任何人都能看懂的TensorFlow介绍 http://www.jiqizhixin.com/article/1440
- cut---Linux下文本处理五大神器之四
转自:http://www.cnblogs.com/dong008259/archive/2011/12/09/2282679.html cut是一个选取命令,就是将一段数据经过分析,取出我们想要的. ...
- AtCoder Petrozavodsk Contest 001 A - Two Integers
Time limit : 2sec / Memory limit : 256MB Score : 100 points Problem Statement You are given positive ...
- java 实现拖动文件到窗口功能
package tuo; import java.awt.BorderLayout; import java.awt.Color; import java.awt.datatransfer.DataF ...
- Node中没搞明白require和import,你会被坑的很惨
ES6标准发布后,module成为标准,标准的使用是以export指令导出接口,以import引入模块,但是在我们一贯的node模块中,我们采用的是CommonJS规范,使用require引入模块,使 ...
- hadoop完全分布式文件系统集群搭建
一.准备工作: 1.找3台以上的主机(因为HDFS文件系统中保存的文件的blocak在datanode中至少要有3份或3份以上的备份,备份不能放于同一个机架上,更不能放于同一台主机上),我这里使用的是 ...