
[过程记录]Centos7 下 Hadoop分布式集群搭建
过程如下:
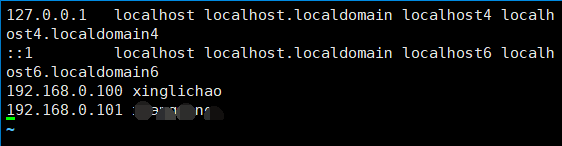
配置hosts
vim /etc/hosts
格式:
ip hostname
ip hostname
设置免密登陆
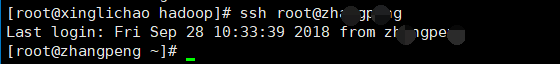
首先:每台主机使用ssh命令连接其余主机
ssh 用户名@主机名
提示是否连接:输入yes
提示输入密码:输入被请求连接主机的密码
成功过后
就会在本机的~目录下生成 .ssh文件夹
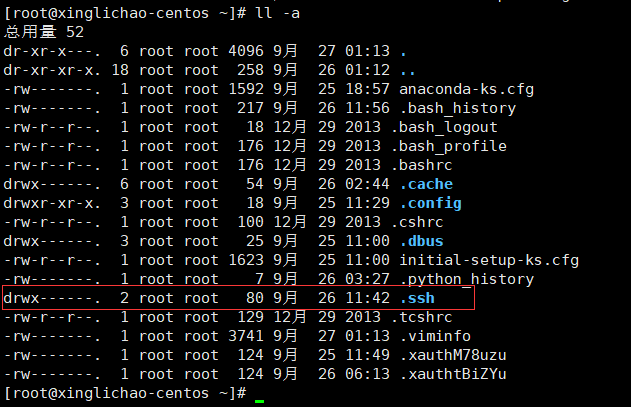
然后在master的主机上进入 ~/.ssh 目录
执行:
ssh-keygen -t rsa
回车回车再回车
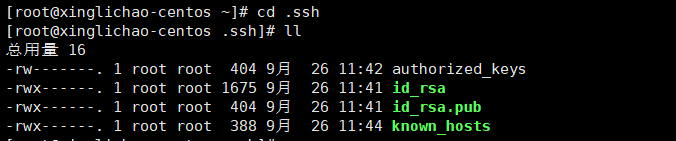
得到 id_rsa id_rsa.pub 两个文件
复制一份 id_rsa.pub
cp id_rsa.pub authorized_keys
修改权限
修改.ssh权限
chmod -R 700 .ssh
修改quthorized_keys权限
chmod 600 authorized_keys
尝试ssh连接本机
ssh root@xinglichao
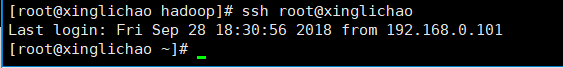
成功免密登陆
然后将 authorized_keys 分发到其他主机
scp ~/.ssh/authorized_keys root@****:~/.ssh
同样尝试ssh连接其余主机,全部可以免密登陆
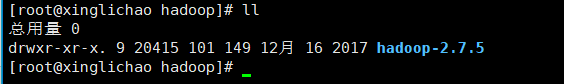
下载好hadoop并解压到指定文件夹下
master以及其余主机上配置 /etc/profile
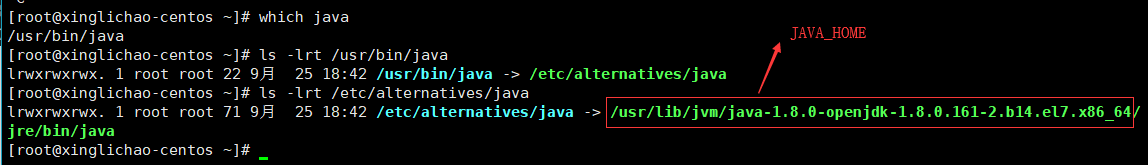
首先找到java的安装路径
[root@xinglichao-centos ~]# which java

/usr/bin/java

[root@xinglichao-centos ~]# ls -lrt /usr/bin/java

lrwxrwxrwx. 1 root root 22 9月  25 18:42 /usr/bin/java -> /etc/alternatives/java

[root@xinglichao-centos ~]# ls -lrt /etc/alternatives/java

lrwxrwxrwx. 1 root root 71 9月  25 18:42 /etc/alternatives/java -> /usr/lib/jvm/java-1.8.0-openjdk-1.8.0.161-2.b14.el7.x86_64/jre/bin/java
然后编辑profile
vim /etc/profile
添加JAVA_HOME以及HADOOP_HOME
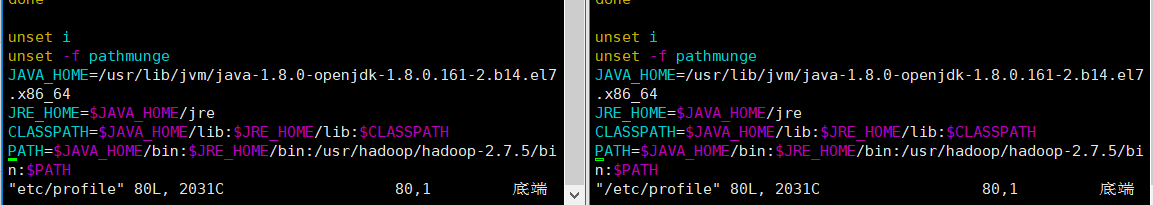
source一下使配置文件生效
source /etc/profile
master上修改hadoop的配置文件:hadoop-env.sh
vim /usr/apache/hadoop-2.7.5/etc/hadoop/hadoop-env.sh
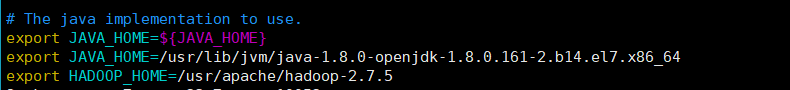
增加内容
export JAVA_HOME=/usr/lib/jvm/java-1.8.0-openjdk-1.8.0.161-2.b14.el7.x86_64

export HADOOP_HOME=/usr/apache/hadoop-2.7.5
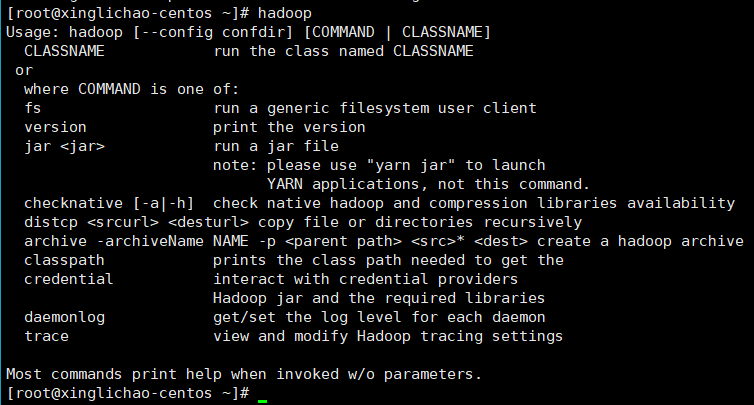
测试hadoop
hadoop
master上修改hadoop中的slaves文件,指定为另外主机名(此处不贴截图了)
vim /etc/hadoop/hadoop-2.7.5/etc/hadoop/slaves
master主机创建name节点文件夹,slaves节点创建data文件夹
master:

mkdir -p hadoop/hadoop-2.7.5/node/dfs/name

slaves:

mkdir -p hadoop/hadoop-2.7.5/node/dfs/data
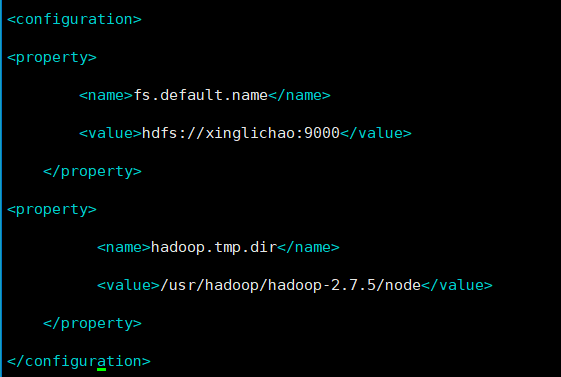
master中修改与hadoop-env.sh同文件夹下的core-site.xml
<configuration>

<property>

        <name>fs.default.name</name>

        <value>hdfs://xinglichao:9000</value>

    </property>

<property>

          <name>hadoop.tmp.dir</name>

          <value>/usr/hadoop/hadoop-2.7.5/node</value>

    </property>

</configuration>
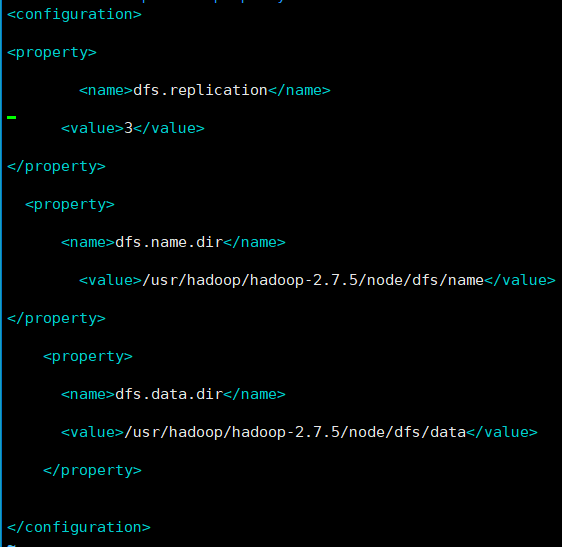
master中修改与hadoop-env.sh同文件夹下的修改hdfs-site.xml
<configuration>

<property>

        <name>dfs.replication</name>

      <value>3</value>

</property>

  <property>

      <name>dfs.name.dir</name>

        <value>/usr/hadoop/hadoop-2.7.5/node/dfs/name</value>

</property>

    <property>

      <name>dfs.data.dir</name>

      <value>/usr/hadoop/hadoop-2.7.5/node/dfs/data</value>

    </property>

</configuration>
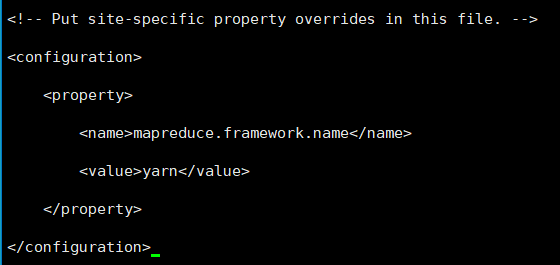
复制mapred-site.xml.template一份为mapred-site.xml,并修改为
<configuration>

    <property>

        <name>mapreduce.framework.name</name>

        <value>yarn</value>

    </property>

</configuration>
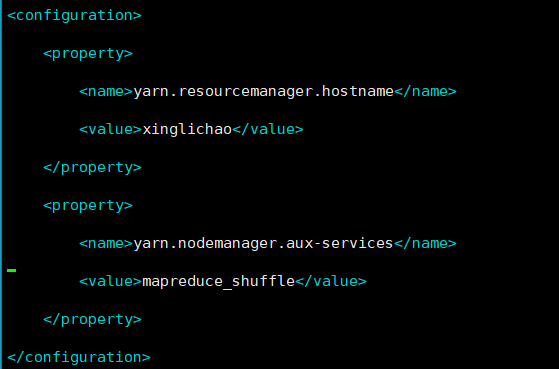
master中修改yarn-site.xml
<configuration>

    <property>

        <name>yarn.resourcemanager.hostname</name>

        <value>xinglichao</value>

    </property>

    <property>

        <name>yarn.nodemanager.aux-services</name>

        <value>mapreduce_shuffle</value>

    </property>

</configuration>
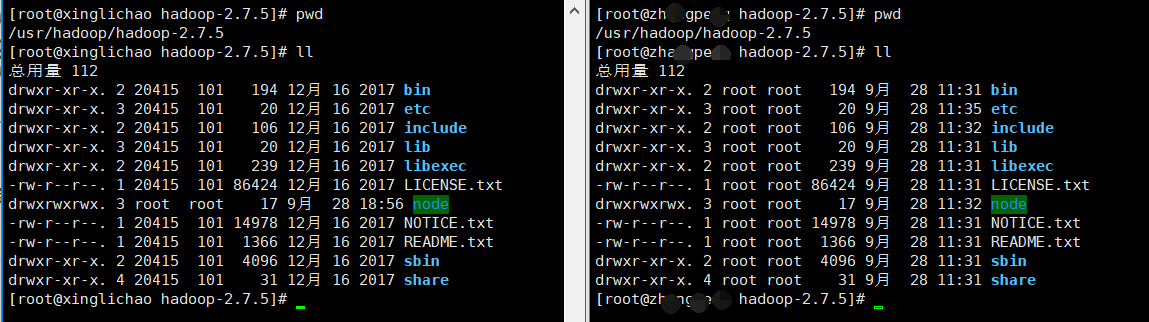
分发hadoop到其他slaves主机
scp -r /etc/hadoop/hadoop-2.7.5 root@****:/etc/hadoop/
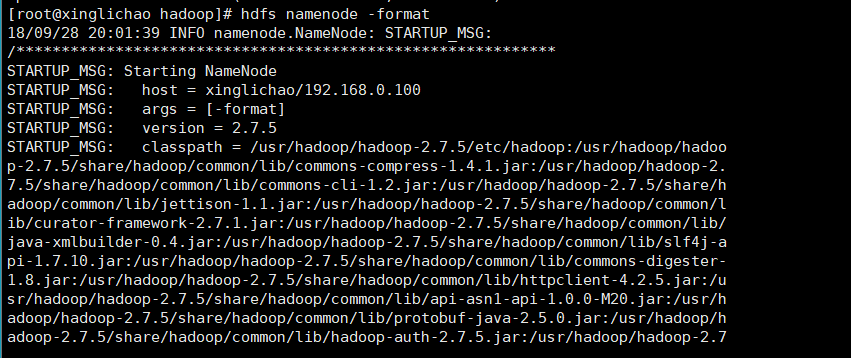
在master上格式化文件系统
hdfs namenode -format
此时出现问题:找不到java
/usr/hadoop/hadoop-2.7.5/bin/hdfs:行304: /usr/lib/jvm/java-1.8.0-openjdk-1.8.0.161-2.b14.el7.x86_64/bin/java: 没有那个文件或目录
再查看下java的安装路径
发现:原来是在上一路径下的jre文件夹下
/usr/lib/jvm/java-1.8.0-openjdk-1.8.0.161-2.b14.el7.x86_64/jre/bin/java
修改hadoop中hadoop-env.sh
在JAVA_HOME后添加 /jre (注:此处的路径与上面的不同,理由在下面)

另外:
当我执行 jps命令查看节点运行状态时发现jps不是内部命令,于是更新了java
yum install java-1.8.0-openjdk-devel.x86_64
上图的路径是已经配置了新版本的java路径后的文件
再次格式化文件系统:hdfs namenode -formate
jps一下,至此算是成功了

后续的使用就是创建工程文件夹,上传文件到HDFS,写MapReduce,执行代码(参考:hadoop单机伪分布式与真分布式系统下运行MR代码)
本节完......
[过程记录]Centos7 下 Hadoop分布式集群搭建的更多相关文章
- Centos 7下Hadoop分布式集群搭建
一.关闭防火墙(直接用root用户) #关闭防火墙 sudo systemctl stop firewalld.service #关闭开机启动 sudo systemctl disable firew ...
- Hadoop分布式集群搭建
layout: "post" title: "Hadoop分布式集群搭建" date: "2017-08-17 10:23" catalog ...
- Hadoop分布式集群搭建hadoop2.6+Ubuntu16.04
前段时间搭建Hadoop分布式集群,踩了不少坑,网上很多资料都写得不够详细,对于新手来说搭建起来会遇到很多问题.以下是自己根据搭建Hadoop分布式集群的经验希望给新手一些帮助.当然,建议先把HDFS ...
- hadoop分布式集群搭建前期准备(centos7)
那玩大数据,想做个大数据的从业者,必须了解在生产环境下搭建集群哇?由于hadoop是apache上的开源项目,所以版本有些混乱,听说都在用Cloudera的cdh5来弄?后续研究这个吧,就算这样搭建不 ...
- Hadoop框架:单服务下伪分布式集群搭建
本文源码:GitHub·点这里 || GitEE·点这里 一.基础环境 1.环境版本 环境:centos7 hadoop版本:2.7.2 jdk版本:1.8 2.Hadoop目录结构 bin目录:存放 ...
- hadoop分布式集群搭建(2.9.1)
1.环境 操作系统:ubuntu16 jdk:1.8 hadoop:2.9.1 机器:3台,master:192.168.199.88,node1:192.168.199.89,node2:192.1 ...
- Hadoop分布式集群搭建_1
Hadoop是一个开源的分布式系统框架 一.集群准备 1. 三台虚拟机,操作系统Centos7,三台主机名分别为k1,k2,k3,NAT模式 2.节点分布 k1: NameNode DataNode ...
- kettle在centos7下部署分布式集群
首先安装三台centos7 ,分别配置好静态ip ssh免密码登录 关闭防火墙 具体步骤这里不多说了 关于centos7配置静态ip大家可以参考:https://www.cnblogs. ...
- centos7下Zookeeper+sheepdog集群搭建
zookeeper 安装命令 yum install zookeeper -y (版本:zookeeper.x86_64 3.4.6-1) yum install zo ...
随机推荐
- UVAlive-7040 color(组合数学,二项式反演)
链接:vjudge 题目大意:有一排方格共 $n$ 个,现在有 $m$ 种颜色,要给这些方格染色,要求相邻两个格子的颜色不能相同.现在问恰好用了 $k$ 种颜色的合法方案数.答案对 $10^9+7$ ...
- k8s role
转 https://blog.qikqiak.com/post/add-authorization-for-kubernetes-dashboard/ 另外还可以参考这个 https://mrit ...
- SQL Server - 开窗函数
-- 开窗函数:在结果集的基础上进一步处理(聚合操作) SELECT * FROM dbo.Student S# Sname Sage Ssex ---------- ---------- ----- ...
- NodeJS 笔记 path模块
path 模块,本模块包含一系列处理和转换文件路径的工具集. path.normalize(path) normalize函数将不符合规范的路径经过格式化转换为标准路径,解析路径中的.与..外,还 ...
- Spark记录-Spark on mesos配置
1.安装mesos #用centos6的源yum安装 # rpm -Uvh http://repos.mesosphere.io/el/6/noarch/RPMS/mesosphere-el-repo ...
- SQL记录-PLSQL记录
PL/SQL记录 PL/SQL记录就是可以容纳不同类型的数据项的数据结构.记录由不同字段,类似于数据库表的行. 例如,要保留跟踪图书馆中的书籍.可能要跟踪有关每本书下面的属性类似:标题,作者,主题 ...
- HttpClient与HttpUrlConnection下载速度比较
Android有两套http的API,刚开始使用网络编程时多少有些迷惑到底用哪个好呢?其实孰优孰劣无需再争论,google已经指出HttpUrlConnection是Android更优的选择,并在SD ...
- FPGA学习笔记. DDS
DDS原理 直接数字式频率合成器(Direct Digital Synthesizer) 频率计算公式 Fout = FW * Fclk / 2^N Fout 输出频率, Fw 频率控制字, N 位数 ...
- Nessus+Metasploit
1.环境 受害者IP:10.0.0.6 2.攻击 首先使用Nessus进行扫描 扫描结果 我们将结果导出来,然后导入msfconsole中 使用vulns进行漏洞分析 查找对应的漏洞 使用漏洞进行攻击 ...
- word技巧
1.插入注解(脚注和尾注) 2.复制的图片显示不全怎么办? 横向显示,或者图片另存为然后保存为PPT 3.word修订标记的添加和删除(最终版) 4.word中表格样式调整 5.修改标题的样式和标题的 ...