
Spark核心组件通识概览
在说Spark之前,笔者在这里向对Spark感兴趣的小伙伴们建议,想要了解、学习、使用好Spark,Spark的官网是一个很好的工具,几乎能满足你大部分需求。同时,建议学习一下scala语言,主要基于两点:1. Spark是scala语言编写的,要想学好Spark必须研读分析它的源码,当然其他技术也不例外;2. 用scala语言编写Spark程序相对于用Java更方便、简洁、开发效率更高(后续我会针对scala语言做单独讲解)。书归正传,下面整体介绍一下Spark生态圈。
Apache Spark是一种快速、通用、可扩展、可容错的、基于内存迭代计算的大数据分析引擎。首先强调一点, Spark目前是一个处理数据的计算引擎, 不做存储。首先咱们通过一张图来看看目前Spark生态圈都包括哪些核心组件:
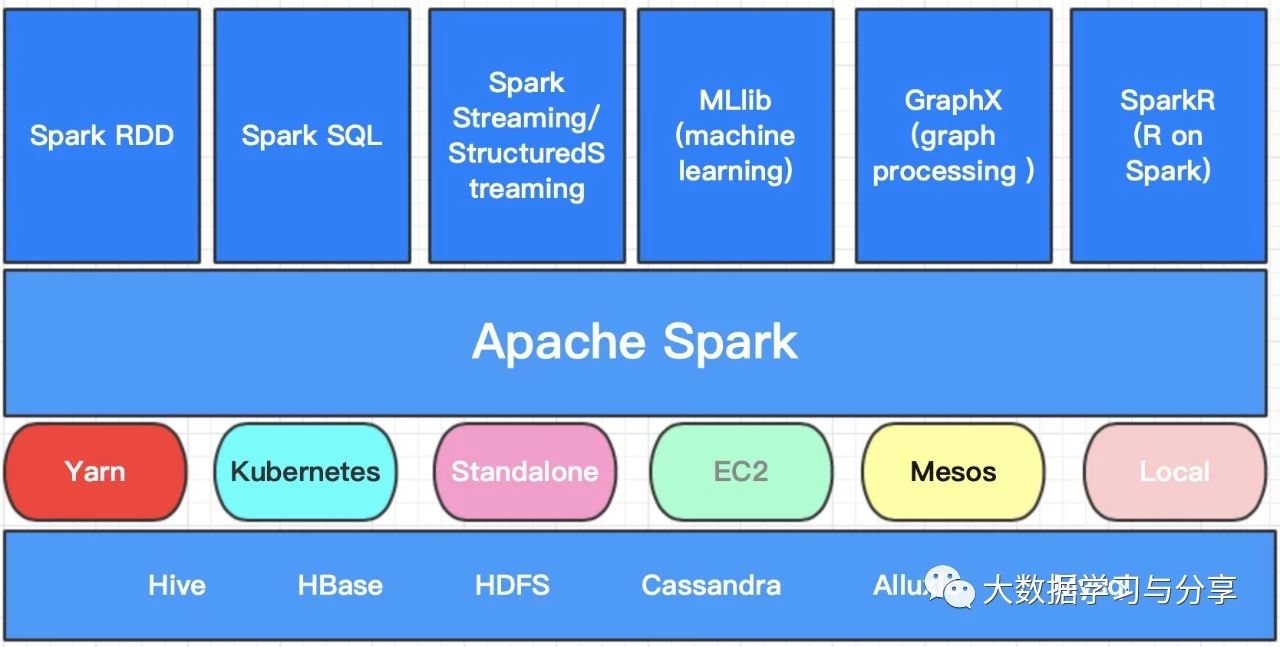
本篇文章先简单介绍一下各个组件的使用场景,后续笔者会单独详解其中的核心组件,以下所讲均基于Spark2.X版本。
Spark RDD和Spark SQL
Spark RDD和Spark SQL多用于离线场景,但Spark RDD即可以处理结构化数据也可以处理非结构数据,但Spark SQL是处理结构化数据的,内部通过dataset来处理分布式数据集
SparkStreaming和StructuredStreaming
用于流式处理,但强调一点Spark Streaming是基于微批处理来处理数据的,即使Structured Streaming在实时方面作了一定优化,但就目前而言,相对于Flink、Storm,Spark的流式处理准备确实准实时处理
MLlib
用于机器学习,当然pyspark也有应用是基于python做数据处理
GraphX
用于图计算
Spark R
基于R语言进行数据处理、统计分析的
下面介绍一下Spark的特性
快
实现DAG执行引擎,基于内存迭代式计算处理数据,Spark可以将数据分析过程的中间结果保存在内存中,从而不需要反复的从外部存储系统中读写数据,相较于mapreduce能更好地适用于机器学习和数据挖掘和等需要迭代运算的场景。易用
支持scala、java、python、R多种语言;支持多种高级算子(目前有80多种),使用户可以快速构建不同应用;支持scala、python等shell交互式查询通用
Spark强调一站式解决方案,集批处理、流处理、交互式查询、机器学习及图计算于一体,避免多种运算场景下需要部署不同集群带来的资源浪费容错性好
在分布式数据集计算时通过checkpoint来实现容错,当某个运算环节失败时,不需要从头开始重新计算【往往是checkpoint到HDFS上】兼容性强
可以运行在Yarn、Kubernetes、Mesos等资源管理器上,实现Standalone模式作为内置资源管理调度器,支持多种数据源
关注微信公众号:大数据学习与分享,获取更多技术干货
Spark核心组件通识概览的更多相关文章
- [Spark Core] Spark 核心组件
0. 说明 [Spark 核心组件示意图] 1. RDD resilient distributed dataset , 弹性数据集 轻量级的数据集合,逻辑上的集合.等价于 list 没有携带数据. ...
- Spark核心组件
Spark核心组件 1.RDD resilient distributed dataset, 弹性分布式数据集.逻辑上的组件,是spark的基本抽象,代表不可变,分区化的元素集合,可以进行并行操作.该 ...
- 【原】Spark Rpc通信源码分析
Spark 1.6+推出了以RPCEnv.RPCEndpoint.RPCEndpointRef为核心的新型架构下的RPC通信方式.其具体实现有Akka和Netty两种方式,Akka是基于Scala的A ...
- 前端进阶笔记(一)---JS语言通识
一.语言按照语法分类 1.非形式语言:中文 英文 2.形式语言:乔姆斯基谱系(四种文法 上下文包含文法) 0型 无限制文法 1型 上下文相关文法 2型 上下文无关文法 正则文法 二 产生式(BNF) ...
- linux通识
linux是服务器应用领域的开源且免费的多用户多任务操作系统的内核. 以下是对上述论断的解释: 操作系统 简言之,操作系统乃是所有计算设备的大管家,小到智能手表,大到航天航空设备,所有需要操控硬件的地 ...
- java IO流体系--通识篇
1.I/O流是什么 Java的I/O流是实现编程语言的输入/输出的基础能力,操作的对象有外部设备.存储设备.网络连接等等,是所有服务器端的编程语言都应该具备的基础能力. I = Input(输入),输 ...
- Spark内核| 调度策略| SparkShuffle| 内存管理| 内存空间分配| 核心组件
1. 调度策略 TaskScheduler会先把DAGScheduler给过来的TaskSet封装成TaskSetManager扔到任务队列里,然后再从任务队列里按照一定的规则把它们取出来在Sched ...
- 《大数据Spark企业级实战 》
基本信息 作者: Spark亚太研究院 王家林 丛书名:决胜大数据时代Spark全系列书籍 出版社:电子工业出版社 ISBN:9787121247446 上架时间:2015-1-6 出版日期:20 ...
- 【大数据】Spark内核解析
1. Spark 内核概述 Spark内核泛指Spark的核心运行机制,包括Spark核心组件的运行机制.Spark任务调度机制.Spark内存管理机制.Spark核心功能的运行原理等,熟练掌握Spa ...
随机推荐
- Linux:crond(crontab)定时任务
一..定义 Crond 是linux系统中用来定期执行命令或指定程序任务的一种服务或者软件.一般在安装完系统时,crond会默认存在. crond默认每分钟会检查系统中是否有需要执行的定时任务.如果有 ...
- oracle之三rman 不完全恢复
rman 不完全恢复 9.1 rman 不完全恢复的三个标准模式:基于time.基于scn和基于sequence: 范例1:恢复过去某个时间点误操作,一般使用基于time或scn. 1)环境:有一套全 ...
- 如何创建本地git分支到远程
创建本地分支到远程: 1.$git init 之后创建的本地仓库默认master分支 如果现在就要$ git branch 查看当前分支,是不显示任何分支的,只有在add,commit文件之后才显示, ...
- JVM强引用、软引用、弱引用、虚引用、终结器引用垃圾回收行为总结
JVM引用 我们希望能描述这样一类对象: 当内存空间还足够时,则能保留在内存中:如果内存空间在进行垃圾收集后还是很紧张,则可以抛弃这些对象. -[既偏门又非常高频的面试题]强引用.软引用.弱引用.虚引 ...
- 解决vue侧边栏一级菜单问题
最近我在学习vue,然后遇到一个问题,就是跟着视频里面的代码敲,出现了一些不好解决的问题 这是两个一级目录,我遇到的问题就是点击第一个一级目录,另外一个一级目录也会展开, 前端代码是这样的,和视频里面 ...
- 深入了解Redis(5)-内存回收
了解redis内存回收之前,需要先了解过期键删除策略. 过期键删除策略 1.定时删除 在设置键的过期时间的同时,创建一个timer,在定时器在键的过期时间到达时,立即执行对键的删除操作.内存友好型策略 ...
- 立下flag!
从今日(2020年6月29日)开始,直到两个月的暑假结束2020年8月31日,每天vp一场div3,至少要ac4道题目.
- 刷题[BJDCTF 2nd]简单注入
解题思路 打开发现登陆框,随机输入一些,发现有waf,然后回显都是同样的字符串.fuzz一波,发现禁了挺多东西的. select union 等 这里猜测是布尔盲注,错误的话显示的是:You konw ...
- 有没有异常处理翻车过的,绩效还被打了C
絮叨 因为程序异常处理问题,就在前几天龙叔的服务挂了几秒钟. 完了,马上季度末打绩效,竟然在这里翻车了,心如刀绞啊. 虽然没有影响到用户体验,但是找到问题并解决掉问题是工程师日常追求之一. 作为一个优 ...
- Kubernetes客户端和管理界面大集合
今天给大家介绍目前市面上常用的kubernetes管理工具,总有一款适合您~~~ 简介 Kubectl K9s Kubernetes-Dashboard Rancher Kuboard Lens Oc ...