
用scrapy框架爬取映客直播用户头像
1. 创建项目 scrapy startproject yingke cd yingke
2. 创建爬虫 scrapy genspider live
3. 分析http://www.inke.cn/hotlive_list.html网页的response,找到响应里面数据的规律,并找到的位置,通过response.xpath()获取到
4. 通过在pipline里面进行数据的清洗,过滤,保存
5. 实现翻页,进行下一页的请求处理
6. 运行爬虫 scrapy crawl live
说明:这个程序直接在parse方法里面进行图片保存,保存在本地,正常使用yield关键字进行在pipline中保存。
# -*- coding: utf-8 -*-

import scrapy

import re

class LiveSpider(scrapy.Spider):

    name = 'live'

    allowed_domains = ['inke.cn']

    start_urls = ['http://www.inke.cn/hotlive_list.html?page=1']

    def parse(self, response):

        div_list = response.xpath("//div[@class='list_box']")

        for div in div_list:

            item = {}

            img_src = div.xpath("./div[@class='list_pic']/a/img/@src").extract_first()

            item["user_name"] = div.xpath(

                "./div[@class='list_user_info']/span[@class='list_user_name']/text()").extract_first()

            print(item["user_name"])

            yield scrapy.Request(  # 发送详情页的请求

                img_src,

                callback=self.parse_img,

                meta={"item": item}

            )

        # 下一页

        now_page = re.findall("page=(.*)", response.request.url)[0]

        now_page= int(now_page)

        next_url = "http://www.inke.cn/hotlive_list.html?page={}".format(str(now_page+ 1))

        yield scrapy.Request(

            next_url,

            callback=self.parse

        )

    def parse_img(self, response):

        user_name = response.meta["item"]["user_name"]

        with open("images/{}.png".format(user_name), "wb") as f:

            f.write(response.body)
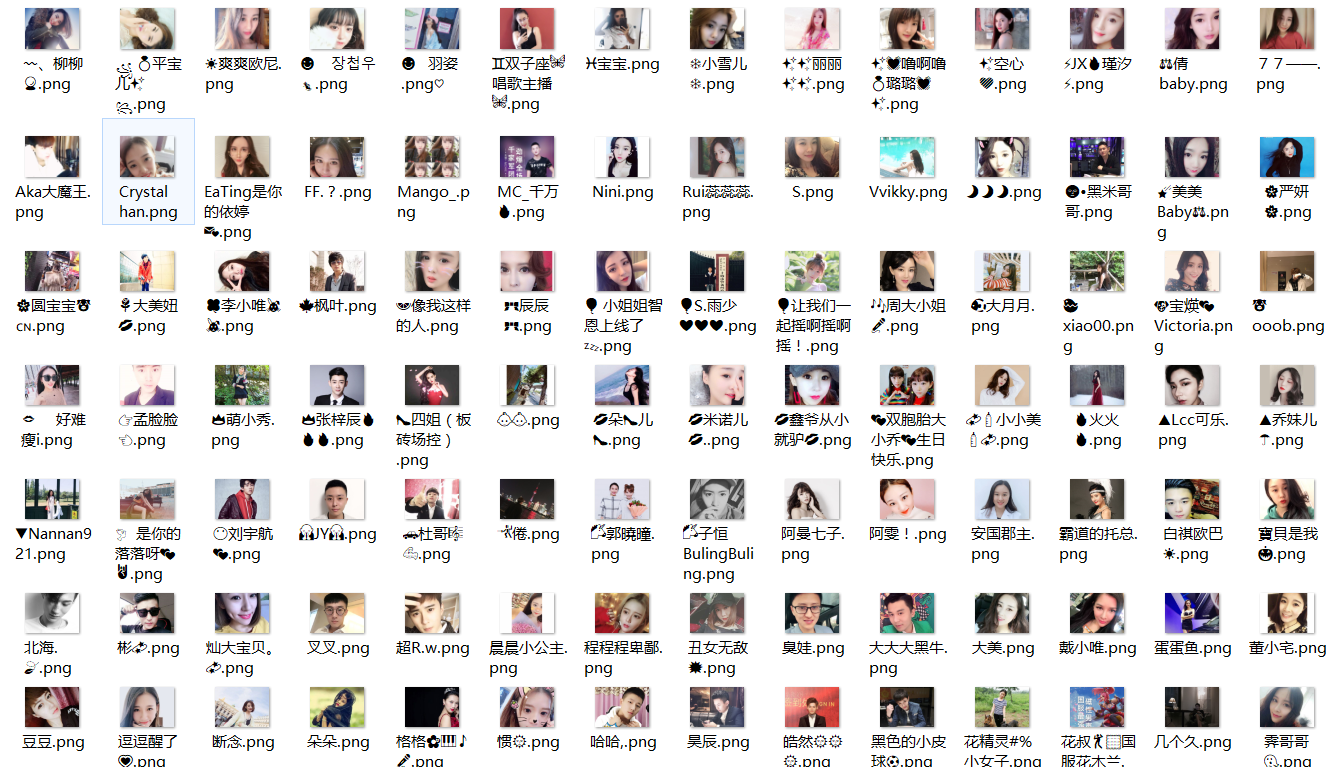
运行效果:
用scrapy框架爬取映客直播用户头像的更多相关文章
- 使用scrapy框架爬取自己的博文(2)
之前写了一篇用scrapy框架爬取自己博文的博客,后来发现对于中文的处理一直有问题- - 显示的时候 [u'python\u4e0b\u722c\u67d0\u4e2a\u7f51\u9875\u76 ...
- 使用scrapy框架爬取自己的博文
scrapy框架是个比较简单易用基于python的爬虫框架,http://scrapy-chs.readthedocs.org/zh_CN/latest/ 这个是不错的中文文档 几个比较重要的部分: ...
- scrapy框架爬取笔趣阁完整版
继续上一篇,这一次的爬取了小说内容 pipelines.py import csv class ScrapytestPipeline(object): # 爬虫文件中提取数据的方法每yield一次it ...
- scrapy框架爬取笔趣阁
笔趣阁是很好爬的网站了,这里简单爬取了全部小说链接和每本的全部章节链接,还想爬取章节内容在biquge.py里在加一个爬取循环,在pipelines.py添加保存函数即可 1 创建一个scrapy项目 ...
- 使用scrapy框架爬取自己的博文(3)
既然如此,何不再抓一抓网页的文字内容呢? 谷歌浏览器有个审查元素的功能,就是按树的结构查看html的组织形式,如图: 这样已经比较明显了,博客的正文内容主要在div 的class = cnblogs_ ...
- Python使用Scrapy框架爬取数据存入CSV文件(Python爬虫实战4)
1. Scrapy框架 Scrapy是python下实现爬虫功能的框架,能够将数据解析.数据处理.数据存储合为一体功能的爬虫框架. 2. Scrapy安装 1. 安装依赖包 yum install g ...
- 爬虫入门(四)——Scrapy框架入门:使用Scrapy框架爬取全书网小说数据
为了入门scrapy框架,昨天写了一个爬取静态小说网站的小程序 下面我们尝试爬取全书网中网游动漫类小说的书籍信息. 一.准备阶段 明确一下爬虫页面分析的思路: 对于书籍列表页:我们需要知道打开单本书籍 ...
- 基于python的scrapy框架爬取豆瓣电影及其可视化
1.Scrapy框架介绍 主要介绍,spiders,engine,scheduler,downloader,Item pipeline scrapy常见命令如下: 对应在scrapy文件中有,自己增加 ...
- scrapy框架爬取豆瓣读书(1)
1.scrapy框架 Scrapy,Python开发的一个快速.高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据.Scrapy用途广泛,可以用于数据挖掘.监测和自动化测试 ...
随机推荐
- python之进程和线程
1 操作系统 为什么要有操作系统 ? 操作系统位于底层硬件与应用软件之间的一层 工作方式:向下管理硬件,向上提供接口 操作系统进程切换: 出现IO操作 固定时间 2 进程和线程的概念 进程就是一个程序 ...
- jeffy-vim-v3.1.tar.gz
下载链接: https://files.cnblogs.com/files/pengdonglin137/jeffy-vim-v3.1.tar.gz 1. 使用sublimemonokai配色 2. ...
- XSplit Quality, VBV-Buffer, VBV-Maxrate and Preset Settings
XSplit uses the x264 encoder, so let's start off by saying that parameters mentioned in the title, w ...
- nltk 的分词器punkt: ssl问题无法下载
报错: LookupError: ********************************************************************** Resource pu ...
- C# ExecutionContext 实现
网上关于ExecutionContext的说明比较少,我们来看看微软的描述吧, 名称 说明 Capture() 捕获从当前线程的执行上下文. CreateCopy() 创建当前执行上下文的副本. ...
- VUE温习:style层次分析
一.vue样式style层次分析 1.样式可以在main.js.模块js文件.组件style.组件script标签内,index.html文件内引入,不同位置引入的样式有什么关系. 2.总结: (1) ...
- fontawesome图标字体库组件在服务器上显示不出来图标的解决
这个组件在我所开发的网站中被大量使用,为网站增色不少.在本地测试的时候所有图标都能显示出来,可一到服务器上就显示不出来了.网上查列出了可能的原因.其一,IIS没有注册字体类型.经过检查,不存在这个问题 ...
- linux平台下Tomcat的安装与优化
Tomcat 服务器是一个免费的开放源代码的Web 应用服务器,属于轻量级应用服务器,在中小型系统和并发访问用户不是很多的场合下被普遍使用,是开发和调试JSP 程序的首选.对于一个初学者来说,可以这样 ...
- 【T09】要认识到TCP是一个可靠的,但不是绝对可靠的协议
1.稍微想一下就知道,TCP不是绝对可靠的协议,比如:网络断开,主机崩溃,无论TCP如何努力,都无法将数据传给对方. 2.考虑应用程序A向应用程序B发送数据的TCP流程,数据流从应用程序A通过他所在主 ...
- git强制修改注释
在一些公司项目中,常常要求git注释提交的时候加上前缀,比如JIRA号,但是有的时候我们常常会忘了 如果用source tree等一些工具,会推送到本地仓库一半,但远程又上不去. 这个时候我们就需要强 ...