
Hadoop详解(06) - Yarn平台架构和资源调度器
Hadoop详解(06) - Yarn平台架构和资源调度器
Yarn平台架构
Yarn是一个资源调度平台,负责为运算程序提供服务器运算资源,相当于一个分布式的操作系统平台,而MapReduce等运算程序则相当于运行于操作系统之上的应用程序。
Yarn基本架构
YARN主要由ResourceManager、NodeManager、ApplicationMaster和Container等组件构成。
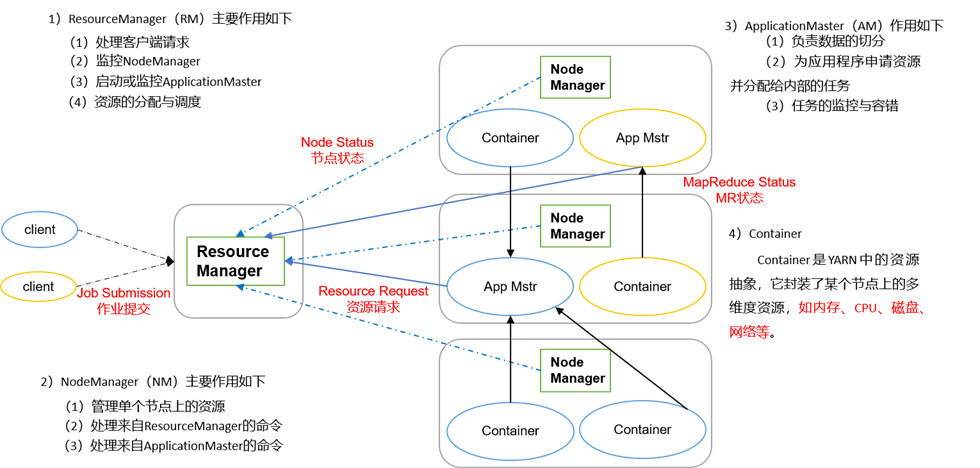
Yarn工作机制

(1)MR程序提交到客户端所在的节点。
(2)YarnRunner向ResourceManager申请一个Application。
(3)RM将该应用程序的资源路径返回给YarnRunner。
(4)该程序将运行所需资源提交到HDFS上。
(5)程序资源提交完毕后,申请运行mrAppMaster。
(6)RM将用户的请求初始化成一个Task。
(7)其中一个NodeManager领取到Task任务。
(8)该NodeManager创建容器Container,并产生MRAppmaster。
(9)Container从HDFS上拷贝资源到本地。
(10)MRAppmaster向RM 申请运行MapTask资源。
(11)RM将运行MapTask任务分配给另外两个NodeManager,另两个NodeManager分别领取任务并创建容器。
(12)MR向两个接收到任务的NodeManager发送程序启动脚本,这两个NodeManager分别启动MapTask,MapTask对数据分区排序。
(13)MrAppMaster等待所有MapTask运行完毕后,向RM申请容器,运行ReduceTask。
(14)ReduceTask向MapTask获取相应分区的数据。
(15)程序运行完毕后,MR会向RM申请注销自己。
作业提交全过程
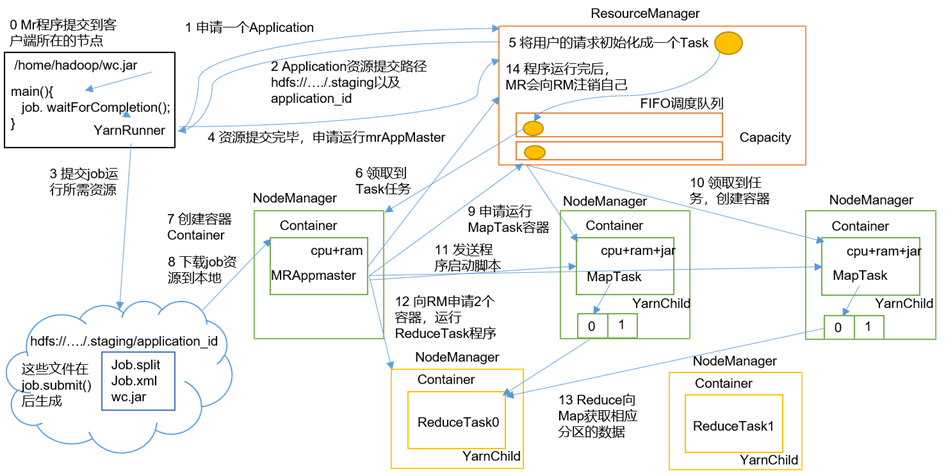
作业提交全过程详解
(1)作业提交
第1步:Client调用job.waitForCompletion方法,向整个集群提交MapReduce作业。
第2步:Client向RM申请一个作业id。
第3步:RM给Client返回该job资源的提交路径和作业id。
第4步:Client提交jar包、切片信息和配置文件到指定的资源提交路径。
第5步:Client提交完资源后,向RM申请运行MrAppMaster。
(2)作业初始化
第6步:当RM收到Client的请求后,将该job添加到容量调度器中。
第7步:某一个空闲的NM领取到该Job。
第8步:该NM创建Container,并产生MRAppmaster。
第9步:下载Client提交的资源到本地。
(3)任务分配
第10步:MrAppMaster向RM申请运行多个MapTask任务资源。
第11步:RM将运行MapTask任务分配给另外两个NodeManager,另两个NodeManager分别领取任务并创建容器。
(4)任务运行
第12步:MR向两个接收到任务的NodeManager发送程序启动脚本,这两个NodeManager分别启动MapTask,MapTask对数据分区排序。
第13步:MrAppMaster等待所有MapTask运行完毕后,向RM申请容器,运行ReduceTask。
第14步:ReduceTask向MapTask获取相应分区的数据。
第15步:程序运行完毕后,MR会向RM申请注销自己。
(5)进度和状态更新
YARN中的任务将其进度和状态(包括counter)返回给应用管理器, 客户端每秒(通过mapreduce.client.progressmonitor.pollinterval设置)向应用管理器请求进度更新, 展示给用户。
(6)作业完成
除了向应用管理器请求作业进度外, 客户端每5秒都会通过调用waitForCompletion()来检查作业是否完成。时间间隔可以通过mapreduce.client.completion.pollinterval来设置。作业完成之后, 应用管理器和Container会清理工作状态。作业的信息会被作业历史服务器存储以备之后用户核查。
作业提交过程之MapReduce
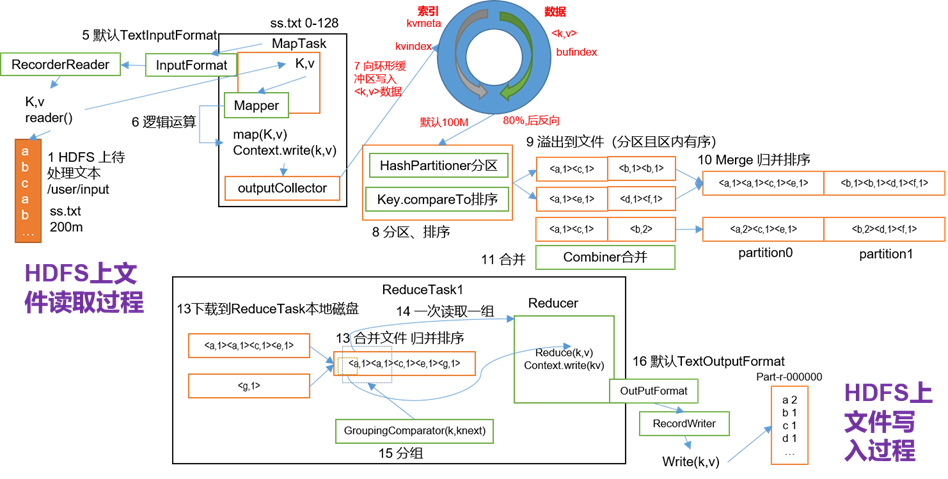
资源调度器
目前,Hadoop作业调度器主要有三种:FIFO、Capacity Scheduler和Fair Scheduler。Hadoop3.1.3默认的资源调度器是Capacity Scheduler。
具体设置详见:yarn-default.xml文件
<property>
<description>The class to use as the resource scheduler.</description>
<name>yarn.resourcemanager.scheduler.class</name>
<value>org.apache.hadoop.yarn.server.resourcemanager.scheduler.capacity.CapacityScheduler</value>
</property>
先进先出调度器(FIFO)
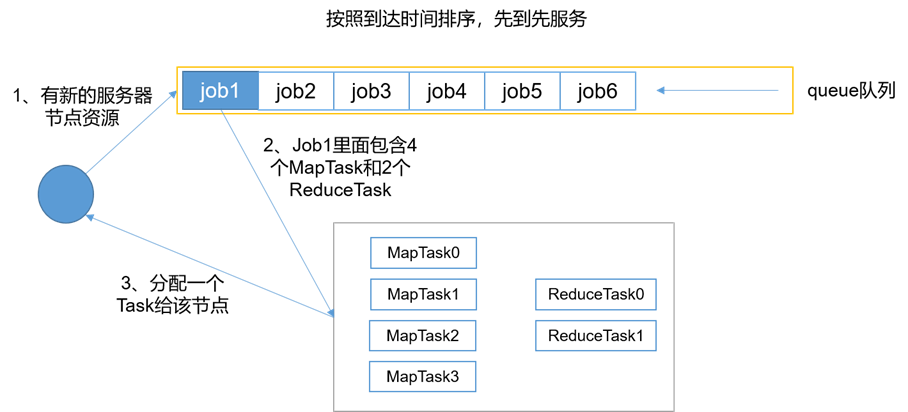
Hadoop最初设计目的是支持大数据批处理作业,如日志挖掘、Web索引等作业,为此,Hadoop仅提供了一个非常简单的调度机制:FIFO,即先来先服务,在该调度机制下,所有作业被统一提交到一个队列中,Hadoop按照提交顺序依次运行这些作业。但随着Hadoop的普及,单个Hadoop集群的用户量越来越大,不同用户提交的应用程序往往具有不同的服务质量要求,典型的应用有以下几种:
批处理作业:这种作业往往耗时较长,对时间完成一般没有严格要求,如数据挖掘、机器学习等方面的应用程序。
交互式作业:这种作业期望能及时返回结果,如SQL查询(Hive)等。
生产性作业:这种作业要求有一定量的资源保证,如统计值计算、垃圾数据分析等。
此外,这些应用程序对硬件资源需求量也是不同的,如过滤、统计类作业一般为CPU密集型作业,而数据挖掘、机器学习作业一般为I/O密集型作业。因此,简单的FIFO调度策略不仅不能满足多样化需求,也不能充分利用硬件资源。
容量调度器(Capacity Scheduler)
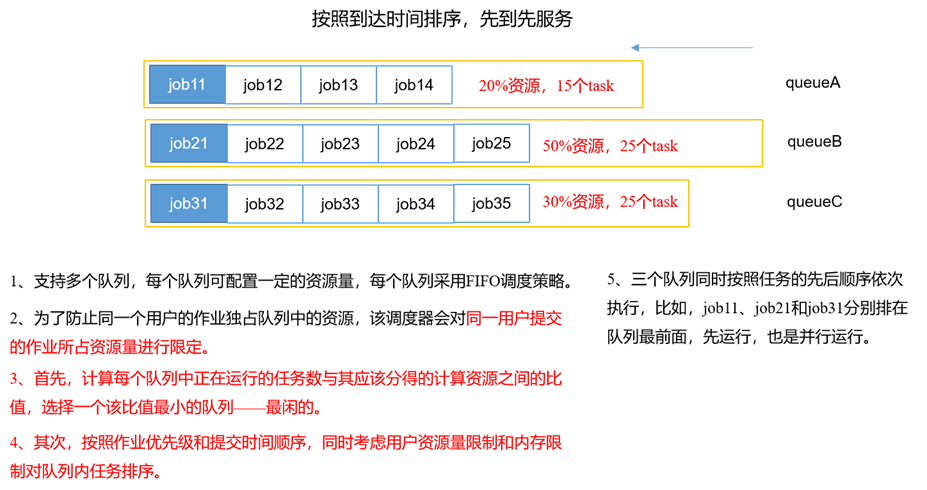
Capacity Scheduler Capacity Scheduler 是Yahoo开发的多用户调度器,它以队列为单位划分资源,每个队列可设定一定比例的资源最低保证和使用上限,同时,每个用户也可设定一定的资源使用上限以防止资源滥用。而当一个队列的资源有剩余时,可暂时将剩余资源共享给其他队列。Capacity Scheduler 主要有以下几个特点:
- 容量保证。管理员可为每个队列设置资源最低保证和资源使用上限,而所有提交到该队列的应用程序共享这些资源。
- 灵活性,如果一个队列中的资源有剩余,可以暂时共享给那些需要资源的队列,而一旦该队列有新的应用程序提交,则其他队列借调的资源会归还给该队列。这种资源灵活分配的方式可明显提高资源利用率。
- 多重租赁。支持多用户共享集群和多应用程序同时运行。为防止单个应用程序、用户或者队列独占集群中的资源,管理员可为之增加多重约束(比如单个应用程序同时运行的任务数等)。
- 安全保证。每个队列有严格的ACL列表规定它的访问用户,每个用户可指定哪些用户允许查看自己应用程序的运行状态或者控制应用程序(比如杀死应用程序)。此外,管理员可指定队列管理员和集群系统管理员。
- 动态更新配置文件。管理员可根据需要动态修改各种配置参数,以实现在线集群管理。
公平调度器(Fair Scheduler)(了解)
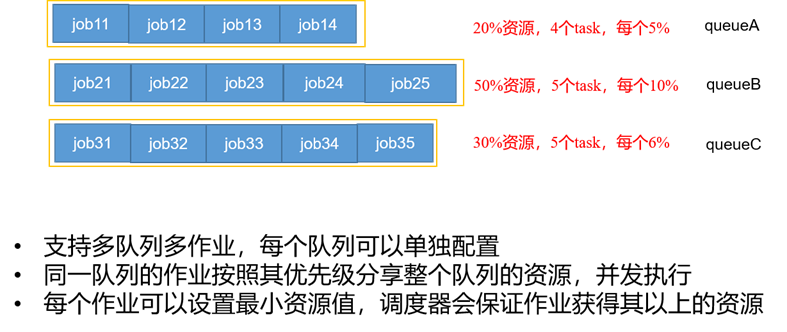
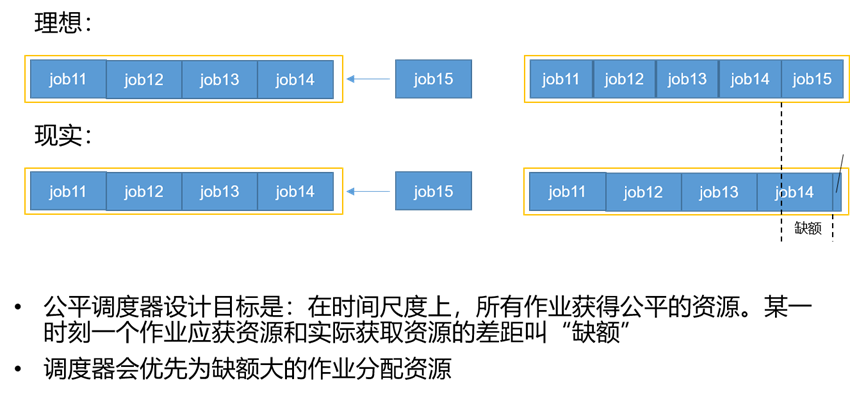
Fair Scheduler Fair Schedulere是Facebook开发的多用户调度器。
公平调度器的目的是让所有的作业随着时间的推移,都能平均地获取等同的共享资源。当有作业提交上来,系统会将空闲的资源分配给新的作业,每个任务大致上会获取平等数量的资源。和传统的调度策略不同的是它会让小的任务在合理的时间完成,同时不会让需要长时间运行的耗费大量资源的任务挨饿!
同Capacity Scheduler类似,它以队列为单位划分资源,每个队列可设定一定比例的资源最低保证和使用上限,同时,每个用户也可设定一定的资源使用上限以防止资源滥用;当一个队列的资源有剩余时,可暂时将剩余资源共享给其他队列。
当然,Fair Scheduler也存在很多与Capacity Scheduler不同之处,这主要体现在以下几个方面:
- 资源公平共享。在每个队列中,Fair Scheduler 可选择按照FIFO、Fair或DRF策略为应用程序分配资源。其中,
FIFO策略
公平调度器每个队列资源分配策略如果选择FIFO的话,就是禁用掉每个队列中的Task共享队列资源,此时公平调度器相当于上面讲过的容量调度器。
Fair策略
Fair 策略(默认)是一种基于最大最小公平算法实现的资源多路复用方式,默认情况下,每个队列内部采用该方式分配资源。这意味着,如果一个队列中有两个应用程序同时运行,则每个应用程序可得到1/2的资源;如果三个应用程序同时运行,则每个应用程序可得到1/3的资源。
【扩展:】最大最小公平算法举例:
不加权(关注点是job的个数):
有一条队列总资源12个, 有4个job,对资源的需求分别是:
job1->1, job2->2 , job3->6, job4->5
第一次算: 12 / 4 = 3
job1: 分3 --> 多2个
job2: 分3 --> 多1个
job3: 分3 --> 差3个
job4: 分3 --> 差2个
第二次算: 3 / 2 = 1.5
job1: 分1
job2: 分2
job3: 分3 --> 差3个 --> 分1.5 --> 最终: 4.5
job4: 分3 --> 差2个 --> 分1.5 --> 最终: 4.5
第n次算: 一直算到没有空闲资源
加权(关注点是job的权重):
有一条队列总资源16,有4个job
对资源的需求分别是: job1->4 job2->2 job3->10 job4->4
每个job的权重为: job1->5 job2->8 job3->1 job4->2
第一次算: 16 / (5+8+1+2) = 1
job1: 分5 --> 多1
job2: 分8 --> 多6
job3: 分1 --> 少9
job4: 分2 --> 少2
第二次算: 7 / (1+2) = 7/3
job1: 分4
job2: 分2
job3: 分1 --> 分7/3 --> 少
job4: 分2 --> 分14/3(4.66) -->多2.66
第三次算:
job1: 分4
job2: 分2
job3: 分1 --> 分7/3 --> 分2.66
job4: 分4
第n次算: 一直算到没有空闲资源
DRF策略
DRF(Dominant Resource Fairness),我们之前说的资源,都是单一标准,例如只考虑内存(也是yarn默认的情况)。但是很多时候我们资源有很多种,例如内存,CPU,网络带宽等,这样我们很难衡量两个应用应该分配的资源比例。
那么在YARN中,我们用DRF来决定如何调度:假设集群一共有100 CPU和10T 内存,而应用A需要(2 CPU, 300GB),应用B需要(6 CPU, 100GB)。则两个应用分别需要A(2%CPU, 3%内存)和B(6%CPU, 1%内存)的资源,这就意味着A是内存主导的, B是CPU主导的,针对这种情况,我们可以选择DRF策略对不同应用进行不同资源(CPU和内存)的一个不同比例的限制。
- 支持资源抢占。当某个队列中有剩余资源时,调度器会将这些资源共享给其他队列,而当该队列中有新的应用程序提交时,调度器要为它回收资源。为了尽可能降低不必要的计算浪费,调度器采用了先等待再强制回收的策略,即如果等待一段时间后尚有未归还的资源,则会进行资源抢占:从那些超额使用资源的队列中杀死一部分任务,进而释放资源。
yarn.scheduler.fair.preemption=true 通过该配置开启资源抢占。
- 提高小应用程序响应时间。由于采用了最大最小公平算法,小作业可以快速获取资源并运行完成
容量调度器多队列提交案例
- 需求:
Yarn默认的容量调度器是一条单队列的调度器,在实际使用中会出现单个任务阻塞整个队列的情况。同时,随着业务的增长,公司需要分业务限制集群使用率。这就需要我们按照业务种类配置多条任务队列。
- 配置多队列的容量调度器:
默认Yarn的配置下,容量调度器只有一条Default队列。在capacity-scheduler.xml中可以配置多条队列,并降低default队列资源占比:
<!-- 指定多队列,增加hive队列 -->
<property>
<name>yarn.scheduler.capacity.root.queues</name>
<value>default,hive</value>
<description>
The queues at the this level (root is the root queue).
</description>
</property>
<!-- 降低default队列资源额定容量为40%,默认100% -->
<property>
<name>yarn.scheduler.capacity.root.default.capacity</name>
<value>40</value>
</property>
<!-- 降低default队列资源最大容量为60%,默认100% -->
<property>
<name>yarn.scheduler.capacity.root.default.maximum-capacity</name>
<value>60</value>
</property>
同时为新加队列添加必要属性:
<!-- 指定hive队列的资源额定容量 -->
<property>
<name>yarn.scheduler.capacity.root.hive.capacity</name>
<value>60</value>
</property>
<property>
<name>yarn.scheduler.capacity.root.hive.user-limit-factor</name>
<value>1</value>
</property>
<!-- 指定hive队列的资源最大容量 -->
<property>
<name>yarn.scheduler.capacity.root.hive.maximum-capacity</name>
<value></value>
</property>
<property>
<name>yarn.scheduler.capacity.root.hive.state</name>
<value>RUNNING</value>
</property>
<property>
<name>yarn.scheduler.capacity.root.hive.acl_submit_applications</name>
<value>*</value>
</property>
<property>
<name>yarn.scheduler.capacity.root.hive.acl_administer_queue</name>
<value>*</value>
</property>
<property>
<name>yarn.scheduler.capacity.root.hive.acl_application_max_priority</name>
<value>*</value>
</property>
<property>
<name>yarn.scheduler.capacity.root.hive.maximum-application-lifetime</name>
<value>-1</value>
</property>
<property>
<name>yarn.scheduler.capacity.root.hive.default-application-lifetime</name>
<value>-1</value>
</property>
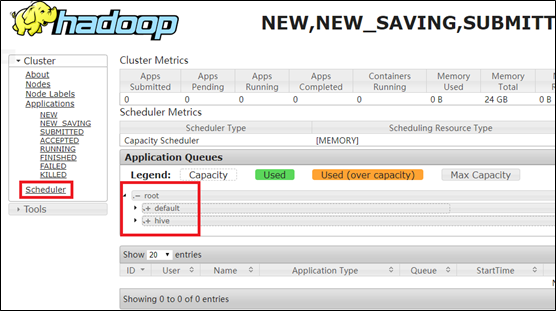
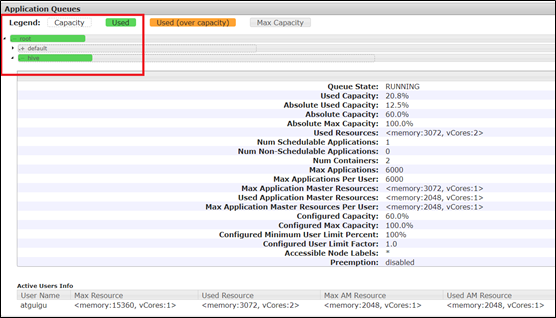
在配置完成后,重启Yarn或者执行yarn rmadmin -refreshQueues刷新队列,就可以看到两条队列:
向Hive队列提交任务
默认的任务提交都是提交到default队列的。如果希望向其他队列提交任务,需要在Driver中声明:
public class WcDrvier {
public static void main(String[] args) throws IOException, ClassNotFoundException, InterruptedException {
Configuration configuration = new Configuration();
configuration.set("mapreduce.job.queuename","hive");
//1. 获取一个Job实例
Job job = Job.getInstance(configuration);
//2. 设置类路径
job.setJarByClass(WcDrvier.class);
//3. 设置Mapper和Reducer
job.setMapperClass(WcMapper.class);
job.setReducerClass(WcReducer.class);
//4. 设置Mapper和Reducer的输出类型
job.setMapOutputKeyClass(Text.class);
job.setMapOutputValueClass(IntWritable.class);
job.setOutputKeyClass(Text.class);
job.setOutputValueClass(IntWritable.class);
job.setCombinerClass(WcReducer.class);
//5. 设置输入输出文件
FileInputFormat.setInputPaths(job, new Path(args[0]));
FileOutputFormat.setOutputPath(job, new Path(args[1]));
//6. 提交Job
boolean b = job.waitForCompletion(true);
System.exit(b ? 0 : 1);
}
}
这样,这个任务在集群提交时,就会提交到hive队列:
Hadoop详解(06) - Yarn平台架构和资源调度器的更多相关文章
- Hadoop详解(04)-Hdfs
Hadoop详解(04)-Hdfs HDFS概述 HDFS产出背景及定义 背景:随着数据量越来越大,在一个操作系统存不下所有的数据,那么就分配到更多的操作系统管理的磁盘中,但是不方便管理和维护,迫切需 ...
- Hadoop详解(02)Hadoop集群运行环境搭建
Hadoop详解(02)Hadoop集群运行环境搭建 虚拟机环境准备 虚拟机节点数:3台 操作系统版本:CentOS-7.6-x86-1810 虚拟机 内存4G,硬盘99G IP地址分配 192.16 ...
- Hadoop详解(01)-概论
Hadoop详解(01)概论 概念 大数据(Big Data):指无法在一定时间范围内用常规软件工具进行捕捉.管理和处理的数据集合,是需要新处理模式才能具有更强的决策力.洞察发现力和流程优化能力的海量 ...
- Spark详解(06) - SparkSQL
Spark详解(06) - SparkSQL Spark SQL概述 什么是Spark SQL Spark SQL是Spark用于结构化数据(Structured Data)处理的Spark模块. ( ...
- Hadoop详解(10) - Hadoop HA高可用
Hadoop详解(10) - Hadoop HA高可用 HA概述 HA(High Availablity),即高可用(7*24小时不中断服务). 实现高可用最关键的策略是消除单点故障.HA严格来说应该 ...
- Hadoop详解(09) - Hadoop新特性
Hadoop详解(09) - Hadoop新特性 Hadoop2.x新特性 远程主机之间的文件复制 scp实现两个远程主机之间的文件复制 推 push:scp -r hello.txt root@ha ...
- Hadoop详解(04-1) - 基于hadoop3.1.3配置Windows10本地开发运行环境
Hadoop详解(04-1) - 基于hadoop3.1.3配置Windows10本地开发运行环境 环境准备 安装jdk环境 安装idea 配置maven 搭建好的hadoop集群 配置hadoop ...
- Hadoop详解(03)-Hadoop编译源码-了解
Hadoop详解(03)-Hadoop编译源码-了解 准备工作 CentOS联网 配置CentOS能连接外网.Linux虚拟机ping www.baidu.com 是畅通的 jar包准备(hadoop ...
- Hive详解(06) - Hive调优实战
Hive详解(06) - Hive调优实战 执行计划(Explain) 基本语法 EXPLAIN [EXTENDED | DEPENDENCY | AUTHORIZATION] query 案例实操 ...
随机推荐
- 使用Pytorch进行多卡训练
当一块GPU不够用时,我们就需要使用多卡进行并行训练.其中多卡并行可分为数据并行和模型并行.具体区别如下图所示: 由于模型并行比较少用,这里只对数据并行进行记录.对于pytorch,有两种方式可以进行 ...
- 如何在IDEA中创建Module、以及怎样在IDEA中删除Module?
文章目录 1.为何要使用Module? 2.Module的创建 3.如何从硬盘上删除module 1.为何要使用Module? 目前主流的大型项目都是分布式部署的,结构类型这种多Module结构.不同 ...
- JavaScript基础&实战(3)js中的流程控制语句、条件分支语句、for循环、while循环
文章目录 1.流程控制语句 1.1 代码 1.2 测试结果 2.弹窗提示输入内容 2.1 代码 2.2 测试结果 3.条件分支语句 3.1 代码 3.2 测试结果 4.while和 do...whil ...
- JUC(11)各种锁的理解(公平锁、可重入锁、自旋锁、死锁)
文章目录 1.公平锁.非公平锁 2.可重入锁 3.自旋锁 4.死锁 1.公平锁.非公平锁 公平锁:非常公平.不能插队.必须先来后到 非公平锁:非常不公平.可以插队.(默认非公平) 可以修改为公平锁 2 ...
- Android 13 新特性及适配指南
Android 13(API 33)于 2022年8月15日 正式发布(发布时间较往年早了一些),正式版Release源代码也于当日被推送到AOSP Android开源项目. 截止到笔者撰写这篇文章时 ...
- maven 重复依赖不同版本 选择规则
maven 重复依赖不同版本 选择规则 本篇主要来看看 maven 对于 重复依赖的jar的不同版本时候 它内部的选择规则, 很多时候我们在搭建环境的时候 不注意就会存在依赖冲突等问题 那依赖冲突的时 ...
- 八、Django的组件
8.1.中间件 中间件顾名思义,是介于request与response处理之间的一道处理过程,相对比较轻量级,并且在全局上改变django的输入与输出.因为改变的是全局,所以需要谨慎实用,用不好会影响 ...
- 基于mnist的P-R曲线(准确率,召回率)
一.准确率,召回率 TP(True Positive):正确的正例,一个实例是正类并且也被判定成正类 FN(False Negative):错误的反例,漏报,本为正类但判定为假类 FP(False P ...
- python中的浅拷贝,深拷贝
直接引用,间接引用 # 1.列表存储的是索引对应值的内存地址,值会单独的开辟一个内存空间 list = ["a","b"] 内存里面存储的就是list[0],l ...
- mybatis-plus分页失效原因
mybatis-plus分页失效解决方法 方法一.在启动类添加如下配置 @SpringBootApplication @MapperScan("com.**.mapper") pu ...