
DBScan聚类,打破形状的限制,使用密度聚类
如何用花盆摆放成国庆字,并且包围这两个字。
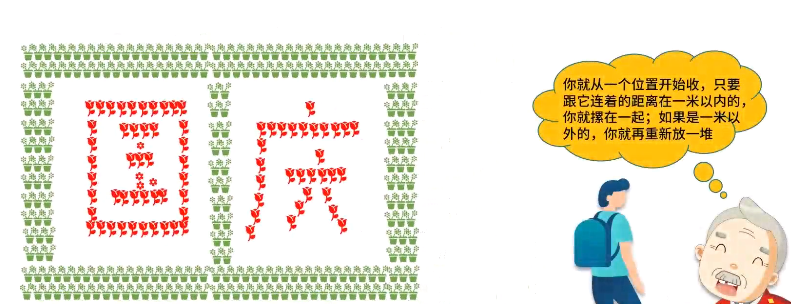
在DBSCAN中衡量密度主要使用的指标:半径、最少样本量
算法原理
*直接密度可达
如果一个点在核心对象的半径区域内,那么这个点和核心对象称为直接密度可达,比如A和B,B和C等
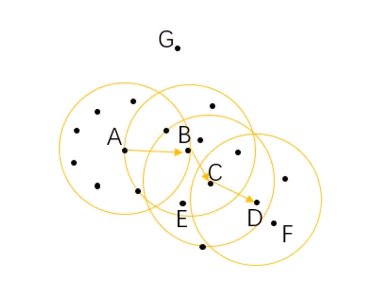
图1
*密度可达
如果有一系列点,都满足上一个点到这个点都是密度直达,那么这个系列中不相邻的点就称为密度可达,比如上图1中A和D。另外下图2也是有解释的
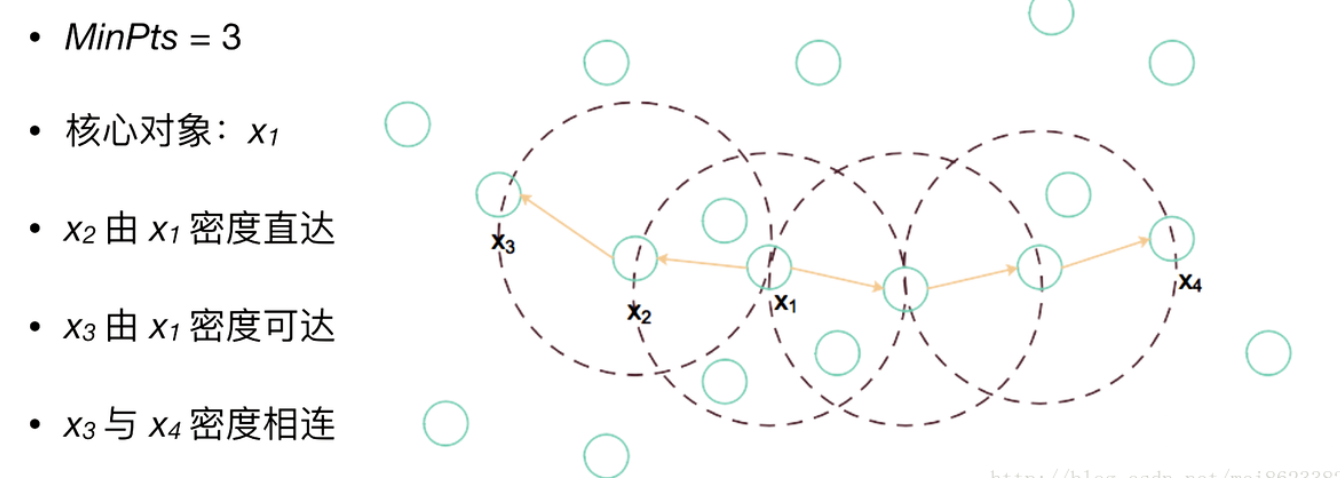
图2
*密度相连
如果通过一个核心对象出发,得到两个密度可达的点,那么这两个点称为密度相连,比如图1中E和F
经过初始化后,从整个样本集中去抽取样本点
如果这个样本点是核心对象,那么从这个点出发,找到所有密度可达的对象,构成一个簇
如果这个样本点不是核心对象,那么再重新找下一个点
算法优点
不需要划分个数(只需要计算)
可以处理噪点
可以处理任何形状的空间聚类问题
算法缺点
需要指定最小样本量和半径两个参数
数量大时开销也很大
如果样本集的密度不均匀、聚类间距差相差很大时,聚类质量比较差
from sklearn import datasets

import pandas as pd

import matplotlib.pyplot as plt

from sklearn.cluster import dbscan

#生成500个点,噪声为0.1

X,_=datasets.make_moons(500,noise=0.1,random_state=1)

df=pd.DataFrame(X,columns=['x','y'])

df.plot.scatter('x','y',s=200,alpha=0.5,c="green",title='dataset by DBSCAN')

plt.show()

生成的绿色结果
#eps为邻域半径,min_samples为最少样本量

core_samples,cluster_ids=dbscan(X,eps=0.2,min_samples=20)

#cluster_ids中-1表示对应的点为噪声

df=pd.DtaFrame(np.c_[X,cluster_ids],columns=['x','y','cluster_id'])

df['cluster_id']=df['cluster_id'].astype('i2')

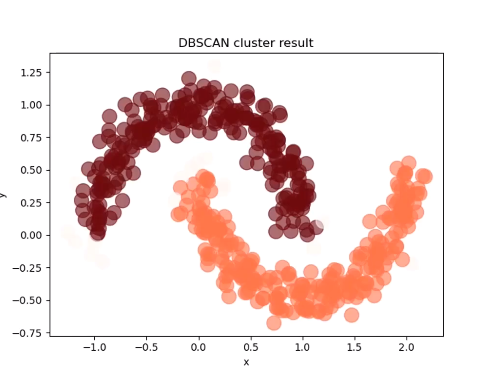
#绘制结果图像

df.plot.scatter('x','y',s=200,

c=list(df['scatter_id']),cmap='Reds',colorbar=False,

alpha=0.6,title='DBSCAN cluster result')

plt.show()
DBScan聚类,打破形状的限制,使用密度聚类的更多相关文章
- 聚类——密度聚类DBSCAN
Clustering 聚类 密度聚类——DBSCAN 前面我们已经介绍了两种聚类算法:k-means和谱聚类.今天,我们来介绍一种基于密度的聚类算法——DBSCAN,它是最经典的密度聚类算法,是很多算 ...
- DBSCAN密度聚类算法
DBSCAN(Density-Based Spatial Clustering of Applications with Noise,具有噪声的基于密度的聚类方法)是一种很典型的密度聚类算法,和K-M ...
- 基于密度聚类的DBSCAN和kmeans算法比较
根据各行业特性,人们提出了多种聚类算法,简单分为:基于层次.划分.密度.图论.网格和模型的几大类. 其中,基于密度的聚类算法以DBSCAN最具有代表性. 场景 一 假设有如下图的一组数据, 生成数据 ...
- DBSCAN密度聚类
1. 密度聚类概念 DBSCAN(Density-Based Spatial Clustering of Applications with Noise,具有噪声的基于密度的聚类方法)是一种很典型的密 ...
- DBSCAN聚类︱scikit-learn中一种基于密度的聚类方式
一.DBSCAN聚类概述 基于密度的方法的特点是不依赖于距离,而是依赖于密度,从而克服基于距离的算法只能发现"球形"聚簇的缺点. DBSCAN的核心思想是从某个核心点出发,不断向密 ...
- (数据科学学习手札15)DBSCAN密度聚类法原理简介&Python与R的实现
DBSCAN算法是一种很典型的密度聚类法,它与K-means等只能对凸样本集进行聚类的算法不同,它也可以处理非凸集. 关于DBSCAN算法的原理,笔者觉得下面这篇写的甚是清楚练达,推荐大家阅读: ht ...
- 【转】DBSCAN密度聚类算法
DBSCAN(Density-Based Spatial Clustering of Applications with Noise,具有噪声的基于密度的聚类方法)是一种很典型的密度聚类算法,和K-M ...
- 31(1).密度聚类---DBSCAN算法
密度聚类density-based clustering假设聚类结构能够通过样本分布的紧密程度确定. 密度聚类算法从样本的密度的角度来考察样本之间的可连接性,并基于可连接样本的不断扩张聚类簇,从而获得 ...
- 吴裕雄 python 机器学习——密度聚类DBSCAN模型
import numpy as np import matplotlib.pyplot as plt from sklearn import cluster from sklearn.metrics ...
- 密度聚类 - DBSCAN算法
参考资料:python机器学习库sklearn——DBSCAN密度聚类, Python实现DBScan import numpy as np from sklearn.cluster impo ...
随机推荐
- JDBC工具包commons-dbutils的基本介绍
感谢原文作者:simonXi-tech 原文链接:https://blog.csdn.net/simonforfuture/article/details/90480147 更多请查阅在线API文档: ...
- 为CentOS 6、7升级gcc至4.8、4.9、5.2、6.3、7.3等高版本
CentOS 7虽然已经出了很多年了,但依然会有很多人选择安装CentOS 6,CentOS 6有些依赖包和软件都比较老旧,如今天的主角gcc编译器,CentOS 6的gcc版本为4.4,CentOS ...
- js 计算中英文混合字符串长度
转载请注明来源:https://www.cnblogs.com/hookjc/ function isChinese(str) { var lst = /[u00-uFF]/; ...
- 什么是Autolayout
Autolayout是一种"自动布局"技术,专门用来布局UI界面的 Autolayout自iOS 6开始引入,由于Xcode 4的不给力,当时并没有得到很大推广 自iOS 7(Xc ...
- Mybatis foreach的用法
本文援引:https://www.cnblogs.com/fnlingnzb-learner/p/10566452.html 在做mybatis的mapper.xml文件的时候,我们时常用到这样的情况 ...
- Spring中事务管理的两种方式
spring支持编程式事务管理和声明式事务管理两种方式. 编程式事务管理使用TransactionTemplate或者直接使用底层的PlatformTransactionManager.对于编程式事务 ...
- 一张图让你看懂 iPhone 各种分辨率问题! #DF
话不多说,直接看图! Source: paintcodeapp.com
- 2021江西省赛线下赛赛后总结(Crypto)
2021江西省赛线下赛 crypto1 题目: from random import randint from gmpy2 import * from Crypto.Util.number impor ...
- 同事提出个我从未想过的问题,为什么Kubernetes要"多此一举"推出静态Pod概念?
同事提出个我从未想过的问题,为什么Kubernetes要"多此一举"推出静态Pod概念? 我们知道k8s中Pod可以说是一个合格的容器小管家,Pod 被设计成支持多个容器可以一起进 ...
- 图计算 on nLive:Nebula 的图计算实践
本文首发于 Nebula Graph Community 公众号 在 #图计算 on nLive# 直播活动中,来自 Nebula 研发团队的 nebula-plato 维护者郝彤和 nebula-a ...