
2019-02-08 Python学习之Scrapy的简单了解
今天遇到的问题和昨天差不多,一个Scrapy装了好久,anaconda卸了又装,pycharm卸了又装,环境变量配置一堆,依赖包下载一堆。查了一堆资料总算是搞好了。
Scripy:
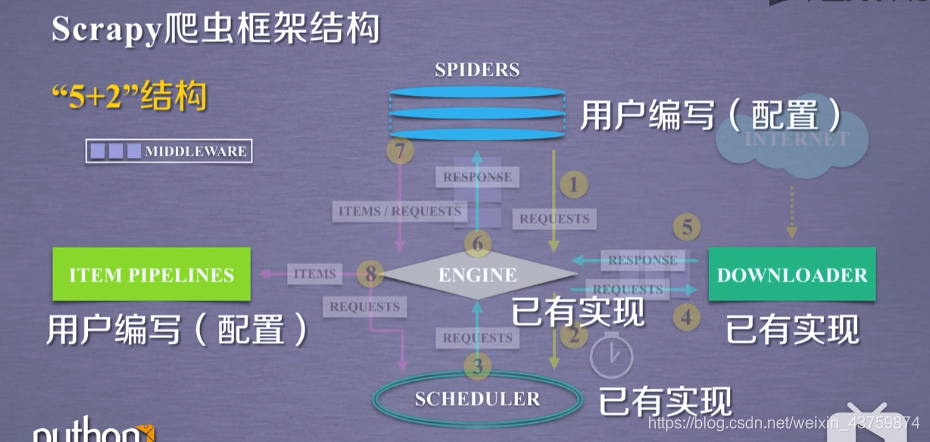
先放个框架结构图(来自嵩天老师mooc)
Scrapy 爬虫的使用步骤
- 创建一个工程和spider模板
- 编写spider
- 编写Item Pipeline
- 优化配置策略
两种风格的demospider写法:
class DemoSpider(scrapy.Spider):

    name = 'demo'

    #allowed_domains = ['python123.io']

    start_urls = ['http://python123.io/ws/demo.html']	#启动时最开始的链接

    def parse(self, response):			#解析和操作的相关步骤

    	fname = response.url.split('/')[-1]		#文件名叫demo.html(切片,得到最后一个)

    	with open(fname,'wb+') as f:

    		f.write(response.body)

    	self.log = ('saved file %s.'% fname)
class DemoSpider(scrapy.Spider):

	name = "demo"

	def start_requests(self):

		urls = [

				'http://python123.io/ws/demo.html'

				]

		for url in urls:

			yield scrapy.Request(url=url,callback=self.parse)

	def parse(self,response):

		fname = response.url.split('/')[-1]

		with open(fname,'wb') as f:

			f.write(response.body)

		self.log('Save file %s.' % fname)
几种类:
Request类
class scrapy.http.Request()
- Request对象生成一个HTTP请求
- 由Spider生成,由Downloader执行
属性和方法
.url 对应请求的url地址
.method 请求方法
.headers 字典类型风格的请求头
.body 请求内容主题
.meta 用户添加的扩展信息
.copy() 复制该响应
Response类
class scrapy.http.Request()
- Response对象表示一个http响应
- 由downloader生成,spider来处理
属性和方法
.urls Response对应的url地址
.status HTTP状态码
.headers Response对应的头部信息
.body Response对应的内容信息
.flags 一组标记
.request 产生Response类型对应的Request对象
.copy() 复制该响应
Item类
class scrapy.item.Item()
- Item对象表示一个从HTML页面中提取的信息内容
- 由Spider生成,由Item Pipeline进行处理
- Item类似字典类型,可以按照字典类型进行相关操作\
Scrapy爬虫提取信息的方法
BeautifulSoup
lxml
re
CSS selector
XPath selector
2019-02-08 Python学习之Scrapy的简单了解的更多相关文章
- 08 python学习笔记-随机生成大乐透号码(八)
1 #产生大乐透号码 2 #前区 1-32,5 后区 1-12,2 3 #1.前区从1-32中级取5个,后区再从1-12里面取2个 4 #01 02 03 04 5 def dlt(): #生成随机大 ...
- CF-1110 (2019/02/08)
CF-1110 A. Parity 快速幂的思想,考虑最后一位即可 #include <bits/stdc++.h> using namespace std; typedef long l ...
- python学习笔记(3)--turtle简单绘制
参考:大学生mooc 北京理工大学的python程序与设计课程 蟒蛇绘制代码如下: #pythonDraw.py import turtle turtle.setup(650,350,200,200) ...
- python学习笔记(excel简单操作)
现在的目标是设计一个接口自动化测试框架 用例写在excel里面 利用python自带的pyunit构建 之前已经安装好了处理excel的模块 这次简单的使用下 提前创建好excel文件 “testca ...
- Python学习笔记3:简单文件操作
# -*- coding: cp936 -*- # 1 打开文件 # open(fileName, mode) # 參数:fileName文件名称 # mode打开方式 # w 以写方式打开. ...
- Python学习-字典练习:简单通讯录
功能要求: 查询联系人,输入姓名,可以查询当前通讯录里面的联系人信息,若联系人存在,则输出联系人信息,若不存在,则告知 插入联系人,可以向通讯录中新建联系人,若联系人已经存在,则询问是否修改联系人信息 ...
- python 学习分享-实战篇简单的ftp
import socket import os import time import pickle Basedb = os.path.dirname(os.path.dirname(os.path.a ...
- VS2013中Python学习笔记[Django Web的第一个网页]
前言 前面我简单介绍了Python的Hello World.看到有人问我搞搞Python的Web,一时兴起,就来试试看. 第一篇 VS2013中Python学习笔记[环境搭建] 简单介绍Python环 ...
- Python学习基础笔记(全)
换博客了,还是csdn好一些. Python学习基础笔记 1.Python学习-linux下Python3的安装 2.Python学习-数据类型.运算符.条件语句 3.Python学习-循环语句 4. ...
随机推荐
- Linux退出vi编辑
按ESC键 跳出vi的编辑命令,然后: :w 保存文件但不退出vi:w file 将修改另外保存到file中,不退出vi:w! 强制保存,不推出vi:wq 保存文件并退出vi:wq! 强制保存文件,并 ...
- vue-cli中的index.html ,main.js , App.vue的关系
###发现不少小伙伴才刚开始接触到这个结构都被绕的迷糊,而发现很多人说的也不是那么准确,那么下面我来说一下是怎么回事### 1.首先我们来看看原生Vue中组件的写法, 我们按照vue-cli的结构按照 ...
- Thinkphp5 post提交模糊查询带分页如何保留参数
最近做了一个分页的模糊查询post请求,发现查出来的分页点击下一页导致所有的搜索条件被重置,分页效果就失效了. 以下是网上部分解决办法: 控制器代码 public function index($na ...
- MongoDB全球云端技术盛会MongoDB.live
MongoDB全球云端技术盛会MongoDB.live,将于北京时间6月9日22:00正式开启,大会将以在线直播+按需学习相结合的方式,面向全球开发者.架构师等MongoDB 用户和爱好者免费开放,精 ...
- KVM的常用操作
KVM安装 一.网卡桥接 1.在原网卡上注释掉IP配置,添加一下内容 BRIDGE=br0 2.配置桥接网卡地址 vim ifcfg-br0 DEVICE="br0" NM_CON ...
- 【HTTP】Web服务器和HTTP的协作&HTTP首部
用单台虚拟主机实现多个域名 Web服务器可以搭建多个独立域名的Web网站,也可以作为通信路径上的中转服务器提升效率. HTTP/1.1规范允许一台HTTP服务器搭建多个Web站点,提供Web托管服务的 ...
- 微信小程序初探--写个扫雷分享给你玩
闲暇里,想学一下微信小程序, 于是,用微信小程序原生做了个扫雷玩. 以下略作总结,分享给大家. 微信里下拉,输入[mini计算器], 看到这个图标的就是了: 说好的扫雷,怎么变成计算器了?原因后面解释 ...
- Android_基础之分辨率
常见屏幕分辨率对应尺寸 标屏 分辨率 比例 宽屏 分辨率 比例 QCIF 176X144 11:9 CIF 352X288 11:9 QVGA 320X240 4:3 WQVG ...
- Java之预定义
作为Java初学者的我,提供一个类似C#的预处理机制.若有不足之处,敬请各位大佬指正(感觉没有,哈哈哈哈哈哈)! Java 没有类似 C++的宏,也没有类似C#的预定义 #if...#endif C# ...
- Map接口之HashMap,LinkedHashMap,TreeMap
Map与Collection 并列存在,用于保存具有映射关系的数据:Key-Value Map中的Key和Value都可以是任何引用类型的数据 Map中的Key用Set存放,不允许重复,即同一个Map ...