
spark踩坑--WARN ProcfsMetricsGetter: Exception when trying to compute pagesize的最全解法
spark踩坑--WARN ProcfsMetricsGetter: Exception when trying to compute pagesize的最全解法
问题描述
大概是今年上半年的时候装了spark(windows环境/spark-3.0.0-preview2/hadoop2.7),装完环境之后就一直没管,今天用的时候出现了这个错误:
20/12/17 12:06:34 ERROR Shell: Failed to locate the winutils binary in the hadoop binary path

java.io.IOException: Could not locate executable null\bin\winutils.exe in the Hadoop binaries.

        at org.apache.hadoop.util.Shell.getQualifiedBinPath(Shell.java:382)

        at org.apache.hadoop.util.Shell.getWinUtilsPath(Shell.java:397)

        at org.apache.hadoop.util.Shell.<clinit>(Shell.java:390)

        at org.apache.hadoop.util.StringUtils.<clinit>(StringUtils.java:80)

        at org.apache.hadoop.security.SecurityUtil.getAuthenticationMethod(SecurityUtil.java:611)

        at org.apache.hadoop.security.UserGroupInformation.initialize(UserGroupInformation.java:274)

        at org.apache.hadoop.security.UserGroupInformation.ensureInitialized(UserGroupInformation.java:262)

        at org.apache.hadoop.security.UserGroupInformation.loginUserFromSubject(UserGroupInformation.java:807)

        at org.apache.hadoop.security.UserGroupInformation.getLoginUser(UserGroupInformation.java:777)

        at org.apache.hadoop.security.UserGroupInformation.getCurrentUser(UserGroupInformation.java:650)

        at org.apache.spark.util.Utils$.$anonfun$getCurrentUserName$1(Utils.scala:2412)

        at scala.Option.getOrElse(Option.scala:189)

        at org.apache.spark.util.Utils$.getCurrentUserName(Utils.scala:2412)

        at org.apache.spark.SecurityManager.<init>(SecurityManager.scala:79)

        at org.apache.spark.deploy.SparkSubmit.secMgr$lzycompute$1(SparkSubmit.scala:368)

        at org.apache.spark.deploy.SparkSubmit.secMgr$1(SparkSubmit.scala:368)

        at org.apache.spark.deploy.SparkSubmit.$anonfun$prepareSubmitEnvironment$8(SparkSubmit.scala:376)

        at scala.Option.map(Option.scala:230)

        at org.apache.spark.deploy.SparkSubmit.prepareSubmitEnvironment(SparkSubmit.scala:376)

        at org.apache.spark.deploy.SparkSubmit.org$apache$spark$deploy$SparkSubmit$$runMain(SparkSubmit.scala:871)

        at org.apache.spark.deploy.SparkSubmit.doRunMain$1(SparkSubmit.scala:180)

        at org.apache.spark.deploy.SparkSubmit.submit(SparkSubmit.scala:203)

        at org.apache.spark.deploy.SparkSubmit.doSubmit(SparkSubmit.scala:90)

        at org.apache.spark.deploy.SparkSubmit$$anon$2.doSubmit(SparkSubmit.scala:1007)

        at org.apache.spark.deploy.SparkSubmit$.main(SparkSubmit.scala:1016)

        at org.apache.spark.deploy.SparkSubmit.main(SparkSubmit.scala)

20/12/17 12:06:34 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable

Using Spark's default log4j profile: org/apache/spark/log4j-defaults.properties

Setting default log level to "WARN".

To adjust logging level use sc.setLogLevel(newLevel). For SparkR, use setLogLevel(newLevel).

Spark context Web UI available at http://LAPTOP-G0A3PQME:4040

Spark context available as 'sc' (master = local[*], app id = local-1608178002520).

Spark session available as 'spark'.

Welcome to

      ____              __

     / __/__  ___ _____/ /__

    _\ \/ _ \/ _ `/ __/  '_/

   /___/ .__/\_,_/_/ /_/\_\   version 3.0.0-preview2

      /_/

Using Scala version 2.12.10 (Java HotSpot(TM) 64-Bit Server VM, Java 1.8.0_211)

Type in expressions to have them evaluated.

Type :help for more information.

scala> 20/12/17 12:06:59 WARN ProcfsMetricsGetter: Exception when trying to compute pagesize, as a result reporting of ProcessTree metrics is stopped
WARN ProcfsMetricsGetter: Exception when trying to compute pagesize, as a result reporting of ProcessTree metrics is stopped,跳出了warn之后进入了阻塞状态,只能ctrlc关闭。试了一圈别人总结的方法,发现都没有解决,所以把我的方法总结在下面:
解决方法
1 建议首先先检查下pyspark和scala
我回忆了一下,可能是因为上半年我重新配了一遍各种环境,所以导致了问题。命令行看一下
scala -version
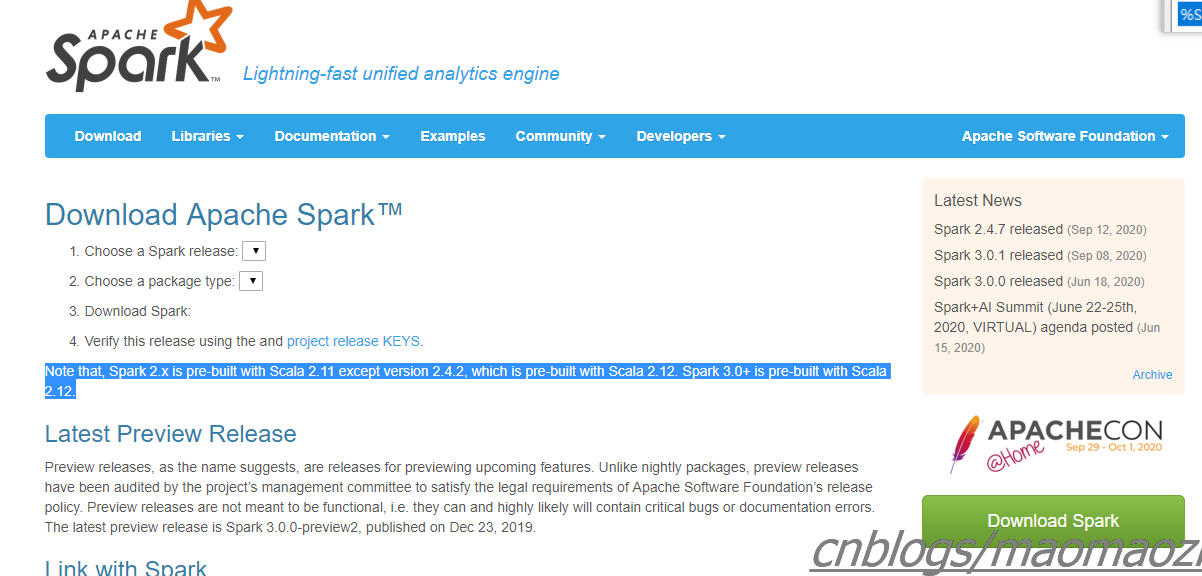
检查pyspark已经下载,检查scala已经安装并且版本合适。(不同版本的spark对于hadoop和scala有要求,官网上有介绍,比如下图)
在我重新安装了scala之后,已经不会再进入阻塞状态,可以正常输入了,大概是这个样子:
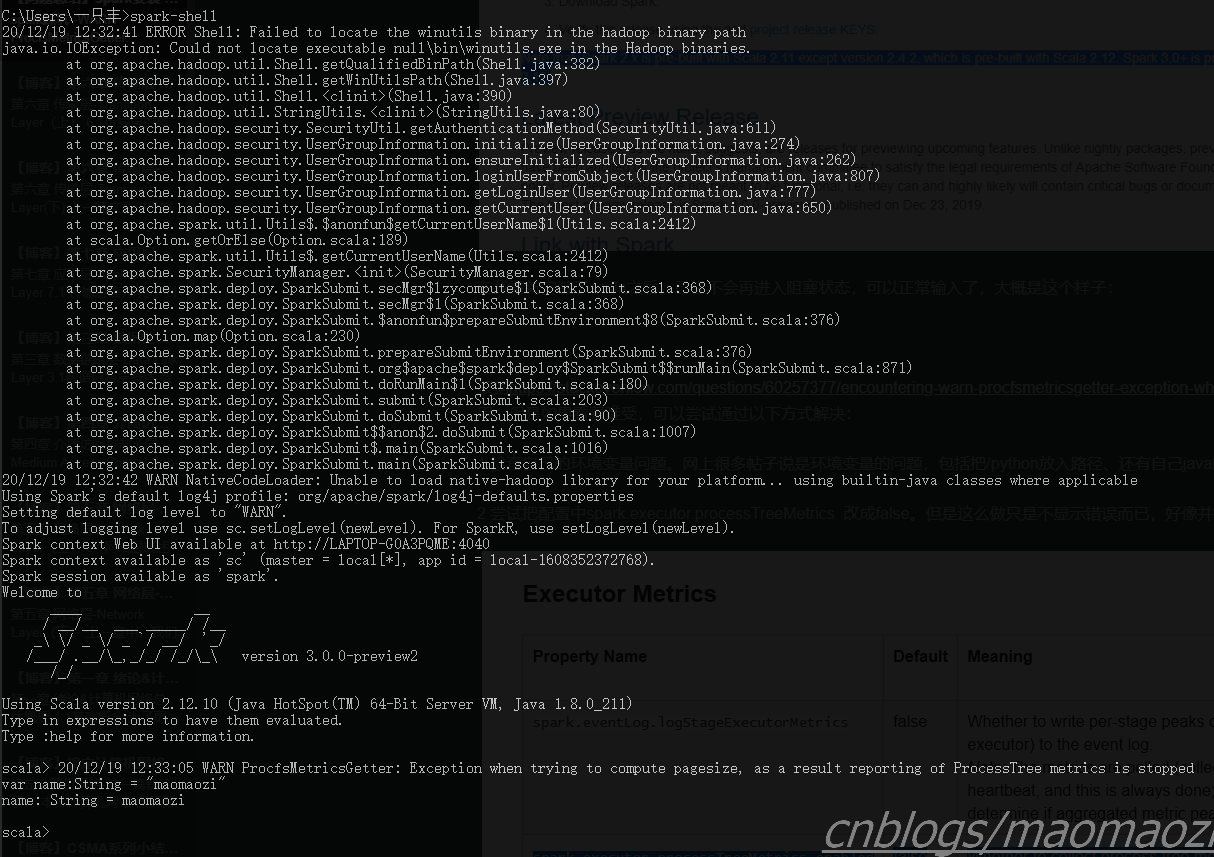
这个时候应该就可以正常使用了,到目前为止我也没有遇到什么明显的问题。且根据https://stackoverflow.com/questions/60257377/encountering-warn-procfsmetricsgetter-exception-when-trying-to-compute-pagesi,这个WARN本身应该不影响正常使用。但是如果看着难受,也可以尝试通过以下方式解决:
2 检查自己的环境变量问题
网上很多帖子说是环境变量的问题,包括把%SPARK_HOME%\python放入路径、还有自己java的路径没写对、以及/bin和/sbin(我尝试了还是没有解决,但读者们还是可以试一下)
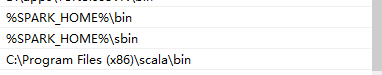
注意都放到系统变量里面。
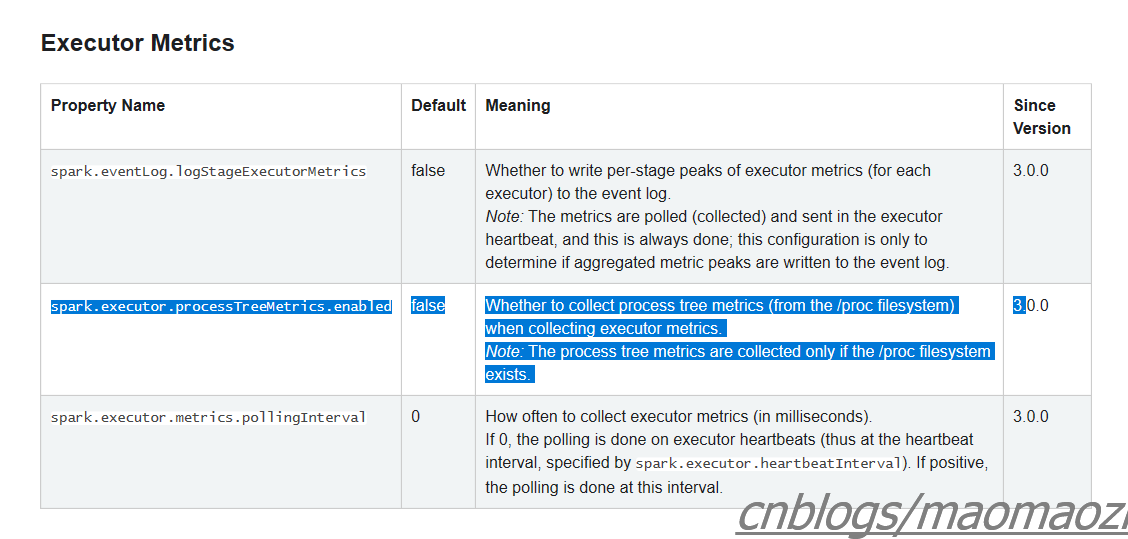
3 把配置中spark.executor.processTreeMetrics 改成false
去git上看了一下这个错误位置,应该是这个地方抛出的:
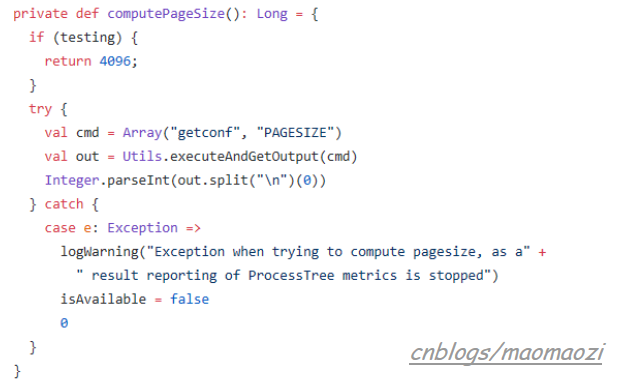
所以把配置中spark.executor.processTreeMetrics 改成false应该就可以了,但是这么做大概相当于屏蔽掉问题。我看了一下目前网上的相似问题,能查到的基本都是spark3.0才才会出现的问题。并且根据apache发的公告来说,这是一个3.0版本后才发布的改动(https://spark.apache.org/docs/3.0.1/configuration.html)。当把这个改成true的时候,spark可以高频率的收集执行指标。(if spark.executor.processTreeMetrics.enabled=true; The optional configuration spark.executor.metrics.pollingInterval allows to gather executor metrics at high frequency, see doc. )
4 如果还是不行,换一个旧点的版本。
因为是3.0.0才发布的改动,如果还是不行的话应该只能换个旧一点的版本了(比如2.4.6)。如果不是企业级开发的话,也不会有太大问题。毕竟spark配置也不算很繁琐。
内容参考
https://www.aws-senior.com/apache-spark-3-0-memory-monitoring-improvements/
https://blog.csdn.net/qq_36888550/article/details/106971949
spark踩坑--WARN ProcfsMetricsGetter: Exception when trying to compute pagesize的最全解法的更多相关文章
- Spark踩坑记——Spark Streaming+Kafka
[TOC] 前言 在WeTest舆情项目中,需要对每天千万级的游戏评论信息进行词频统计,在生产者一端,我们将数据按照每天的拉取时间存入了Kafka当中,而在消费者一端,我们利用了spark strea ...
- Spark踩坑记——数据库(Hbase+Mysql)
[TOC] 前言 在使用Spark Streaming的过程中对于计算产生结果的进行持久化时,我们往往需要操作数据库,去统计或者改变一些值.最近一个实时消费者处理任务,在使用spark streami ...
- Spark踩坑记——从RDD看集群调度
[TOC] 前言 在Spark的使用中,性能的调优配置过程中,查阅了很多资料,之前自己总结过两篇小博文Spark踩坑记--初试和Spark踩坑记--数据库(Hbase+Mysql),第一篇概况的归纳了 ...
- [转]Spark 踩坑记:数据库(Hbase+Mysql)
https://cloud.tencent.com/developer/article/1004820 Spark 踩坑记:数据库(Hbase+Mysql) 前言 在使用Spark Streaming ...
- Spark踩坑记——数据库(Hbase+Mysql)转
转自:http://www.cnblogs.com/xlturing/p/spark.html 前言 在使用Spark Streaming的过程中对于计算产生结果的进行持久化时,我们往往需要操作数据库 ...
- Spark踩坑记:Spark Streaming+kafka应用及调优
前言 在WeTest舆情项目中,需要对每天千万级的游戏评论信息进行词频统计,在生产者一端,我们将数据按照每天的拉取时间存入了Kafka当中,而在消费者一端,我们利用了spark streaming从k ...
- Spark踩坑记——共享变量
[TOC] 前言 Spark踩坑记--初试 Spark踩坑记--数据库(Hbase+Mysql) Spark踩坑记--Spark Streaming+kafka应用及调优 在前面总结的几篇spark踩 ...
- Spark踩坑记:共享变量
收录待用,修改转载已取得腾讯云授权 前言 前面总结的几篇spark踩坑博文中,我总结了自己在使用spark过程当中踩过的一些坑和经验.我们知道Spark是多机器集群部署的,分为Driver/Maste ...
- Spark踩坑填坑-聚合函数-序列化异常
Spark踩坑填坑-聚合函数-序列化异常 一.Spark聚合函数特殊场景 二.spark sql group by 三.Spark Caused by: java.io.NotSerializable ...
随机推荐
- ABBYY FineReader添加盖章戳记
PDF编辑器允许您如同在纸质文档上盖章一样在 PDF 文档上添加戳记.您可以从可用的戳记列表中选择戳记或者创建自己的戳记,然后添加任何所需的文本.戳记日期和时间或者图像. 如果要在页面上加上戳记,可以 ...
- ABBYY FineReader 15扫描和保存文档详解
通过使用ABBYY FineReader 15 OCR文字识别软件的扫描和保存文档功能,用户可使用扫描仪或数码照相机获得图像文档,然后再转换为各种数字格式文档. 在"新任务窗口"中 ...
- Mac读写ntfs软件究竟哪一款适合我们?
生活中我们免不了会使用一些硬盘设备来存储文件或者是数据,然而绝大多数的移动硬盘都是ntfs格式.Mac读写ntfs软件有很多,究竟哪一款适合我们? 首先,我们一起了解一下什么是ntfs格式.ntfs, ...
- Java8常用的内置函数式接口(一)Predicate、Consumer、Supplier、Function
Java8常用的内置函数式接口(一) 简介 JDK 1.8 API中包含了很多内置的函数式接口.有些是在以前版本的Java中大家耳熟能详的,例如Comparator接口,或者Runnable接口.对这 ...
- selenium调用JS实现自动化
webdriver自带的api使用起来有局限性,比如下拉滚动条文本框输入,以及一些弹出框的操作,使用JS直接操作方便又灵活. 一:示例 from selenium import webdriver f ...
- 聊聊kafka-client的源码
一,感想 kafka 客户端代码很早以前 我就想研究借鉴一下,我前前后后至少阅读过三遍源码,我发现我看不下去,不知道为啥这么写,在次期间,我也参考了很多的网上的源码分析,我发现自己依然一知半解的, 慢 ...
- Codeforces Round #656 (Div. 3) 题解
A. Three Pairwise Maximums #构造 题目链接 题意 给定三个正整数\(x,y,z\),要求找出正整数\(a,b,c\),满足\(x=max(a,b), y=max(a,c), ...
- 单例模式与它的七种java实现方式
定义 单例模式是一个比较简单的模式,其定义如下: 确保某一个类只有一个实例,而且自行实例化,并向整个系统提供这个实力. 优点: 1.由于单例模式在内存中只有一个实例,减少了内存开支,特别是一个对象需要 ...
- python将对象写入文件,以及从文件中读取对象
原文地址: http://www.voidcn.com/article/p-fqtqpwxp-wo.html 写入文件代码: >>> import sys, shelve >& ...
- Django的路由分发与名称空间
路由分发 django每一个app下面都可以有自己的urls.py路由层,templates文件夹,static文件夹 项目名下urls.py(总路由)不再做路由与视图函数的匹配关系而是做路由的分发 ...