
Scrapy案例02-腾讯招聘信息爬取
1. 目标
目标:https://hr.tencent.com/position.php?&start=0#a
爬取所有的职位信息信息
- 职位名
- 职位url
- 职位类型
- 职位人数
- 工作地点
- 发布时间
2. 网站结构分析
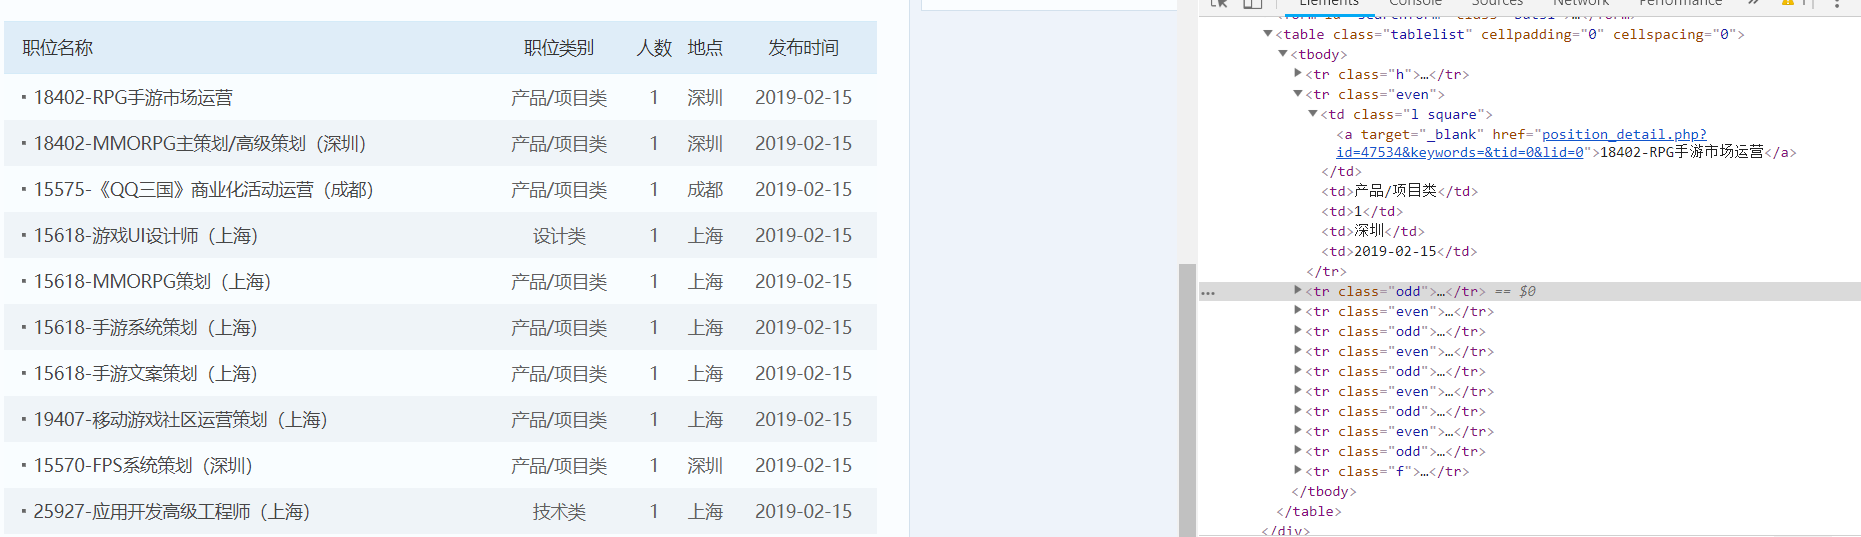
3. 编写爬虫程序
3.1. 配置需要爬取的目标变量
class TecentjobItem(scrapy.Item):

    # define the fields for your item here like:

    positionname = scrapy.Field()

    positionlink = scrapy.Field()

    positionType = scrapy.Field()

    peopleNum = scrapy.Field()

    workLocation = scrapy.Field()

    publishTime = scrapy.Field()
3.2. 写爬虫文件scrapy
# -*- coding: utf-8 -*-

import scrapy

from tecentJob.items import TecentjobItem

class TencentSpider(scrapy.Spider):

    name = 'tencent'

    allowed_domains = ['tencent.com']

    url = 'https://hr.tencent.com/position.php?&start='

    offset = 0

    start_urls = [url + str(offset)]

    def parse(self, response):

        for each in response.xpath("//tr[@class = 'even'] | //tr[@class = 'odd']"):

            # 初始化模型对象

            item = TecentjobItem()

            item['positionname'] = each.xpath("./td[1]/a/text()").extract()[0]

            item['positionlink'] = each.xpath("./td[1]/a/@href").extract()[0]

            item['positionType'] = each.xpath("./td[2]/text()").extract()[0]

            item['peopleNum'] = each.xpath("./td[3]/text()").extract()[0]

            item['workLocation'] = each.xpath("./td[4]/text()").extract()[0]

            item['publishTime'] = each.xpath("./td[5]/text()").extract()[0]

            yield item

        if self.offset < 100:

            self.offset += 10

        # 将请求重写发送给调度器入队列、出队列、交给下载器下载

        # 拼接新的rurl,并回调parse函数处理response

        # yield scrapy.Request(url, callback = self.parse)

        yield scrapy.Request(self.url + str(self.offset), callback=self.parse)
3.3. 编写yield需要的管道文件
import json

class TecentjobPipeline(object):

    def __init__(self):

        self.filename = open("tencent.json", 'wb')

    def process_item(self, item, spider):

        text = json.dumps(dict(item),ensure_ascii=False) + "\n"

        self.filename.write(text.encode('utf-8'))

        return item

    def close_spider(self, spider):

        self.filename.close()
3.4. setting中配置请求抱头信息
DEFAULT_REQUEST_HEADERS = {

  'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/71.0.3578.98 Safari/537.36',

  'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8',

  'Accept-Language': 'en',

}
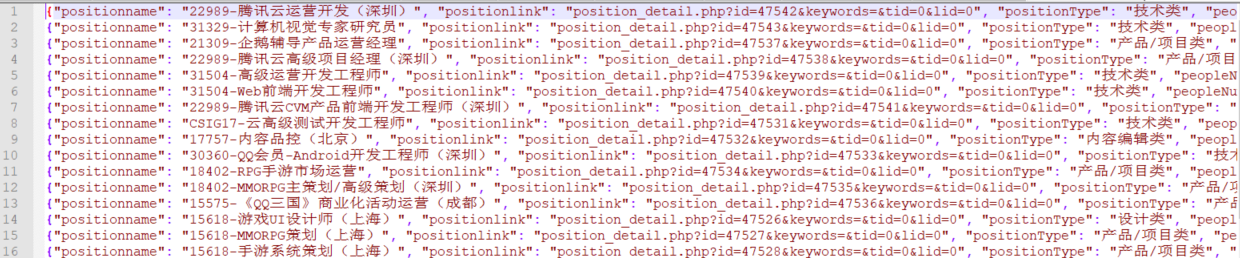
4. 最后结果
Scrapy案例02-腾讯招聘信息爬取的更多相关文章
- Scrapy项目 - 实现腾讯网站社会招聘信息爬取的爬虫设计
通过使Scrapy框架,进行数据挖掘和对web站点页面提取结构化数据,掌握如何使用Twisted异步网络框架来处理网络通讯的问题,可以加快我们的下载速度,也可深入接触各种中间件接口,灵活的完成各种需求 ...
- Scrapy项目 - 数据简析 - 实现腾讯网站社会招聘信息爬取的爬虫设计
一.数据分析截图 本例实验,使用Weka 3.7对腾讯招聘官网中网页上所罗列的招聘信息,如:其中的职位名称.链接.职位类别.人数.地点和发布时间等信息进行数据分析,详见如下图: 图1-1 Weka ...
- Python 招聘信息爬取及可视化
自学python的大四狗发现校招招python的屈指可数,全是C++.Java.PHP,但看了下社招岗位还是有的.于是为了更加确定有多少可能找到工作,就用python写了个爬虫爬取招聘信息,数据处理, ...
- Scrapy项目 - 实现豆瓣 Top250 电影信息爬取的爬虫设计
通过使Scrapy框架,掌握如何使用Twisted异步网络框架来处理网络通讯的问题,进行数据挖掘和对web站点页面提取结构化数据,可以加快我们的下载速度,也可深入接触各种中间件接口,灵活的完成各种需求 ...
- Scrapy项目 - 实现斗鱼直播网站信息爬取的爬虫设计
要求编写的程序可爬取斗鱼直播网站上的直播信息,如:房间数,直播类别和人气等.熟悉掌握基本的网页和url分析,同时能灵活使用Xmind工具对Python爬虫程序(网络爬虫)流程图进行分析. 一.项目 ...
- Scrapy项目 - 项目源码 - 实现腾讯网站社会招聘信息爬取的爬虫设计
1.tencentSpider.py # -*- coding: utf-8 -*- import scrapy from Tencent.items import TencentItem #创建爬虫 ...
- Python爬虫框架Scrapy获得定向打击批量招聘信息
爬虫,就是一个在网上到处或定向抓取数据的程序,当然,这样的说法不够专业,更专业的描写叙述就是.抓取特定站点网页的HTML数据.只是因为一个站点的网页非常多,而我们又不可能事先知道全部网页的URL地址, ...
- 安居客scrapy房产信息爬取到数据可视化(下)-可视化代码
接上篇:安居客scrapy房产信息爬取到数据可视化(下)-可视化代码,可视化的实现~ 先看看保存的数据吧~ 本人之前都是习惯把爬到的数据保存到本地json文件, 这次保存到数据库后发现使用mongod ...
- scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250
scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250 前言 经过上一篇教程我们已经大致了解了Scrapy的基本情况,并写了一个简单的小demo.这次我会以爬取豆瓣电影TOP250为例进一步为大 ...
随机推荐
- nginx: [emerg] the "ssl" parameter requires ngx_http_ssl_module in ......
nginx如果未开启SSL模块,配置https时提示错误 nginx: [emerg] the "ssl" parameter requires ngx_http_ssl_modu ...
- CentOS 7 安装 Jenkins
准备工作 首选需要安装JAVA环境 https://www.cnblogs.com/stulzq/p/9286878.html 如果你的系统没有自带git,那么也需要安装一个 yum install ...
- 探索ASP.NET Core中的IStartupFilter
原文:Exploring IStartupFilter in ASP.NET Core 作者:Andrew Lock 译者:Lamond Lu 在本篇博客中,我将介绍一下IStartupFilter, ...
- SQL数据库连接语句
一般的远程访问的写成这样: Data Source=IP ;Initial Catalog=数据库名 ;UserID= 用户名 ;Password=密码 本地访问的写成这样: Data Source= ...
- Linux下 Vim(Vi)编辑器的使用
vi编辑器 vi是UNIX和类UNIX环境下的可用于创建文件的屏幕编辑器.vi有两种工作模式:命令模式和文本输入模式.启动vi需要输入vi,按[Spacebar]键并输入文件名后回车. 切换模式键 v ...
- ubuntu 修改网卡名称 更改设备网卡名称 修改eno16777736为eth0 ubuntu 15.10网卡名称为eno16777736
ubuntu linux 进入root用户,管理员模式 编辑这个文件需要管理员模式 在GRUB_CMD_LINUX后面增加图中所示 看到这个地方了没,有提示信息的,想要改变这个文件,记得运行 upda ...
- SpringMVC中@Controller和@RequestMapping用法和其他常用注解
一.简介 在SpringMVC 中,控制器Controller 负责处理由DispatcherServlet 分发的请求,它把用户请求的数据经过业务处理层处理之后封装成一个Model ,然后再把该Mo ...
- 利用BGP虚拟下一跳实现链路负载均衡
最近针对BGP链路负载均衡方案“虚拟下一跳”进行了总结,现将总结的PPT贴上来.
- Linux之安装常用软件
Linux下安装软件的方法: 1,rpm(不推荐使用) 2,yum安装(使用快捷方便) 3,编译安装 一.安装python3(这里使用的是编译安装) 1,下载python3源码包 在centos下,第 ...
- linux 内核的优化
修改下面的这些参数,如果没有的话.直接复制进去就可以了 vim /etc/sysctl.conf 参数修改 vm.swappiness = net.ipv4.neigh. net.ipv4.conf. ...